01 Kenapa ini lambat?
Pertanyaan yang sama diajukan ke BigQuery dan, nanti, ke ClickHouse -- dua jawaban yang sudah diukur sebelumnya, belum ada penjelasan, dan pernyataan lugas soal di mana BigQuery memang menang.
Satu dataset, dua tempat
Workshop ini memindahkan dataset sample e-commerce GA4 yang diobfuskasi -- dataset yang sama yang menjadi dasar tutorial public-data BigQuery sendiri -- dari BigQuery ke ClickHouse. Sebelum Anda menyentuh salah satu sistem, lihat dulu seberapa cepat BigQuery sendiri mengeksekusi query terhadap kopi publik data ini.
Kedua query di bawah berjalan terhadap bigquery-public-data.ga4_obfuscated_sample_ecommerce,
dataset publik yang belum disentuh. Anda tidak perlu proyek Google Cloud untuk melihat ini:
query terhadap BigQuery, meskipun terhadap dataset publik, tetap dibebankan ke proyek siapa
pun yang menjalankannya, sehingga instruktur Anda menjalankan kedua query ini secara live dan
tangkapan layar di bawah adalah job statistics asli dari konsolnya, bukan sekadar angka yang
dituliskan di bawahnya. Kopi yang akan Anda pakai untuk sisa workshop ini tinggal di GCS
bucket dan merupakan data yang sama, digeser lima tahun ke depan -- modul 02 membahas
pergeseran ini dan alasan mengapa aman untuk diabaikan untuk saat ini. user_pseudo_id tidak
digeser, sehingga user yang sama tetap ada secara identik di kedua kopi.
Lookup satu user
SELECT
  TIMESTAMP_MICROS(event_timestamp) AS event_time,
  event_name,
  geo.country                       AS geo_country
FROM `bigquery-public-data.ga4_obfuscated_sample_ecommerce.events_*`
WHERE user_pseudo_id = '3272961.4196485002'
ORDER BY event_time DESC
LIMIT 20;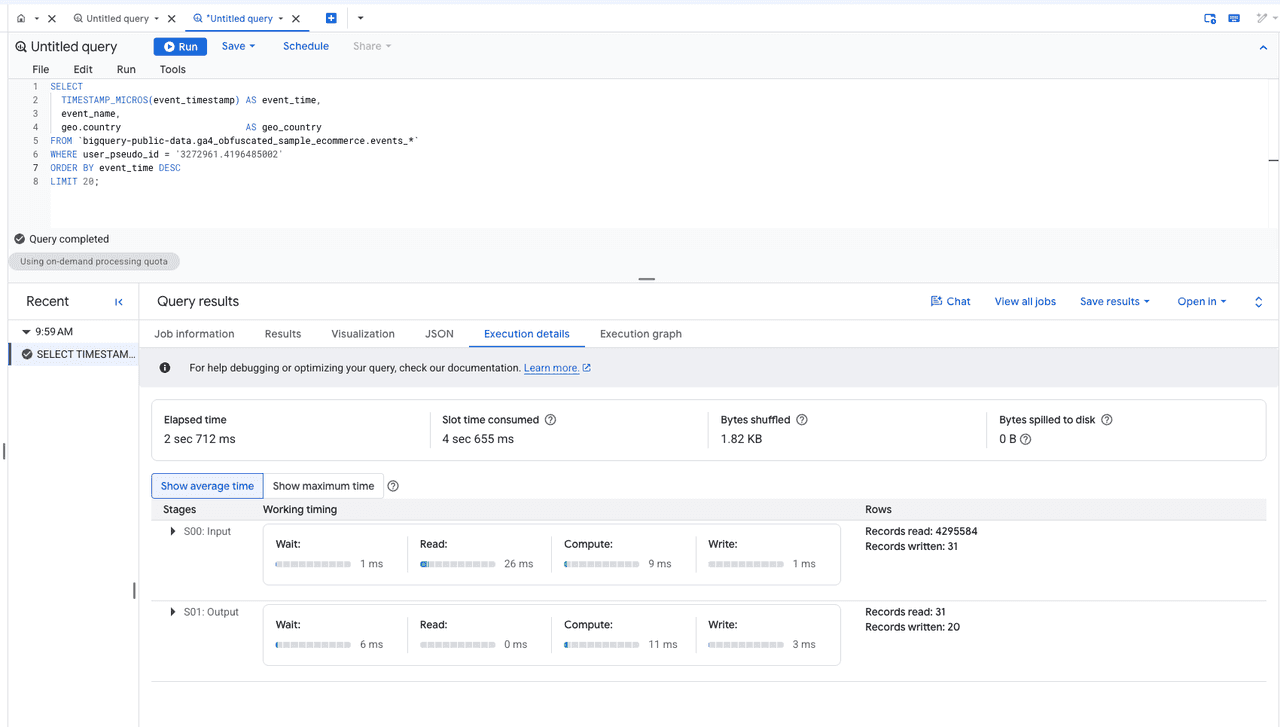
Execution details asli dari BigQuery untuk query di atas -- waktu elapsed dan, tahap demi tahap, berapa banyak record yang dibaca untuk menjawabnya -- dari run live, bukan diketik dari memori.
Ini kira-kira query paling menguntungkan yang bisa dilihat BigQuery: satu user, dua puluh
baris, satu LIMIT. Angka-angka di bawah adalah median dari tiga run, dibaca dari job
statistics BigQuery sendiri.
Agregat dashboard satu hari
SELECT
  TIMESTAMP_TRUNC(TIMESTAMP_MICROS(event_timestamp), MINUTE) AS minute,
  device.category                                            AS device_category,
  geo.country                                                AS geo_country,
  COUNTIF(event_name = 'view_item')                          AS views,
  COUNTIF(event_name = 'add_to_cart')                        AS carts,
  COUNTIF(event_name = 'begin_checkout')                     AS checkouts,
  COUNTIF(event_name = 'purchase')                           AS purchases,
  APPROX_COUNT_DISTINCT(user_pseudo_id)                      AS users,
  ROUND(SAFE_DIVIDE(COUNTIF(event_name = 'add_to_cart'), COUNTIF(event_name = 'view_item')), 4) AS cart_rate
FROM `bigquery-public-data.ga4_obfuscated_sample_ecommerce.events_*`
WHERE _TABLE_SUFFIX = '20201201'
GROUP BY minute, device_category, geo_country
ORDER BY minute DESC, device_category, geo_country;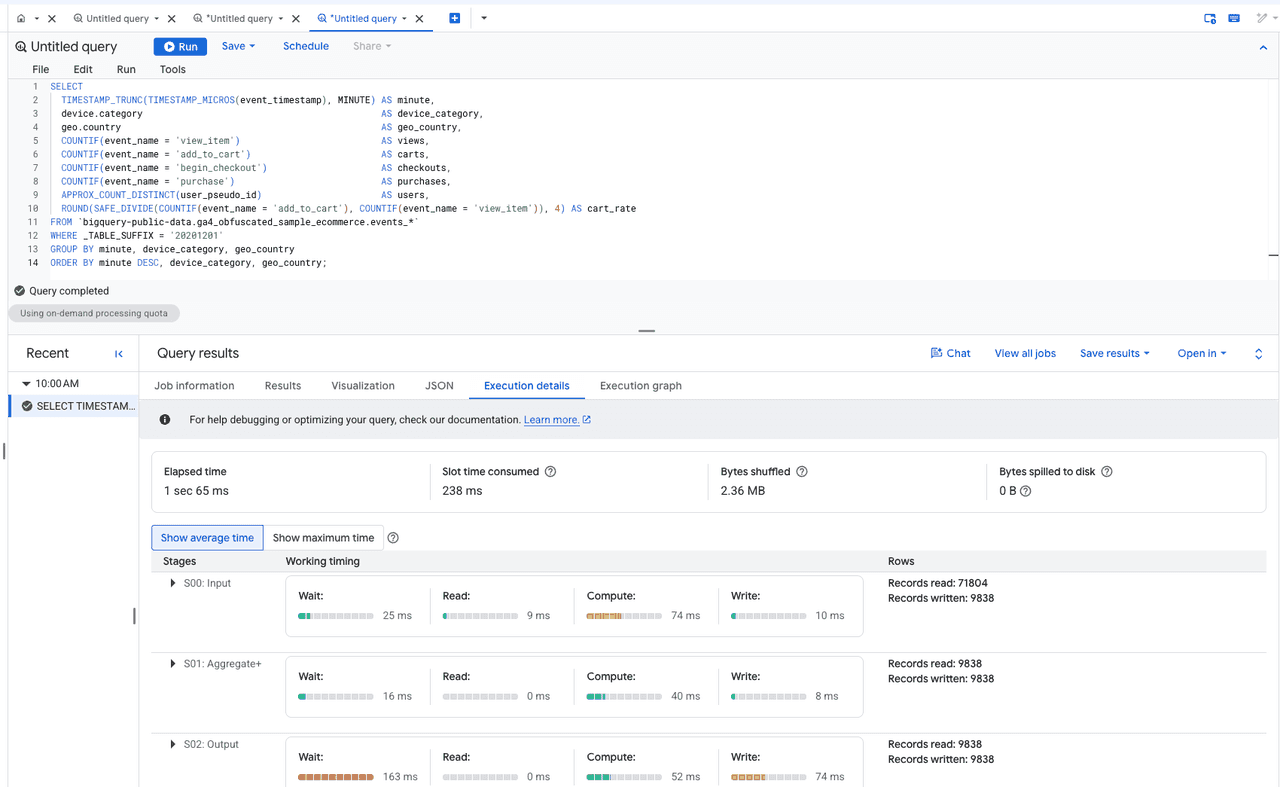
Execution details asli dari BigQuery untuk query di atas, dari run live yang sama.
Ini adalah funnel konversi per menit -- views, cart adds, checkouts, purchases, distinct
users -- dibatasi ke satu hari kalender, yang persis berbentuk seperti query yang dikirim
dashboard live pada setiap page load. Partitioning tabel harian BigQuery (_TABLE_SUFFIX)
melakukan pruning secara ketat di sini -- median dari tiga run:
Pertanyaan yang sama, dua jawaban
BigQuery mengscan 4,455,256 byte pada query dashboard satu hari di atas -- sekitar 4.46 megabyte, praktis tidak ada apa-apanya untuk warehouse yang dibangun untuk skala petabyte -- karena daily-table pruning-nya bekerja tepat seperti yang direncanakan. Tetap saja butuh 0.98 detik.
Nanti di workshop ini, pertanyaan yang identik -- funnel satu hari yang sama, dikelompokkan dengan cara yang sama, dengan hitungan funnel yang sama -- diajukan ke baris-baris yang sama yang sudah duduk di tabel ClickHouse. Jawabannya keluar dalam 52 milidetik, untuk query yang bahkan sudah di-prune BigQuery hingga hanya beberapa megabyte:
Itulah teka-tekinya, dinyatakan secara persis: dua sistem, pertanyaan yang sama, dan BigQuery sudah melakukan bagian yang seharusnya membuat query cepat -- membaca hampir tidak ada apa-apa -- dan tetap kalah sekitar 19 kali. Jika jaraknya soal jumlah byte yang discan, seharusnya jarak itu tidak ada sama sekali. Modul ini belum menjelaskan apa sebenarnya penyebabnya. Simpan kedua angka -- 0.98 detik dan 52 milidetik -- selama dua modul berikutnya, yang menaruh data yang sama di depan Anda dua kali lagi sebelum workshop ini mulai menjelaskan alasannya.
Di mana BigQuery memang menang
Ini bukan argumen bahwa BigQuery dibangun dengan buruk. BigQuery menyelesaikan masalah yang tidak bisa diselesaikan ClickHouse: arahkan ke petabyte yang belum pernah dimodelkan siapa pun, ajukan pertanyaan yang tidak diantisipasi siapa pun, dan BigQuery menjawab -- tanpa komitmen schema di awal, tanpa cluster yang harus disizing, tanpa service yang berjalan di antara pertanyaan. Zero operational surface adalah keunggulan nyata untuk analitik ad-hoc dan eksploratif di atas data yang belum dibentuk siapa pun. Workshop ini membahas masalah yang berbeda: dashboard dengan user nyata yang mengaksesnya secara konkuren, sebuah bentuk yang tidak dirancang untuk dilayani murah oleh model pricing dan concurrency BigQuery.
Selesai jika
Anda bisa menyatakan ulang teka-tekinya dalam satu kalimat: pertanyaan funnel satu hari yang sama, diajukan ke baris yang sama, butuh 0.98 detik di BigQuery setelah scan-nya di-prune hingga 4.46 megabyte, dan 52 milidetik di ClickHouse -- dan jarak itu tidak dijelaskan oleh seberapa banyak data yang dibaca kedua sistem. Lanjut ke 02 Query di tempat.