06 実験
あなたのデータセットはLangfuse にシード化されています。scripts/run-dataset.ts は既にリポジトリにあります。
ワークショップマテリアルは公開 langfuse/langfuse-workshop リポジトリで保守されています。実行可能なアプリ、チェックポイントブランチ、ローカルセットアップについてはリポジトリを使用してください。
開始ポイント
git checkout checkpoint/06-experimentsあなたのデータセットはLangfuse にシード化されています。scripts/run-dataset.ts は既にリポジトリにあります。
実験が必要な理由
トレースは1つのターンについて教えています。実験はデータセット全体の動作について教えています。すべての実験実行は同じ3つのことをします:
- データセットから各アイテムをプルします。
- アイテムの入力をエージェント経由で実行 — ウェブアプリが使用する同じ
runSupportConversation(...)なので、トレース形状は本番と同じです。 - 実際の出力を期待される出力に対して1つ以上のエバリュエーターでスコア付けします。
異なるエバリュエーターは異なる質問に答えます。より広い投票とどの投票を選ぶときについては、Langfuse Academy レッスン評価 を参照してください。このワークショップの場合、答えの品質に最初に読むことを与える2つのを使用しています:
keyword_overlap(決定的) — 答えは期待されたステップをカバーしましたか? 高速、安価、実験スクリプトで直接計算されます。correctness(LLM-as-a-judge) — 答えは実際に正しいですか? より表現力豊か、特に文言が異なるが基礎となる答えが一致する必要がある場合。
このチャプターは意図的に混合セットアップを使用しています: 安価な決定的なチェックは実験ランナーの隣のコードに住んでいる、一方、セマンティックジャッジはLangfuse に住んでいます。
ゴール
このチャプターの終了時に:
- オンデマンドで完全なデータセットをエージェントに対して実行できます。
- すべてのアイテムは
keyword_overlapスコア (決定的) とcorrectnessスコア (LLM-as-a-judge) を取得します。 - 2つのスコアとアイテムごとのトレースはLangfuse に表示され、将来の実行と比較する準備ができています。
ステップ1 — ランスクリプトを理解します
scripts/run-dataset.ts を開きます。ファイルは番号付きコメント (// --- 1. Boot the OpenTelemetry SDK ...、// --- 3. The deterministic evaluator ... など) で注釈が付けられているため、セクションごとに読むことができます。高レベルでは:
DATASET_NAMEでホストされたデータセットをLangfuse からロードします。- アイテムごとに、ウェブアプリが使用する同じ
runSupportConversation(...)を呼び出します。 dataset.runExperiment(...)を使用して、すべてのアイテムごとのトレースを1つの実行行に巻き込みます。keyword_overlapスコアをアイテムごとに、expectedKeywordsをエージェントの答えに対して比較して付属させます。
生成されるトレースは本番トレースと同じ形状です — 同じ dad-it-support-chat-turn ルート、同じOpenAI世代、同じツール span。追加UIセットアップのためのスコアは既にスクリプトに存在するため、決定的なスコアは必要ありません。
dataset.runExperiment(...) — 動く部品
全体的な実行は runExperiment への1つの呼び出しです。形状は次のように要約されます:
await dataset.runExperiment({
  name: "Dad IT Support Agent experiment",
  runName,           // unique label for this run; shows up in the Runs tab
  description: "...",
  metadata: { model: env.openaiModel },
  maxConcurrency: 1, // run items one at a time

  task: async (item) => {
    const response = await runSupportConversation({ /* item.input */ });
    return response.answer;
  },

  evaluators: [
    async ({ output, expectedOutput }) => ({
      name: "keyword_overlap",
      value: keywordOverlap(output as string, (expectedOutput as any).expectedKeywords),
      comment: "..."
    })
  ]
});
理解する3つのこと:
taskはあなたのアプリケーションロジック — 私たちはrunSupportConversation(...)に直接呼び込み、このスクリプトが生成するすべてのトレースが本番トレースと同じに見えることを意味します。evaluatorsはリスト。各エバリュエーターはtaskが返った後に実行され、アイテムトレースにスコアを付属させます。ここで1つの決定的なエバリュエーターを使用しますが、時間をかけて追加できます。runNameはすべてのアイテムごとのトレースを、Langfuse Runs ビューの1つの行に入れます。実行ごとに変更される名前を選択します (タイムスタンプを含める) ため、2つの実行は衝突しません。
ステップ2 — 決定的な keyword_overlap エバリュエーターを確認します
scripts/run-dataset.ts 内では、ヘルパー関数がデータセットアイテムの expectedKeywords をモデル答えで検索し、一致した分数を返します。
なぜそれをスクリプトに保持するのですか?
- 残りの実験コードの隣で読むのは簡単です。
- アプリと同じバージョンコントロールとレビューフロー を使用します。
- 決定的であるため、LLM呼び出しに費やす理由はありません。
これは、チームがスクリプトにいたいと思う実験ロジックのための良いデフォルトパターンでもあります。
代替: この同じ決定的なチェックは、プラットフォームで管理したい場合は、Langfuse コードエバリュエーターに移動することもできます。Code evaluators ドキュメント と Experiments via SDK ドキュメント を参照してください。
ステップ3 — Langfuse で correctness エバリュエーターを設定します
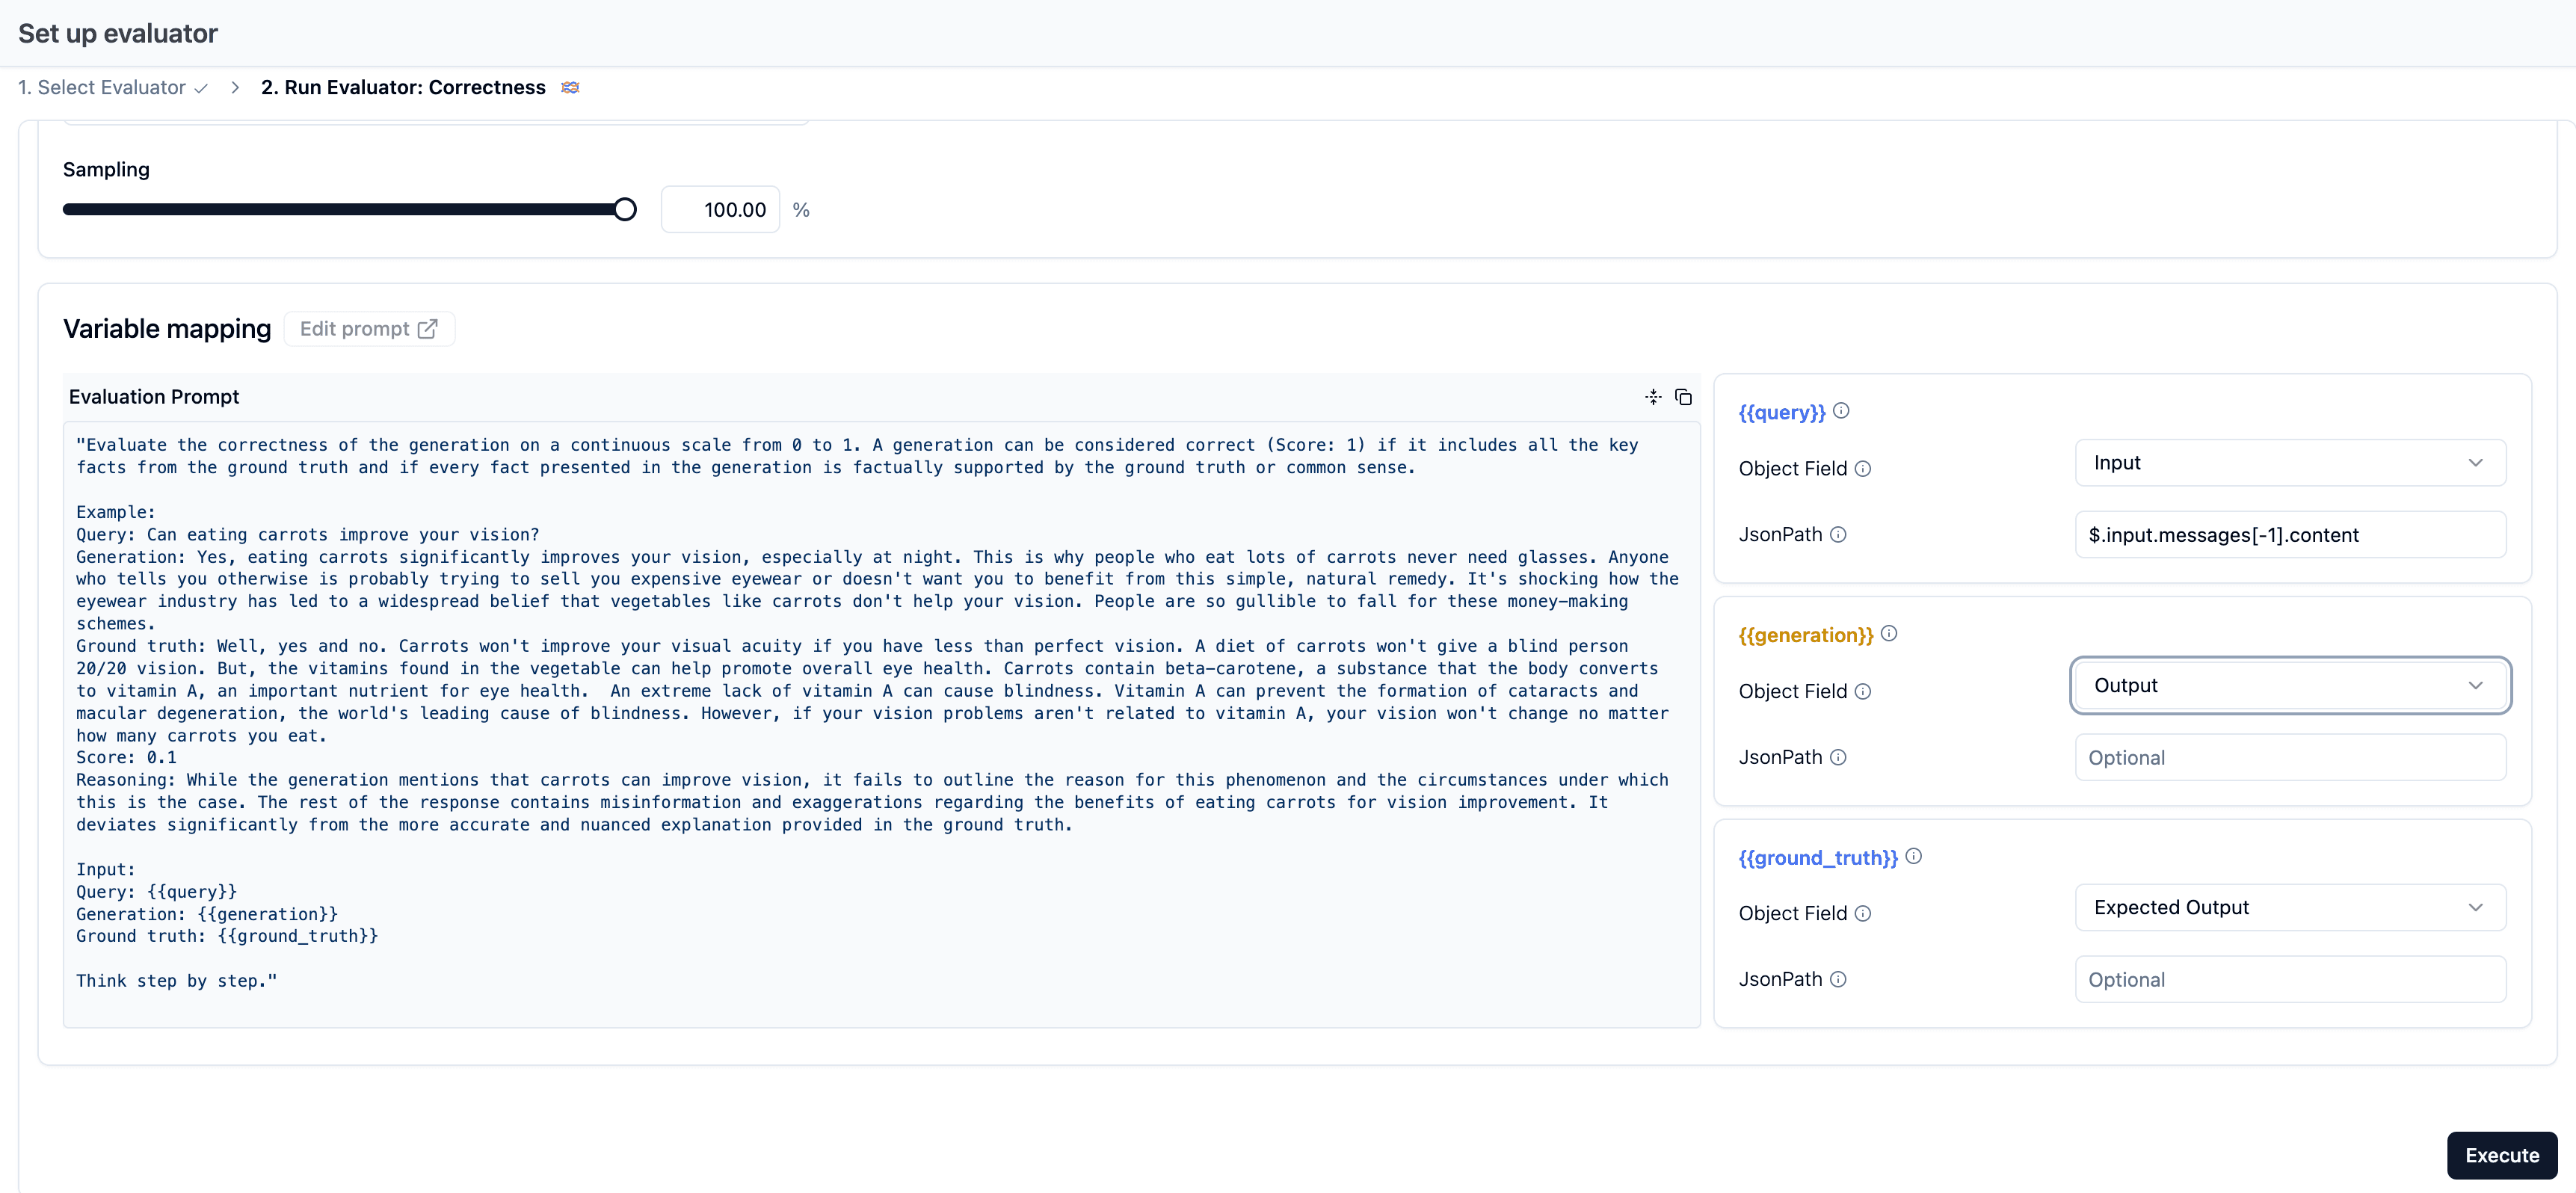
Langfuse は、実際の答えを理想的な答えと比較し、スコアを返す Correctness LLM-as-a-judge テンプレートを発送します。実際の答えに対して、デジタルセット実行に対して配線してから、すべてのアイテムが両方のローカル決定的スコアとモデルが判断した正当性スコアを取得して、実行比較ビューに表示されます。
新規プロジェクトチェック: 正当性はLLM-as-a-judge エバリュエーターです。セッション4でデフォルト評価モデルを設定しなかった場合は、今すぐ実行: Project Settings → LLM Connections を開き、OpenAI キーを追加します。モデル自体はエバリュエーター作成中に設定されます — Set up evaluator ウィザードはそれを Set up LLM connection ステップで質問します。
openai / gpt-4.1などの構造化出力対応モデルを選択します。設定されたら、Evaluators ページの上部に Default model として表示され、後で変更することもできます。Langfuse シークレットフィールドにのみAPIキーを保持してください。ワークショップトランスクリプトまたは共有メモに貼り付けないでください。
-
Langfuse で、Evaluators → Set up evaluator を開き、Use existing リスト(Langfuse managed evaluators)から Correctness を選択します。
-
このデータセットからの実行をターゲットにします:
- 実行時: Experiments (UIはしばしば観察に開くため、最初にこれを切り替え)
- フィルタ: Dataset が 'dad-it-support-workshop'
-
テンプレート変数をマップします。UIで、最初に Source ドロップダウンを設定し、次に必要な場所にのみJsonPath を追加します:
変数 オブジェクトフィールド JsonPath queryInput $.messages[-1].contentgenerationOutput 空白のままにする ground_truthExpected Output $.idealAnswer一般的な壊れたセットアップは、そのドロップダウンが最初に表示されるため、3つすべての変数を Input で残すことです。
generationまたはground_truthが Input をポイントしている場合、エバリュエーターは実行ごとに間違ったデータを読み取ります。 -
セッション4で設定したデフォルトジャッジモデルを使用するか、別の構造化出力対応ジャッジモデルを選択して保存します。
-
エバリュエーターを有効にします。
これが最初の実験の場合、レビュー表またはプロンプトプレビューはセットアップ時に No results または No trace data found と言う可能性があります。これは予想通り。実験を実行していないため、Langfuse がに対してプレビューするものはありません。今評価器を保存します。ステップ4が最初の実行を作成した後、このエバリュエーターは新しい実験アイテムを非同期でスコア付けします。
なぜ Experiments で実行しますか? このワークショップでは、correctness を実験実行行と実行比較ビューに表示したいからです。
ステップ4 — データセットを実行します
npm run dataset:runスクリプトはコンソールにフォーマットされた実行サマリーを印刷することで完了します。アイテムレベルのトレースとスコアは、実行の実行時にLangfuse に表示され、正当性エバリュエーターは新しい実行行の上で非同期的に実行を続けるため、スコアを入力し続ける可能性があります。
スクリプトは keyword_overlap 自体を付属させます。ステップ3で設定した正当性エバリュエーターは、短時間後の新しい実行行でLangfuse 内で非同期的に実行されます。
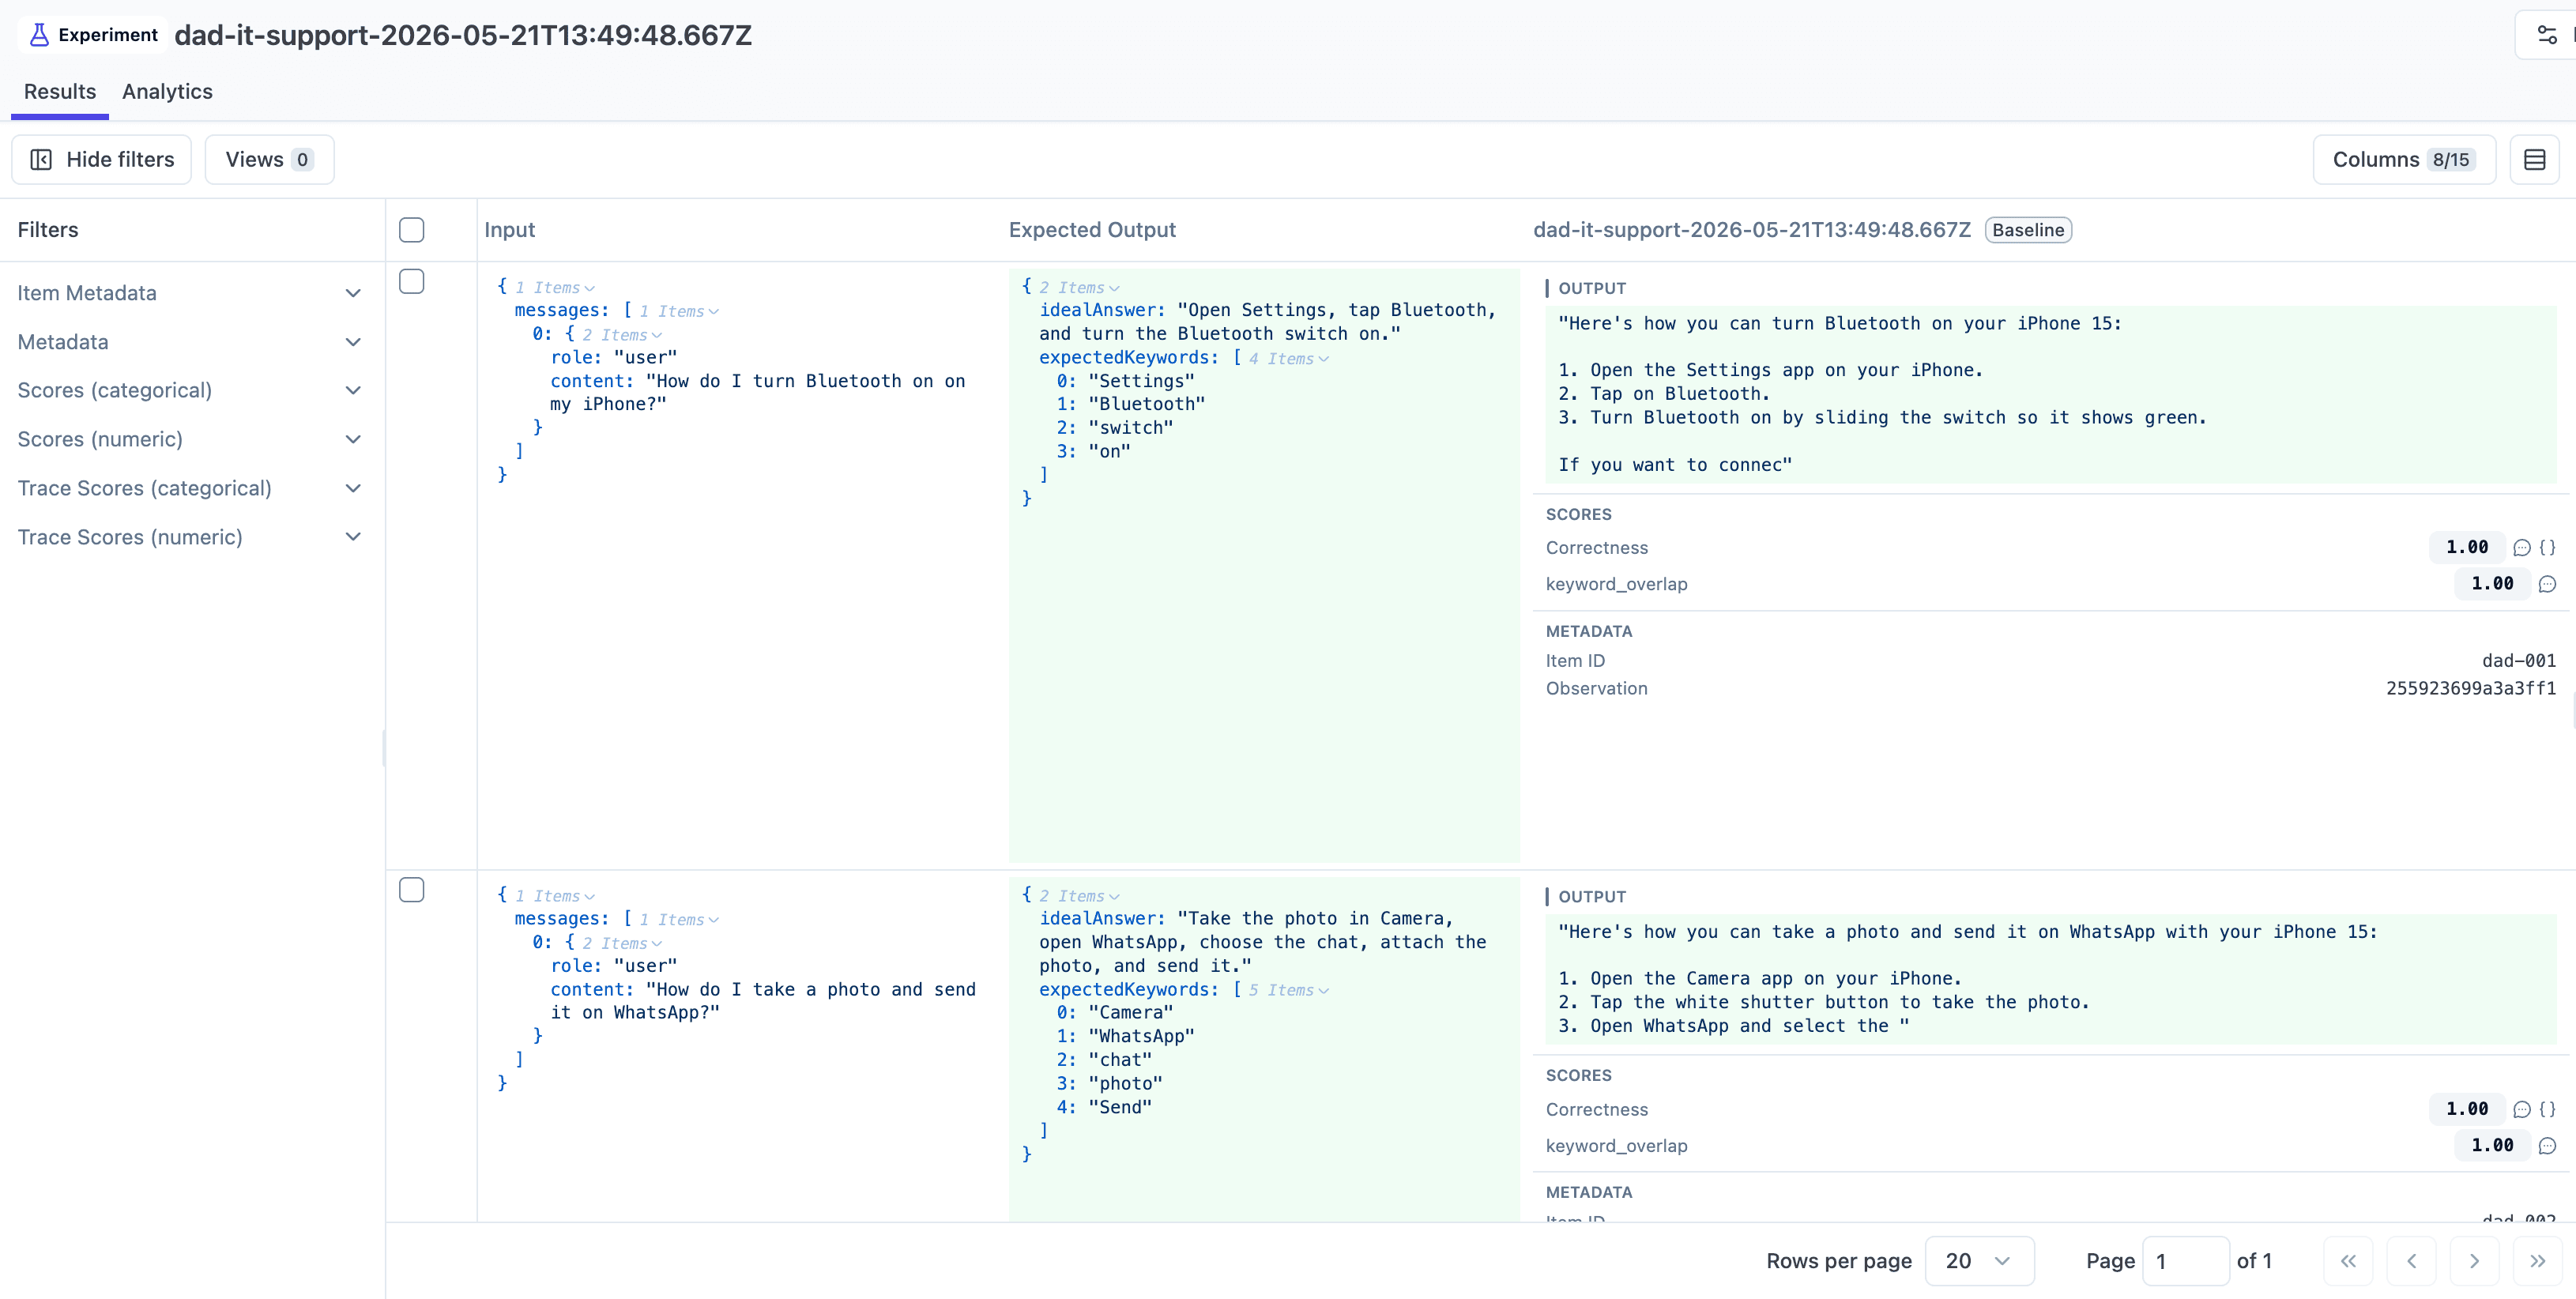
Langfuse で検査する内容
- データセット下の新しい Run — アイテムごとに1つの行、2つ スコア:
keyword_overlapとcorrectness、プラストレースリンク。 - アイテムレベルトレース — 本番トレースと同じ形状。
- データセットの チャート表示 → 実行あたりの平均は両方のスコアについて、将来の変更を比較する準備ができています。
完了したことを確認する方法
- 1つの実行行がデータセット下に表示されます。
- すべてのアイテムにはトレースと両方のスコア付きがあります。
- トレース形状は通常の本番トレースと一致します。
ラップアップ
2つのスコアリングアプローチは同じ実行について2つの角度を与えます: keyword match "正しいステップをカバーしましたか?" そして 正当性 "答えは実際に正しいですか?" 実際の評価プログラムは、このような決定的でジャッジベースのチェックを結合することがよくあります。
チームがLangfuse UIでより多くのエバリュエーターロジックを好む場合、決定的なチェックは後で言語評価に移動することもできます。Code evaluators ドキュメント がそのパスをカバーし、Experiments via SDK ドキュメント はコード側のセットアップがどのように組み合わせるかを示しています。
Langfuse スキル(/langfuse) は、推奨されるエバリュエーター形状とセットアップパターンを知ります — このチュートリアルは、スキルが何をしているかを理解するためです。Langfuse Academy レッスン で実験についてさらに詳しく学びます。
最終状態
これは 07-evaluation の開始ポイントです。