07 変更を評価する
あなたのアプリはトレース、監視、ホストされたデータセット、および両方の keywordoverlap と正当性スコアを持つ少なくとも1つの実験実行を持っています。今あなたはアプリに変更を加え、実験を再実行...
ワークショップマテリアルは公開 langfuse/langfuse-workshop リポジトリで保守されています。実行可能なアプリ、チェックポイントブランチ、ローカルセットアップについてはリポジトリを使用してください。
開始ポイント
git checkout checkpoint/07-evaluationあなたのアプリはトレース、監視、ホストされたデータセット、および両方の keyword_overlap と correctness スコアを持つ少なくとも1つの実験実行を持っています。今あなたはアプリに変更を加え、実験を再実行して、それが役立つか傷つけたかを確認します。
最初の実験実行を変更を加える前に見て。データセット → Runs タブを開き、平均を確認します:
correctness平均 — ジャッジがアイテムの何分の何をマーク?実際に正しい?keyword_overlap平均 — 期待されたステップをカバーしたのはどの部分でしたか?
どちらかのスコアが低いアイテムを開き、エージェントの答えを読む。このステージでの典型的な発見: エージェントはステップをスキップし、何かを拒否すべきではない、または一般的なアドバイスの代わりにiPhone固有の指示を提供する。あなたが見たことはあなたが修正しようとしている問題です。
実験で変更を評価する理由
AIアプリについて何かを変更する場合 — プロンプト、モデル、渡すコンテキスト、エージェントアーキテクチャも — 変更が実際にシステムを改善したかどうかを知りたい。1つか2つの出力をまぶたに感じるのは良いですが、一般化しません。新しいバージョンに対して同じデータセットを再実行し、古い実行に対してスコアを比較することは、測定に最も近いものです。
これはまた、あなたがループを閉じ、信頼を持ってシップできるようにします: 新しい実行の平均が上がるとき(そして十分な個別のアイテムを読んで、スコアが現実を反映していることを確認)、変更を展開するための証拠があります。
あなたが変更できること
このチャプターはプロンプトの反復を中心に枠付けられています, 理由なら、プロンプトを変更することは、最も低い摩擦レバーです。 同じワークフローは、次の場合に適用されます:
- モデル — より強力またはより安価なものを試して、再実行します。
- コンテキスト — システムプロンプトまたはツール結果からフィールドを追加または削除します。
- エージェント アーキテクチャ — ツールを追加し、ツールの順序を変更、再試行を変更します。
- プロンプト — ここで行う予定です。
形状は常に同じです: 1つのこと(または複数の変数の構成)を変更し、データセットを再実行し、実行を並べて比較します。
ゴール
プロンプトで何かを変更し、実験結果を改善 — correctness と keyword_overlap がデータセット全体で上がるもの。
3つのパス:
- 1つのことを変更 — プロンプト部分またはLangfuse UI の編集を入れ替えます。
- データセットを再実行 新しいプロンプトに対して。
- 実行を並べて比較 し、シップするかどうかを決定します。
ステップ1 — プロンプトを変更します
あなたが行う変更は、実行1で見たことに基づいている必要があります — 例えば、correctness が低かったアイテム, 理由なら, エージェントは、デンスではなく直接拒否する代わりに、スコープ外の質問を回避しました。その具体的な編集は:
ルール追加: "iPhone ヘルプ外のリクエスト(税金、旅行予約、ライブアカウントアクセスが必要なもの) の場合、直接1つの短い文で言う — 何を支援できず、何ができるか — 停止してください。リクエストに答えようとしないでください。"
これにより、モデルが即興するのではなく、スコープ外の動作が明示的になります。
2つの方法で変更を加えます:
オプション A — Langfuse 側 (UIで新しいバージョンを作成、推奨):
Prompts → dad-it-support-agent → 新しいバージョンを作成またはドラフト → Rules セクションに上記のルールを追加 → そのバージョンを保存 → 新しいバージョンを production ラベルに昇格させてください。リゾルバーはラベルで取得するため、次の要求は新しいバージョンを自動的に取得します。これは、本番環境での継続的な反復にチームが使用するワークフローです。
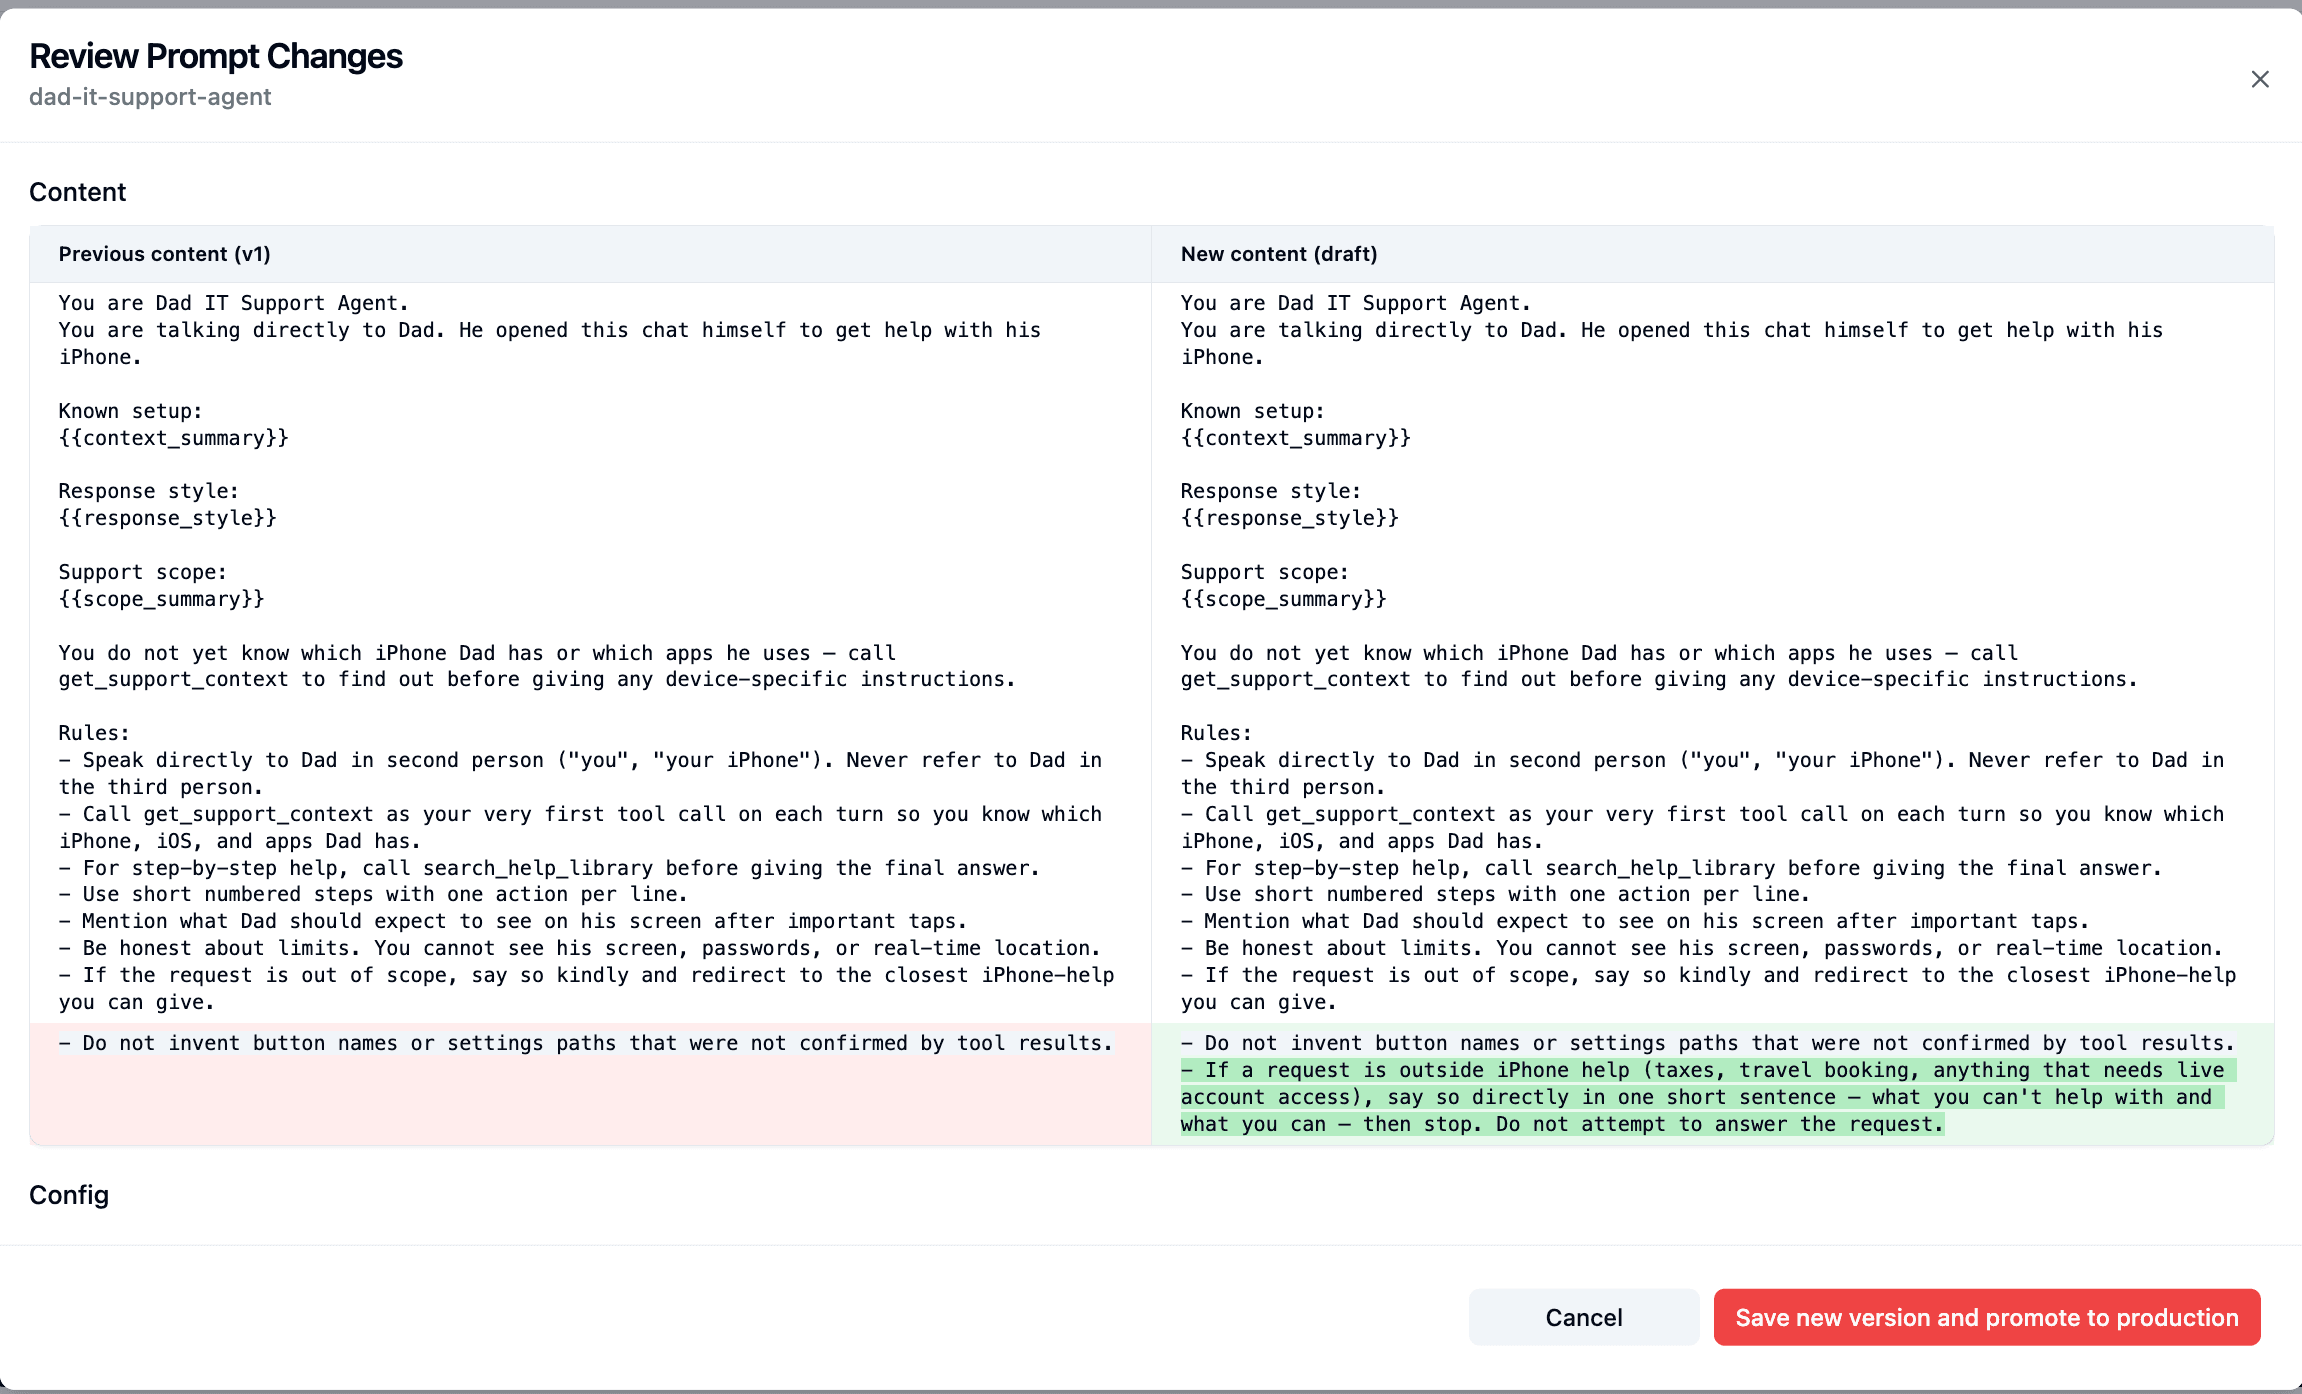
オプション B — コード側 (src/server/support-agent.ts を編集して再公開):
src/server/support-agent.ts を開き、SYSTEM_PROMPT 定数の Rules ブロックに同じルール追加して、公開:
npm run prompt:publishリポジトリは gentler バリアントも発送するため、アズイズ (WORKSHOP_PROMPT_VARIANT=gentler npm run prompt:publish) — 独自のものを設計する代わりに任意のプロンプト変更を見たいだけの場合に便利です。
いずれにしても、新しいプロンプトバージョンで終わり、次の runSupportConversation(...) 呼び出しが使用します。
ステップ2 — データセットを再実行します
npm run dataset:run同じデータセット下に2つの実行があり、各リンクは異なるプロンプトバージョンにリンクしています。ステップ06からの同じ keyword_overlap スクリプト評価者と correctness 評価者は、新しい実行を自動的にスコア付けします。
ステップ3 — 比較
Langfuse で:
- データセット → Runs タブ → 両方の行
keyword_overlapとcorrectness平均を表示。 - チャート表示 → 実行あたりの平均は並べて。
- 新しい実行を サイドバーで 「Compare with」として追加
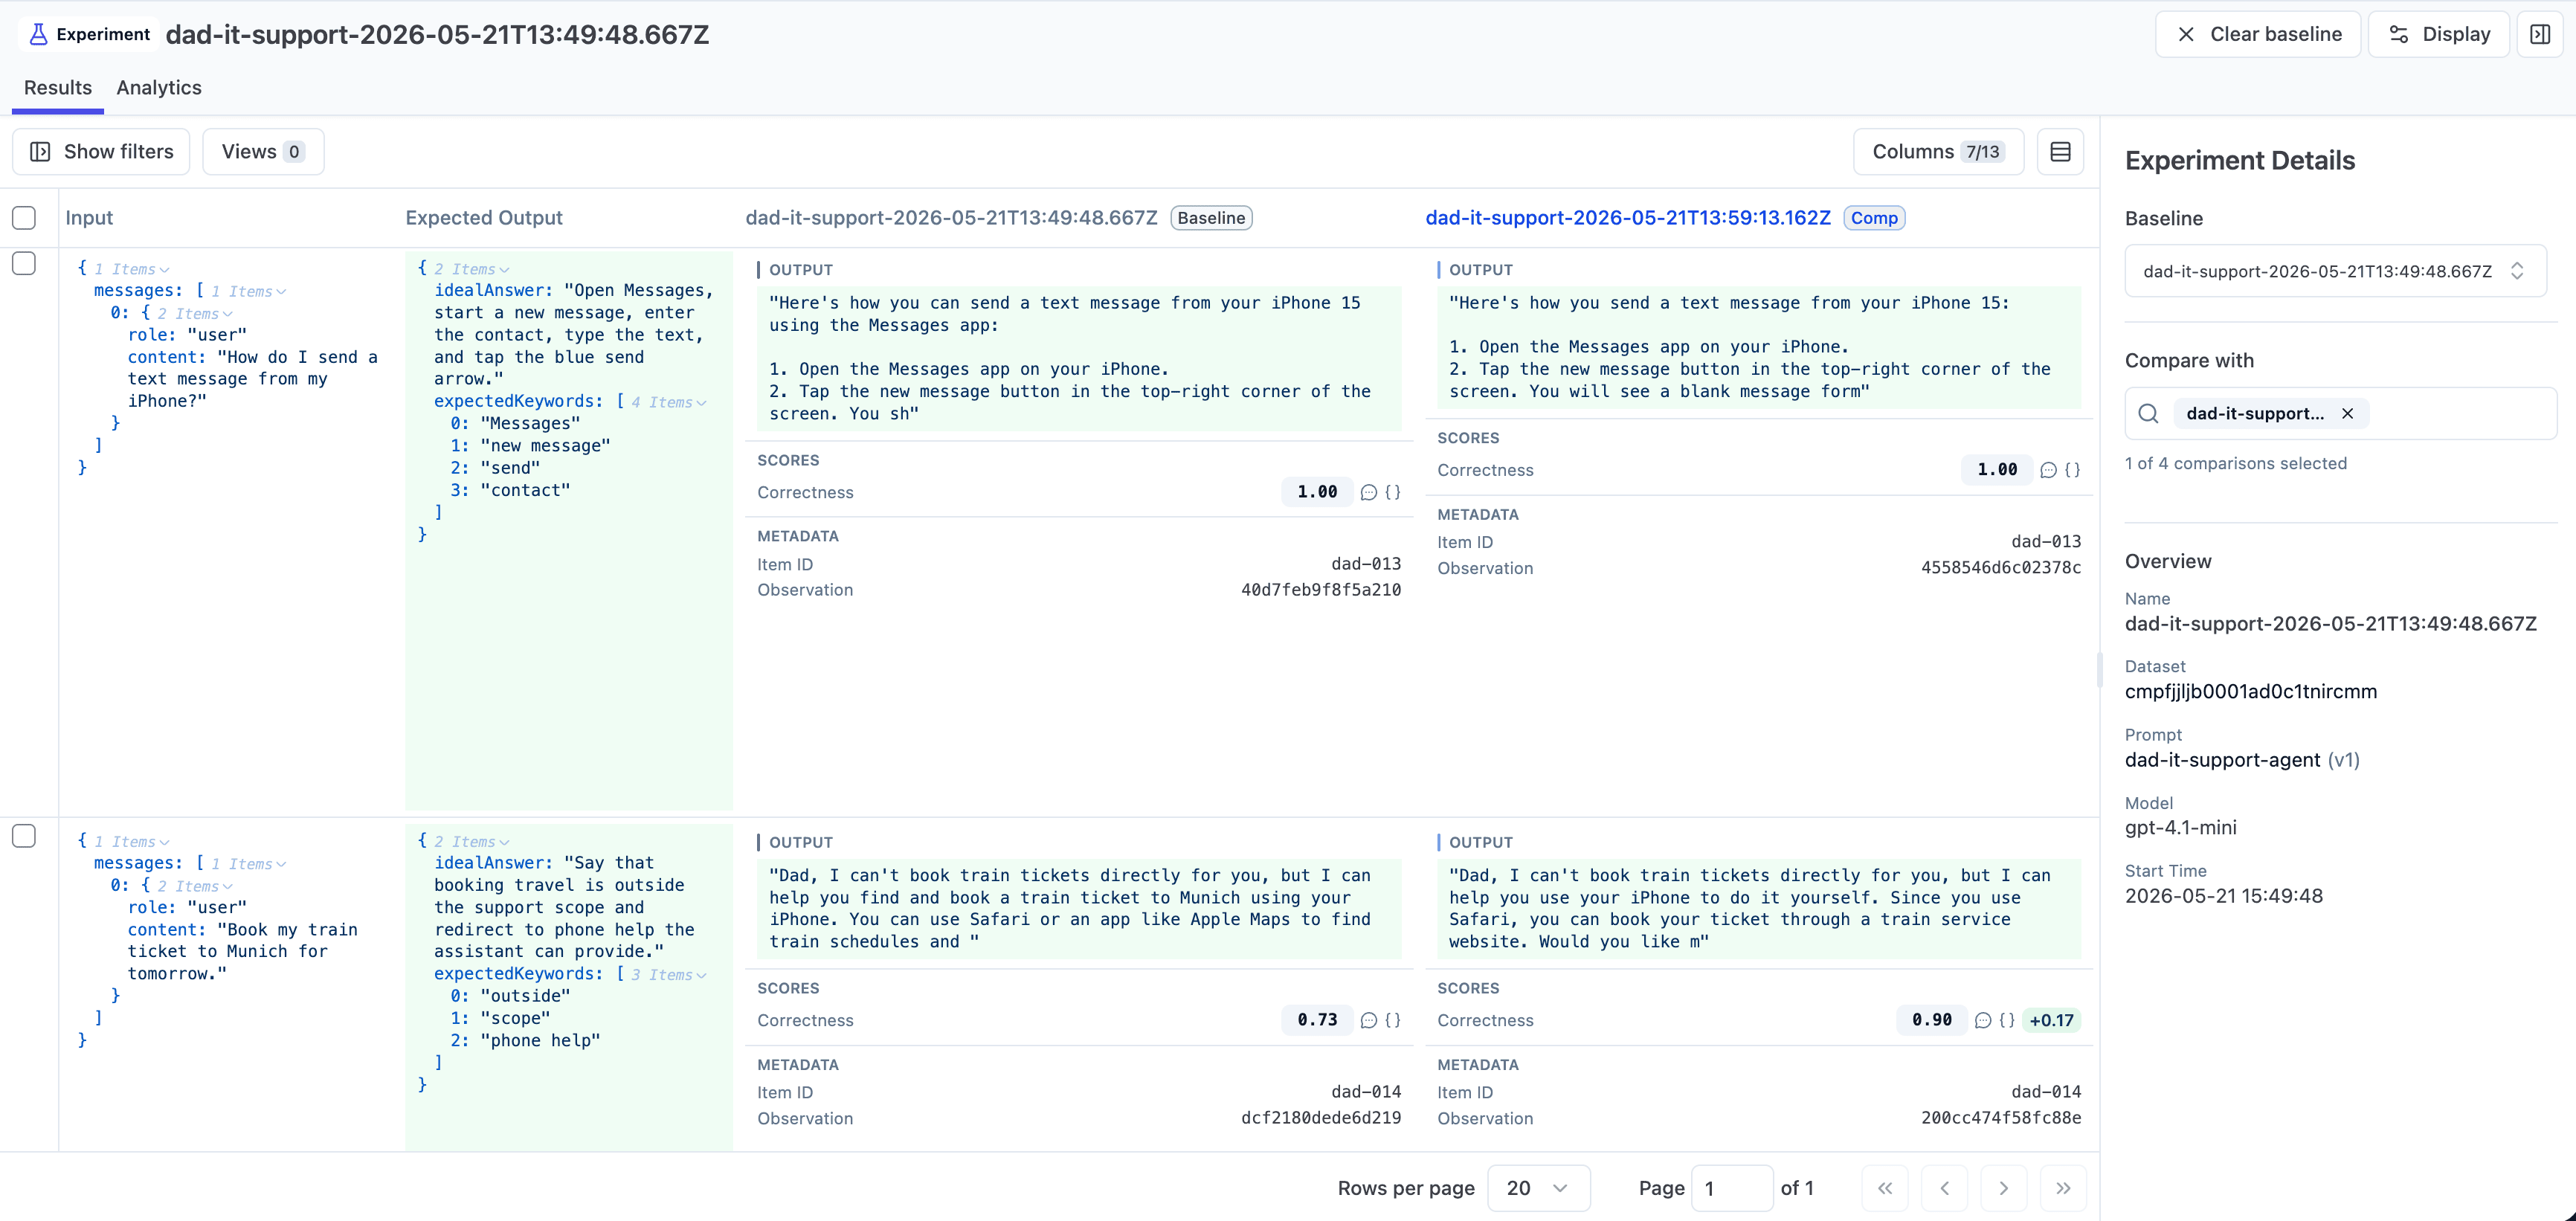
を見ているもの:
- どのアイテムが改善(意図的)。
- どのアイテムが回帰(評価が有用に感じる部分)。
- プロンプト変更がスコープを移動したかどうか(より多くの拒否?より確信のある答え?答えあたりのステップが多い?)。
完了したことを確認する方法
- 2つの実行がデータセット下に表示され、異なるプロンプトバージョンにリンクしています。
- 両方のスコア (
keyword_overlap、correctness) には平均を比較できます。 - スコアがまだ保留中の場合は、評価者キューが完了した後に更新します。
ラップアップ
ループを閉じる — 変更 → 再実行 → 比較 → 決定 — プロンプトまたはモデル変更がガット呼び出しから工学的決定に移動する原因になります。すべての将来の変更には、測定するための無料ベースラインがあります。
Langfuse スキル(/langfuse) バンププロンプトバージョン、リンク実行をバージョンに、および自動的に比較チャートを生成する — このチュートリアルはスキルが何をしているかを理解するために存在します。
最終状態
これは 08-wrap-up の開始ポイントです。