03 データをロードする — 2つの方法
同じ2,650万ティックを2回ロードします: 本番で使うマネージドパイプラインの ClickPipes、そして s3() のワンライナー。そしてどちらをいつ使うか。
データは パブリック な S3 バケットに置かれているため、キーや認証情報は一切不要 です。URL を 指定するだけです。転送は S3 から ClickHouse へサーバーサイドで実行されるので、2,650万行が自分の ノート PC を通ることも、会場の Wi-Fi に依存することもありません。
同じ2,650万ティックを 2通りの方法 でロードして、両方を体験します。方法1は ClickPipes、本番で
使うマネージドなクリック操作のパイプラインです。方法2は SQL 1行 — デモ中に最速でデータを入れる
方法です。順番に進めてください。間に TRUNCATE を挟むことで行数が二重にならずに済みます。
方法1 — ClickPipes、マネージドな本番向けのやり方
ClickPipes はフルマネージドの取り込みサービスです。オブジェクトストレージやストリームを指定すれば、 コネクタを自作せずにロードを続けてくれます。以下が全体の流れです。
- 左メニューで Data sources をクリックし、Create ClickPipe ボタンを押します。
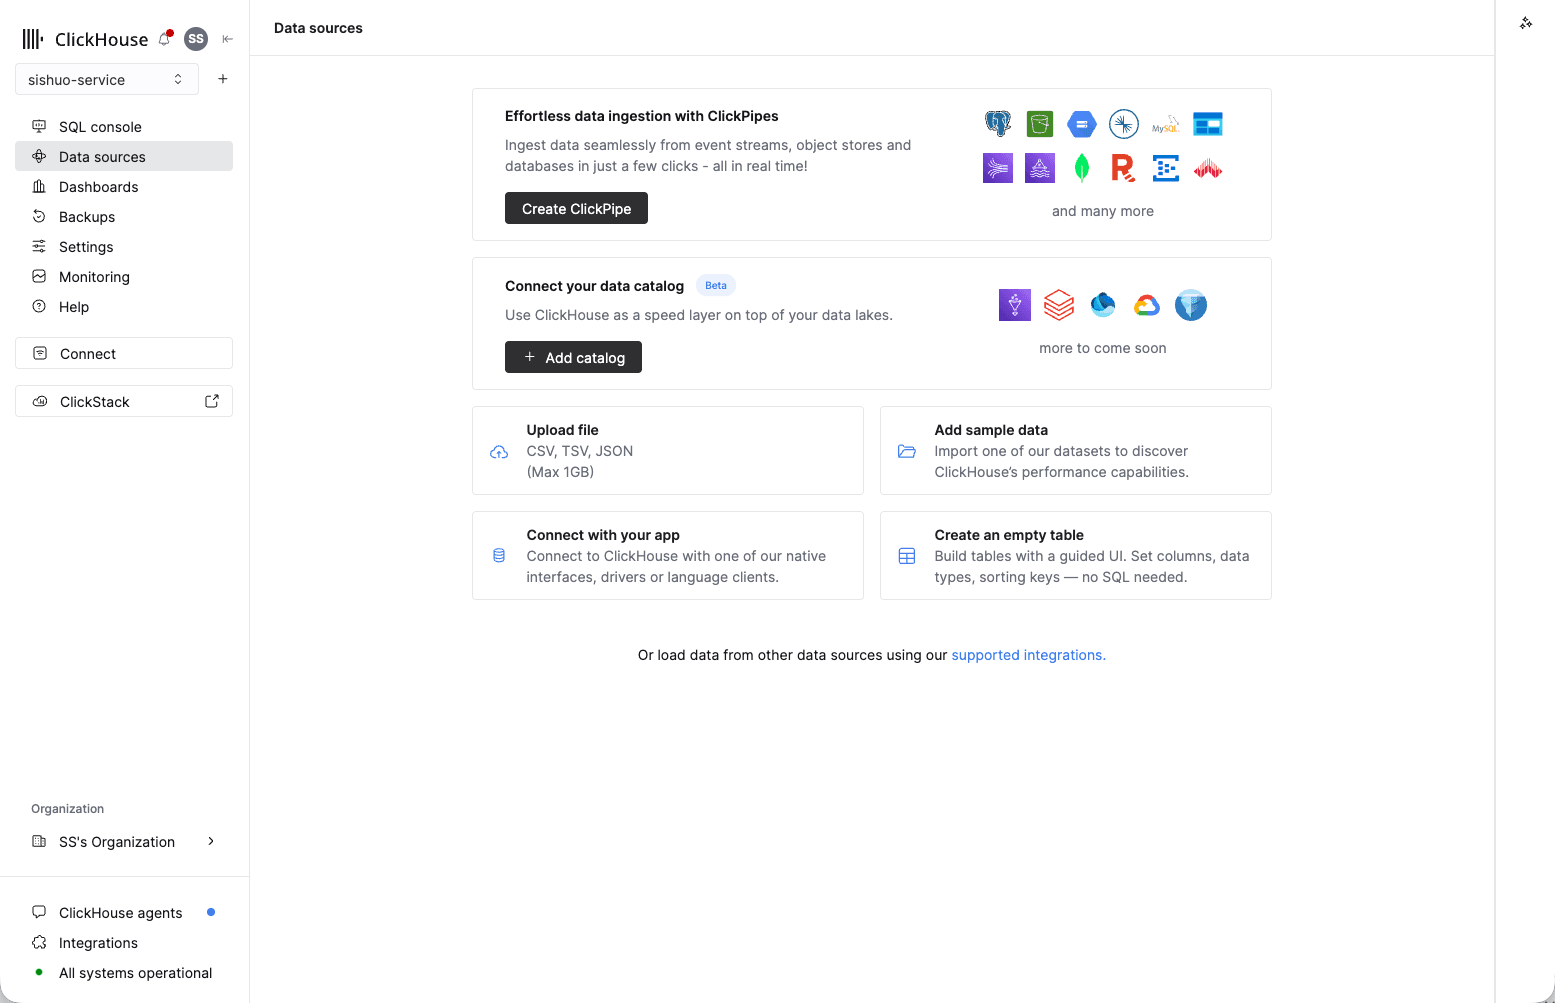
Data sources には「Upload file」や「Add sample data」もあります。
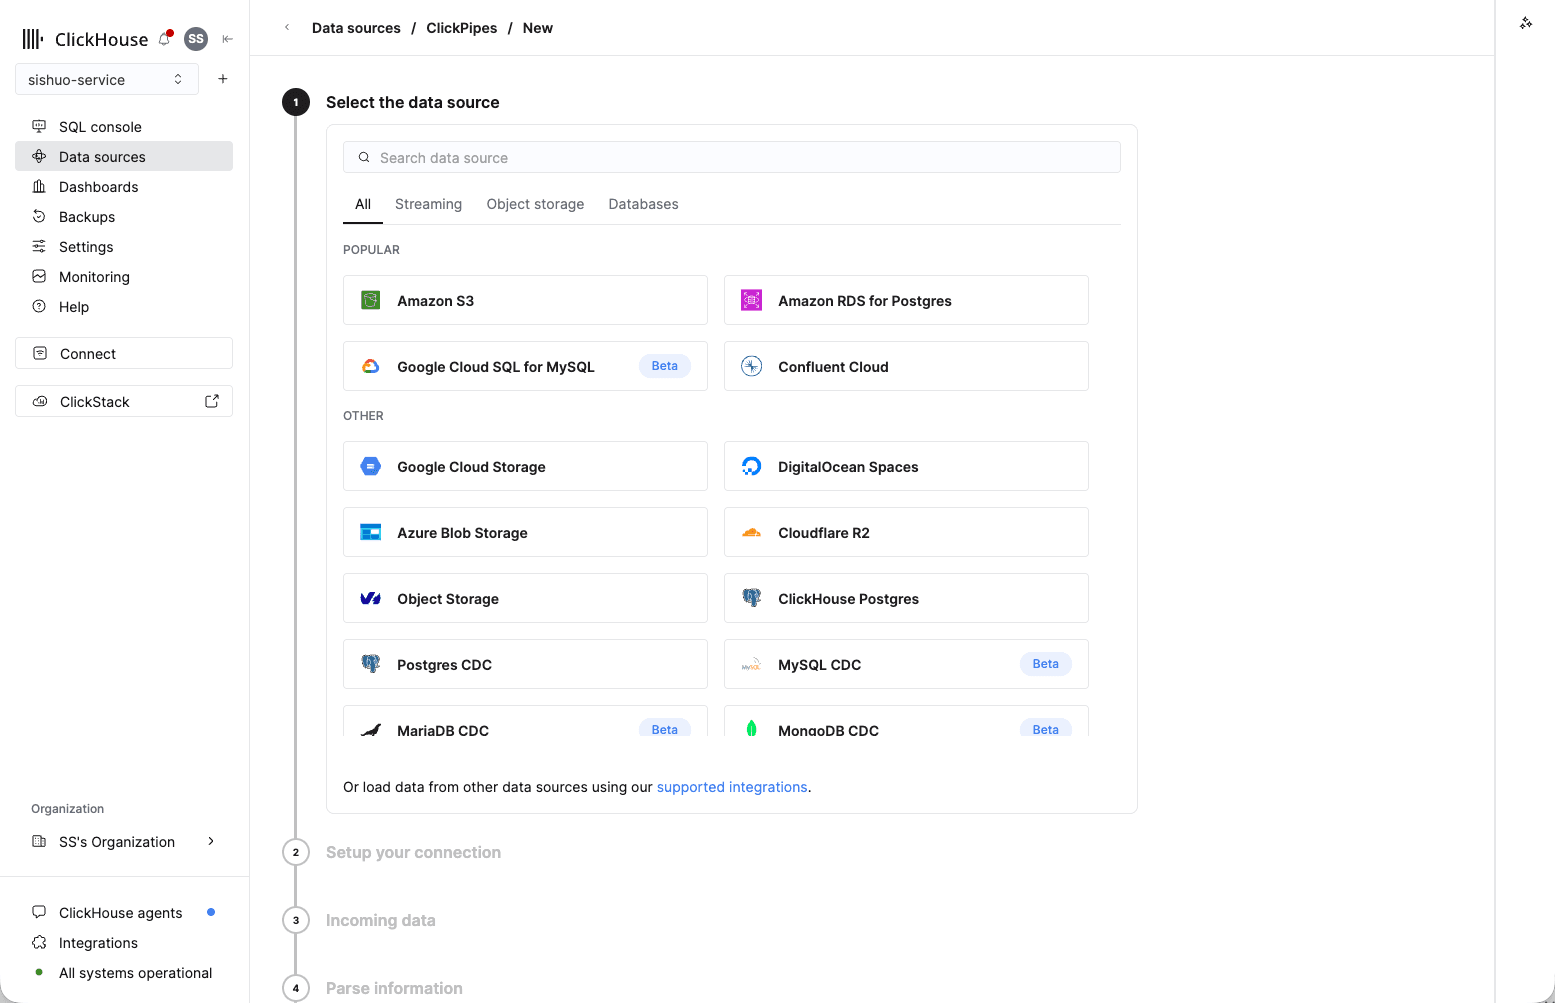
- Select the data source で Amazon S3(Popular リストの先頭)を選びます。
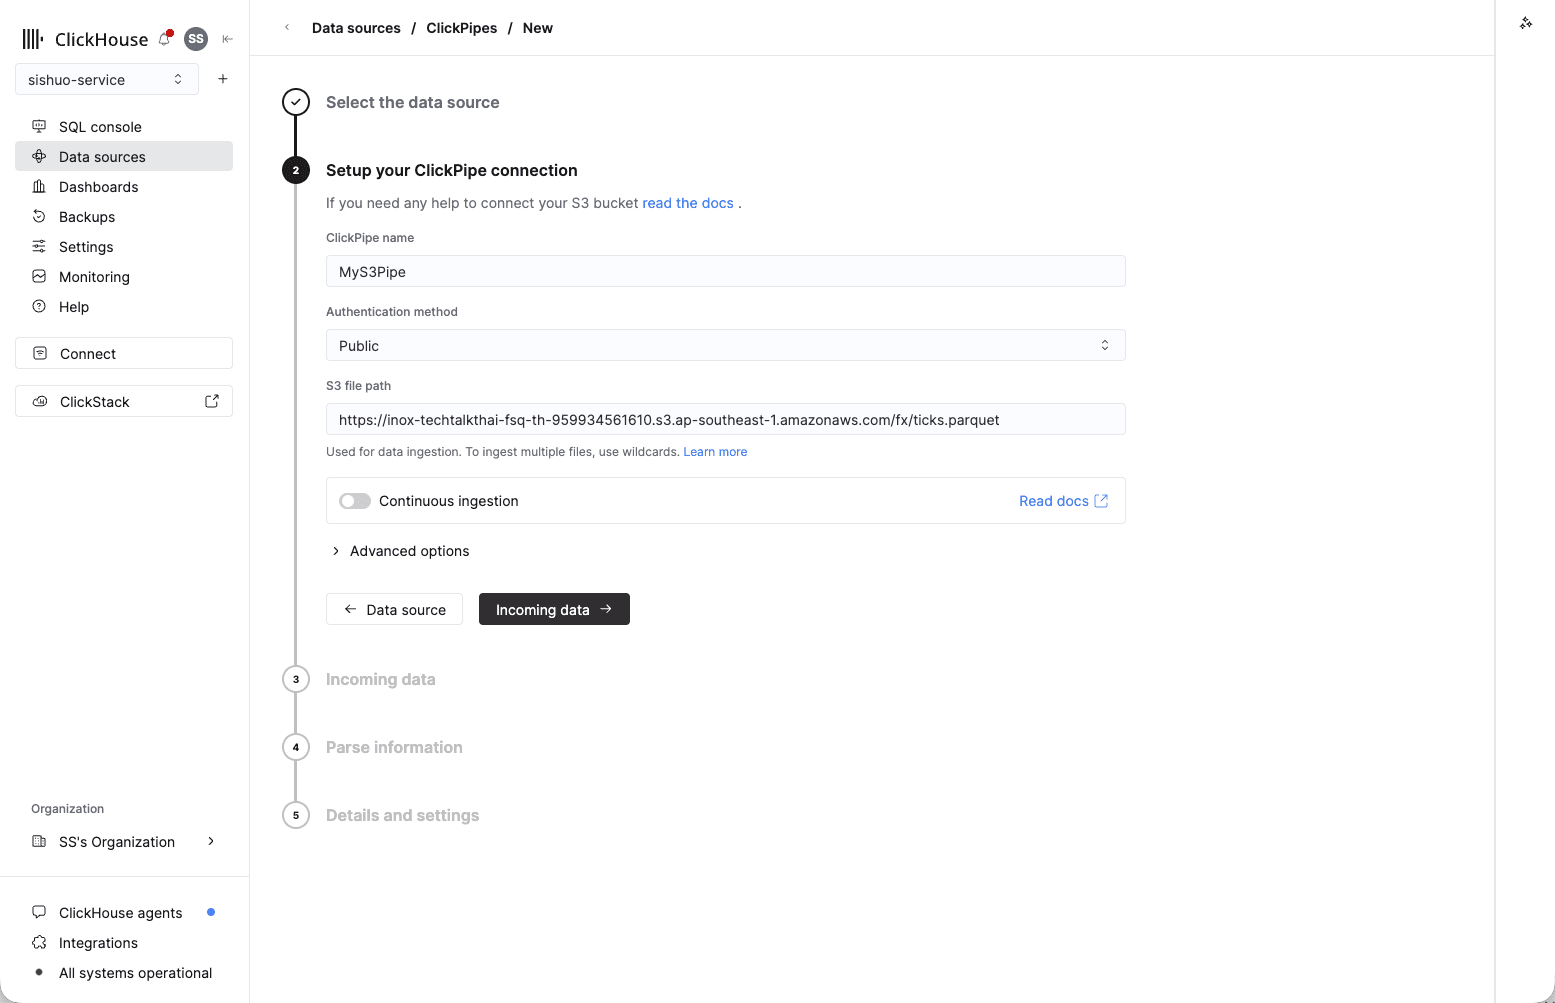
- Setup your ClickPipe connection で任意の name を付け、 Authentication method → Public(バケットはパブリックです)に設定し、 S3 file path に次を貼り付けます:
https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquetContinuous ingestion はオフのままにします(今回は単発のファイルです)。そして Incoming data → をクリックします。
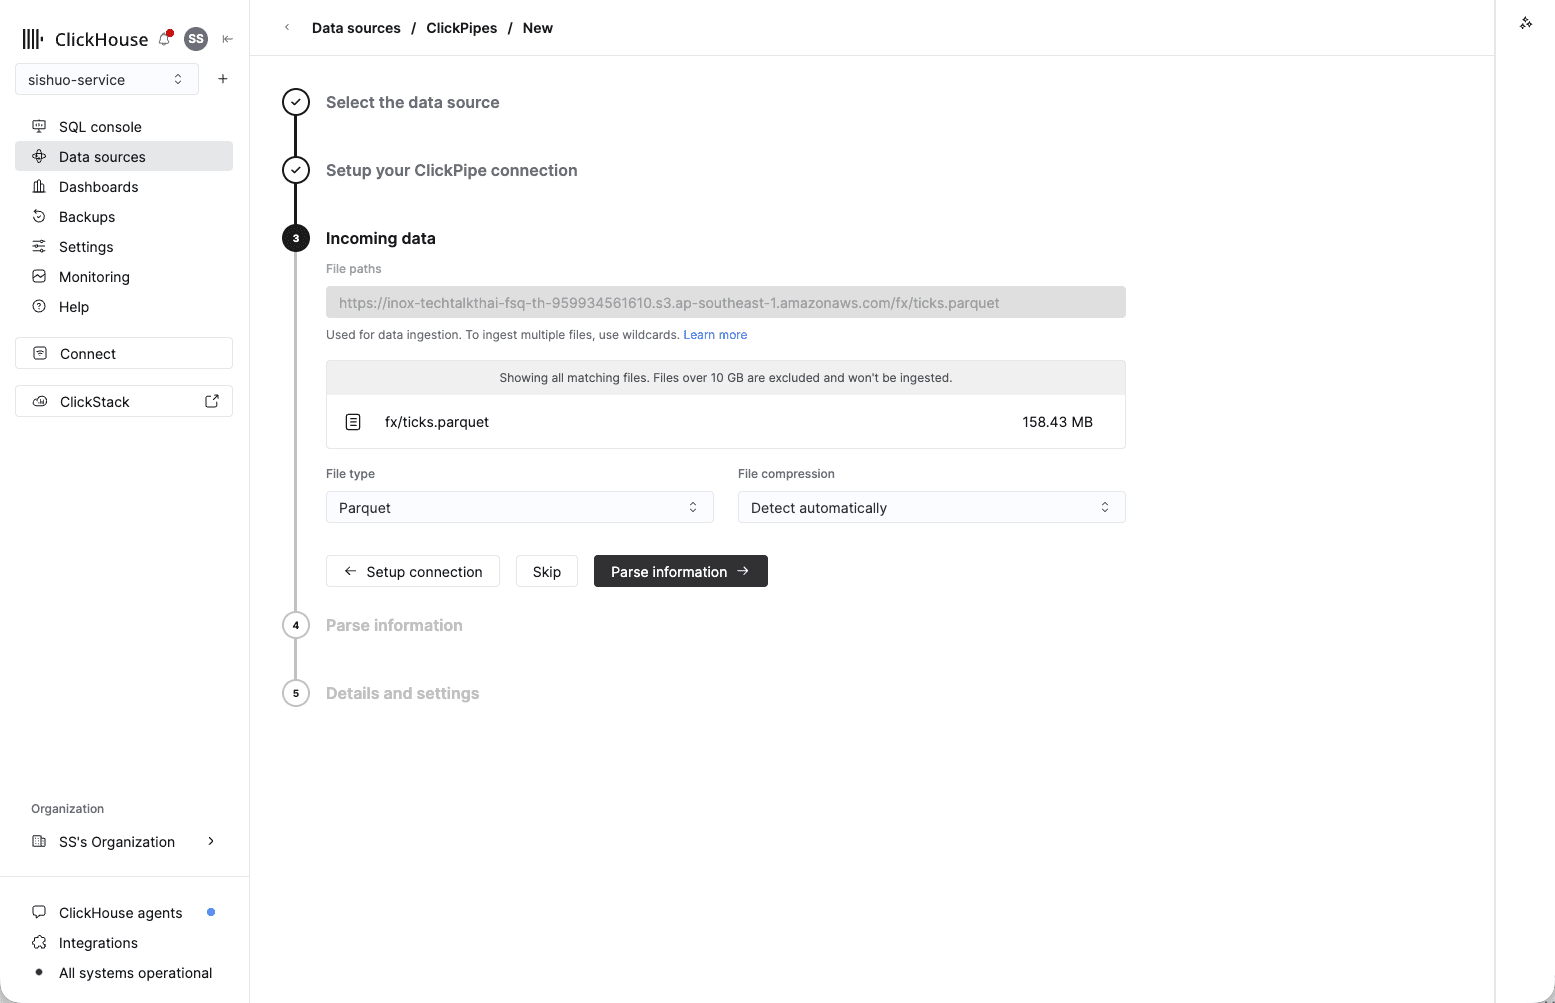
- Incoming data では、ClickHouse が一致するファイルをプレビューします。
fx/ticks.parquetが 158.43 MB と表示されます。File type → Parquet を確認し、 compression は Detect automatically のままにして、Parse information → をクリックします。
- Parse information では、ClickHouse がサンプル行をプレビューしてカラムを検出します。
Upload data to で Existing table を選び、テーブルがある Database(通常は
default)を選択し、Table →forexに設定します。ソース側のフィールド(datetime、bid、ask、base、quote)が対応するカラムに揃っているか確認してください。通常は自動で マッピングされます。追加の_path/_file/_sizeフィールドは未マッピングのままにします。 そして Details and settings → をクリックします。
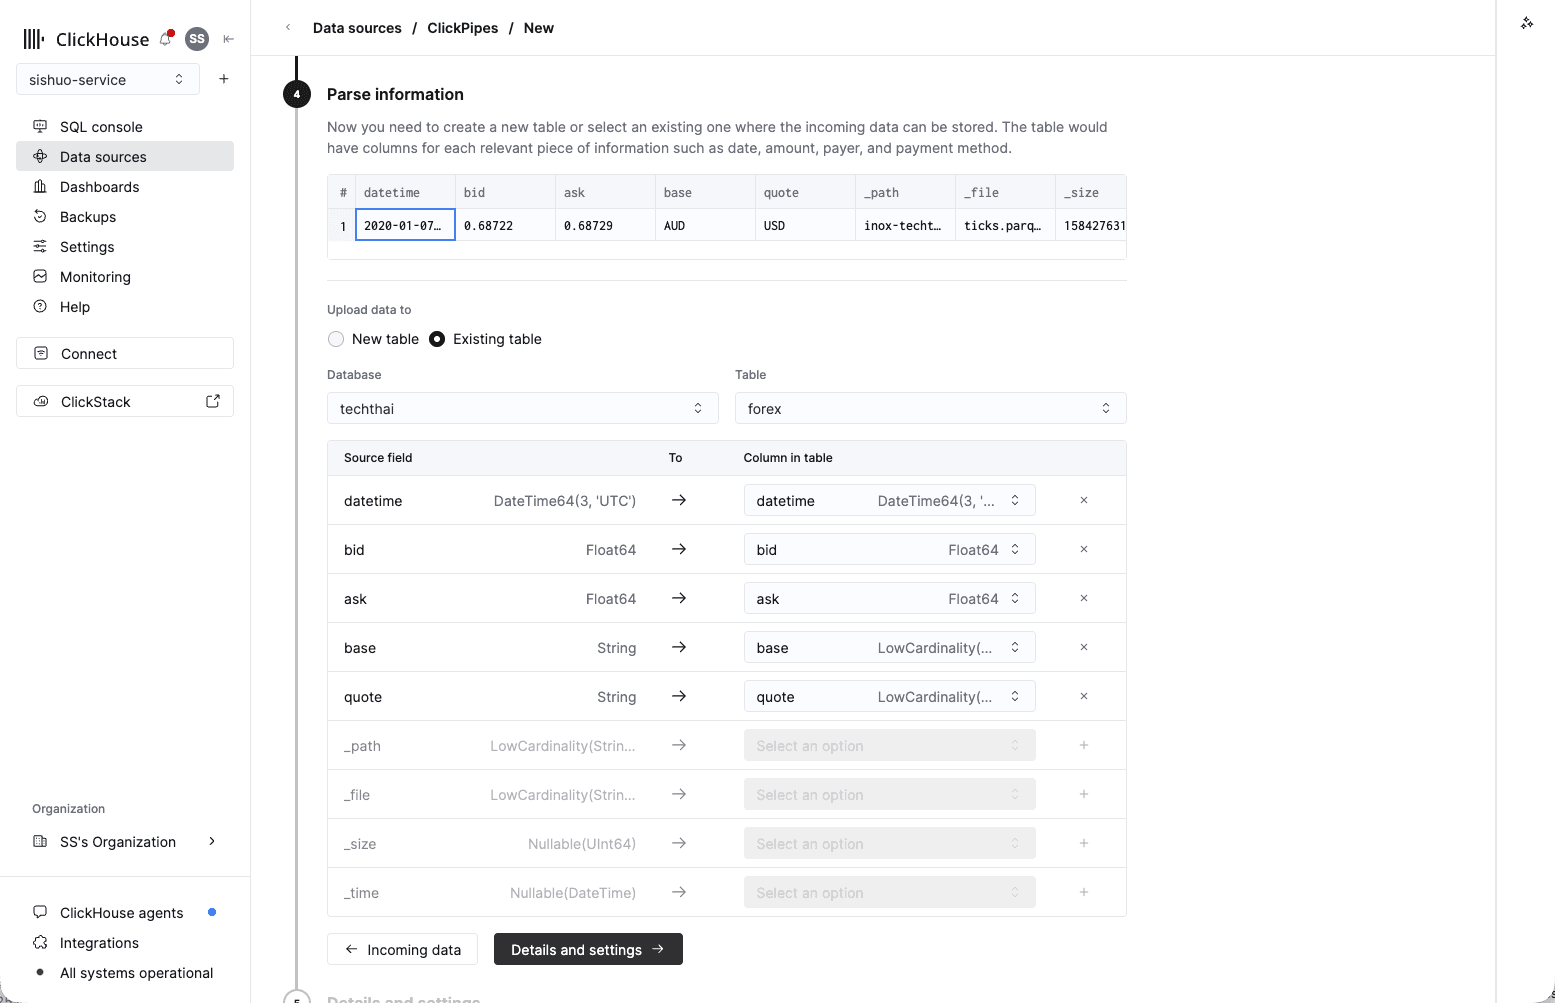
スクリーンショットには発表者の techthai データベースが写っていますが、自分のテーブルがある
データベースを使ってください。
- Details and settings では Permissions をデフォルトのままにして(ClickPipes が専用の 書き込みユーザーを作成します)、Create ClickPipe をクリックします。
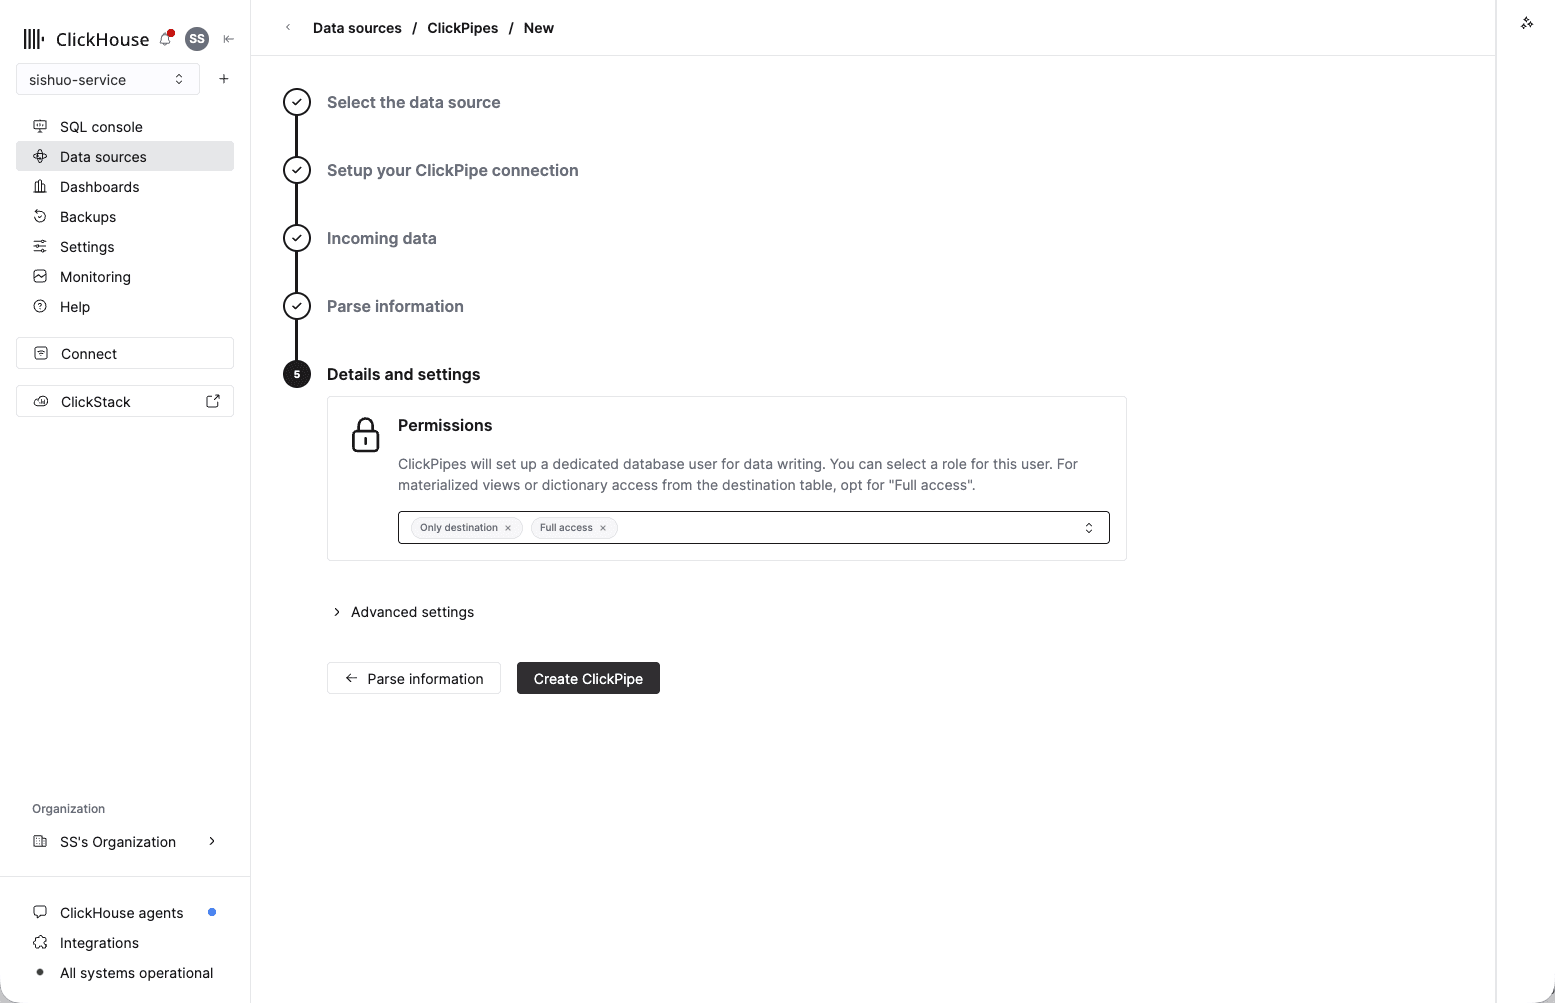
Spark ジョブもカスタムローダーも不要です。
- Data sources に戻り、作成した ClickPipe が表示されます。数秒で Status が Completed になり、Records に 26,488,218 と表示されます。オブジェクトストレージから すべてのティックがロードされました。
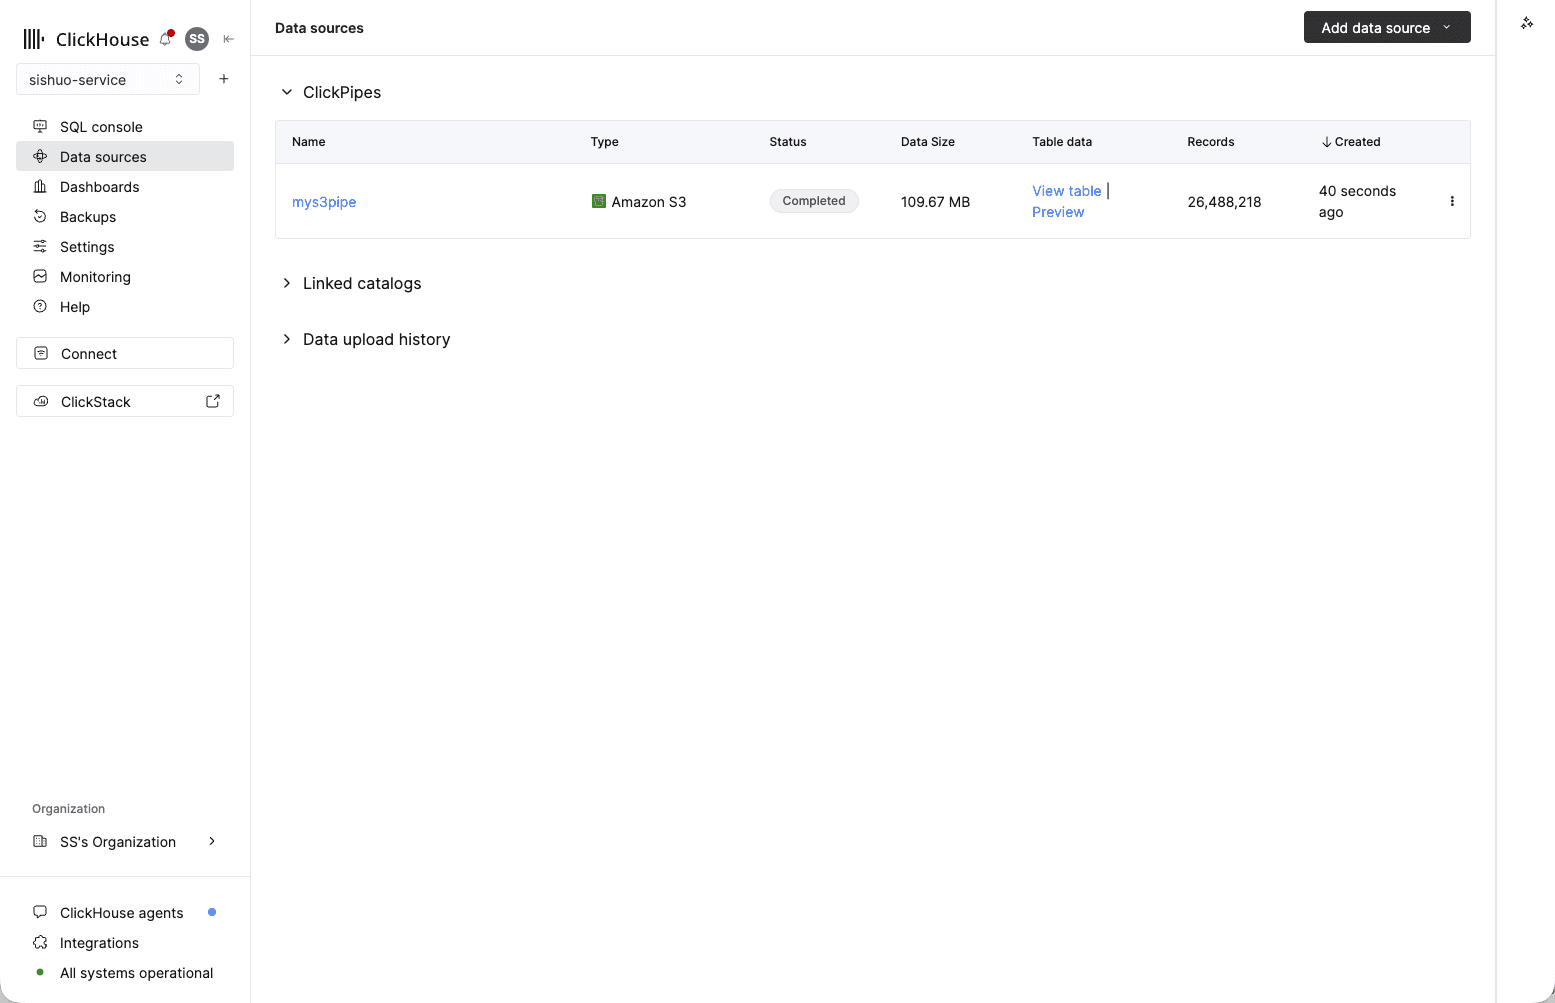
ロード結果を確認します。 SQL Console で次を実行してください:
-- expect 26,488,218 ticks across 12 pairs
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;
表示されるはずの結果
ticks = 26,488,218、pairs = 12。オブジェクトストレージから約2,650万行が数秒でロードされ ました。
方法2 — s3() のワンライナー、デモでは最速
次に、まったく同じデータを SQL ステートメント1本で、パブリックファイルから直接ロードします。 まず件数が二重にならないよう テーブルを空にして、それから挿入します:
-- clear the rows ClickPipes just loaded so we don't double up
TRUNCATE TABLE forex;

-- load all ~26.5M ticks from the public S3 file in one line (server-side)
INSERT INTO forex
SELECT * FROM s3('https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquet', NOSIGN, 'Parquet');

-- and check again (expect 26,488,218)
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;
NOSIGN は「認証情報なし」を意味します。パブリックバケットを読むにはこれだけで十分です。
テーブルのカラム順がファイルと一致しているので SELECT * がそのまま通ります。
ClickPipes と s3() 関数 — どちらをいつ使うか
同じ 26,488,218 行を2通りでロードしました。違いは最初のロードの あと に何が起きるか、つまり マネージドで継続的なパイプラインが欲しいのか、手早い単発の読み取りが欲しいのかです。
| ClickPipes | s3() テーブル関数 | |
|---|---|---|
| 何であるか | コンソールで設定するフルマネージドの取り込みサービス | クエリ内でインラインに呼び出す SQL 関数 |
| 向いている用途 | 本番、および設定したら放っておきたい継続的なロード | 手早い単発ロード、アドホックな探索、スクリプト |
| 継続 / 新規ファイル | バケットやストリームを監視し続け、新しいデータを継続的にロードできる | 単発 — 実行時にそこにあるものだけを読む |
| セットアップ | ガイド付き UI、SQL 不要 | INSERT … SELECT ステートメント1本 |
| 監視とリトライ | 組み込み — コンソールでステータス、エラー処理、リトライ | なし — 失敗したら自分で再実行 |
| ソース | 多数: S3、GCS、Azure、Kafka などのストリーム、Postgres/MySQL CDC、ほか | オブジェクトストレージのみ(同系統: gcs()、azureBlobStorage()、url()) |
目安: データが継続的に届き、マネージドに任せたいなら ClickPipes。今すぐファイルを取り込み
たいだけなら s3()。今日はワンライナーで素早くクエリできる状態にしました。では実際にクエリ
してみましょう。