03 Nạp dữ liệu — hai cách
Cùng 26.5M tick được nạp hai lần: ClickPipes, pipeline được quản lý mà bạn sẽ dùng trong production, rồi câu one-liner s3() — và khi nào nên chọn cách nào.
Dữ liệu nằm trong một S3 bucket công khai, nên không cần key hay credential nào — bạn chỉ cần trỏ tới URL. Quá trình truyền chạy phía server từ S3 sang ClickHouse, nên nó không đẩy 26.5 triệu dòng qua laptop của bạn và cũng không phụ thuộc vào Wi-Fi của địa điểm.
Bạn sẽ nạp cùng 26.5M tick đó theo hai cách khác nhau để thấy được cả hai. Cách 1 là
ClickPipes, pipeline được quản lý và thao tác bằng click mà bạn sẽ dùng trong production. Cách 2
là một dòng SQL duy nhất — cách nhanh nhất để đưa dữ liệu vào khi demo. Hãy làm theo thứ tự; một
câu TRUNCATE ở giữa giúp số dòng không bị nhân đôi.
Cách 1 — ClickPipes, cách được quản lý dùng cho production
ClickPipes là một dịch vụ nạp dữ liệu được quản lý hoàn toàn: trỏ nó vào object storage hoặc một stream và nó sẽ liên tục nạp dữ liệu, không cần tự viết connector. Đây là toàn bộ luồng.
- Trong menu bên trái, click Data sources, rồi nhấn nút Create ClickPipe.
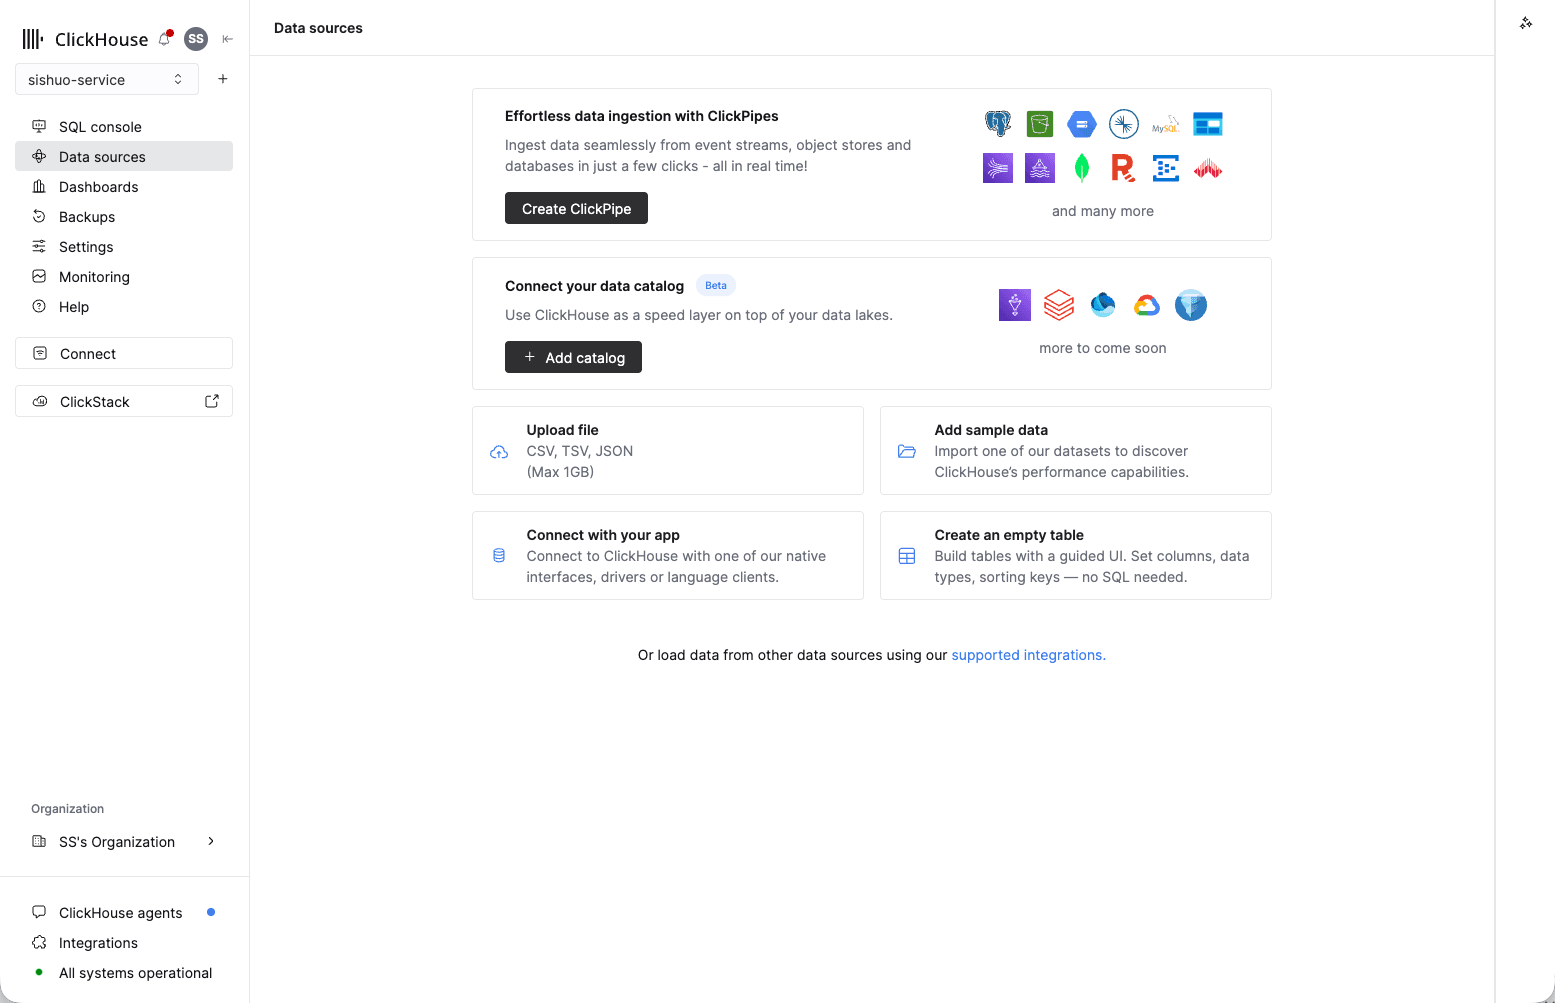
Data sources cũng là nơi có "Upload file" và "Add sample data".
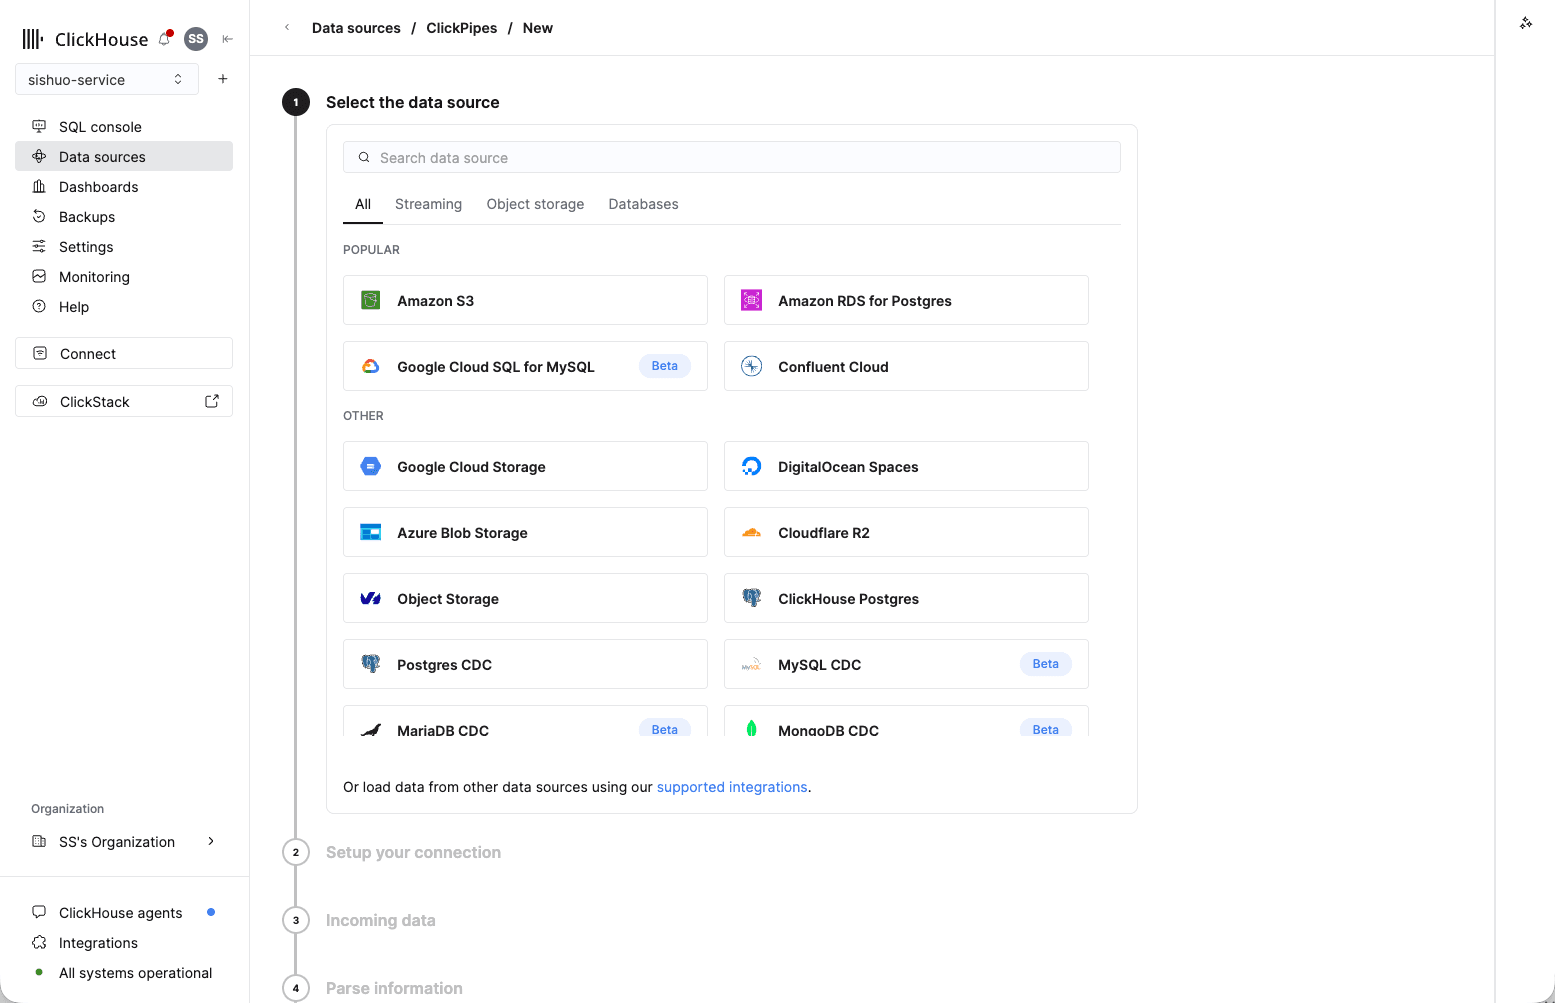
- Ở phần Select the data source, chọn Amazon S3 (đầu danh sách Popular).
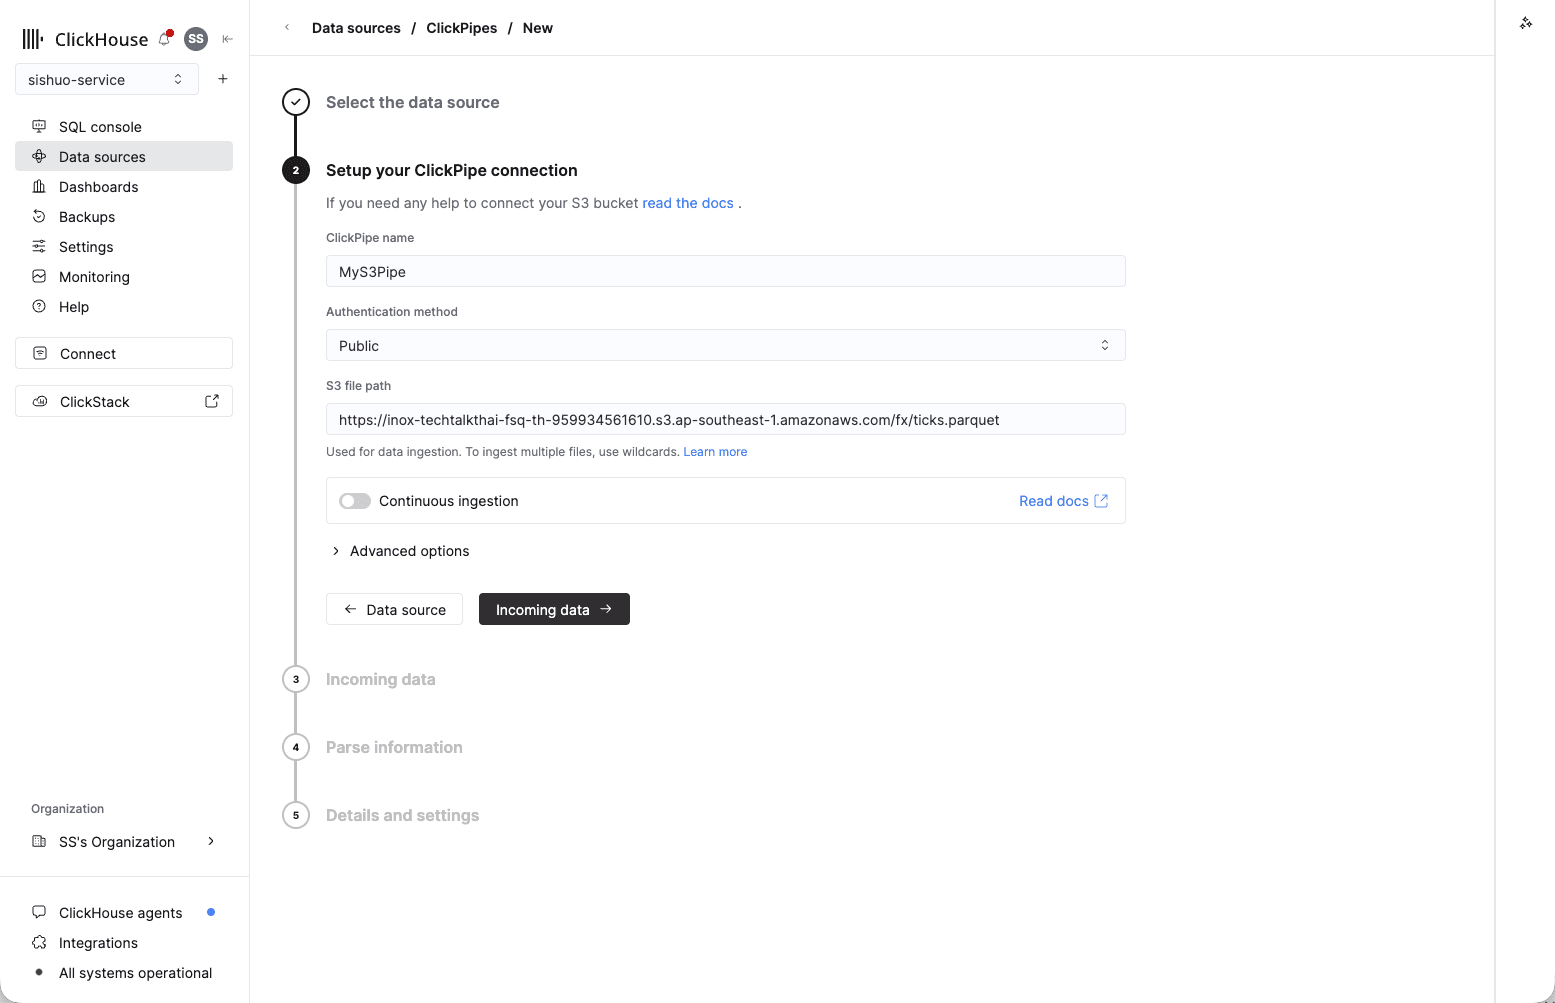
- Tại Setup your ClickPipe connection, đặt name bất kỳ, chọn Authentication method → Public (bucket này là công khai), và dán đoạn sau vào S3 file path:
https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquetĐể Continuous ingestion ở trạng thái tắt — đây là một file dùng một lần — rồi click Incoming data →.
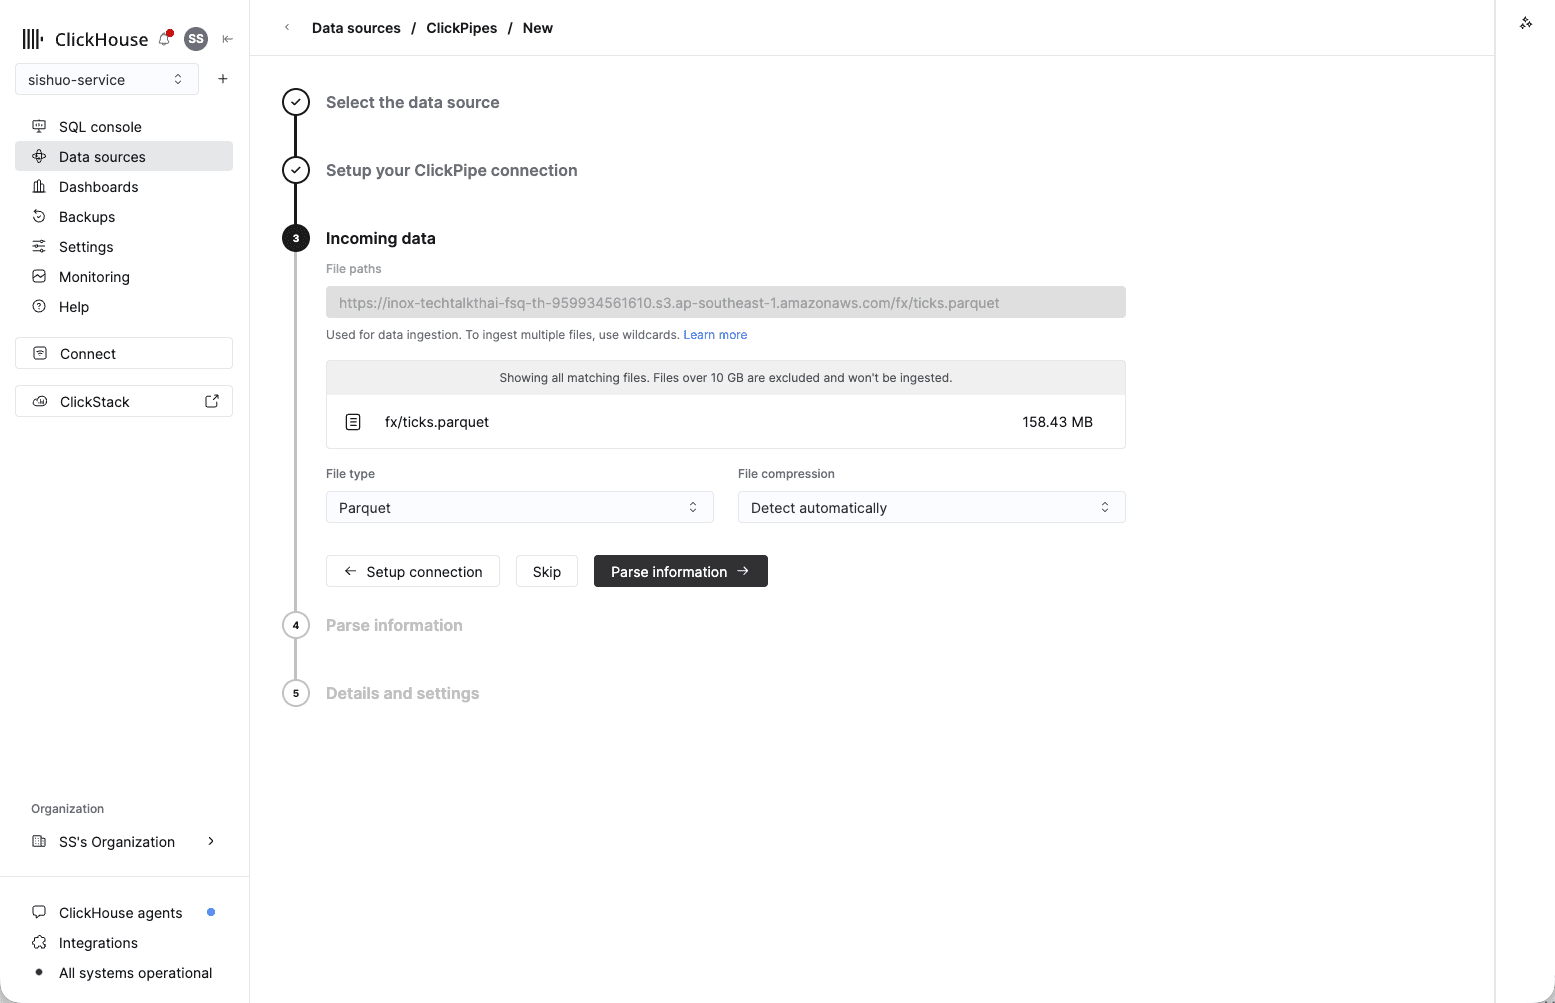
- Ở bước Incoming data, ClickHouse xem trước file khớp — bạn sẽ thấy
fx/ticks.parquetvới dung lượng 158.43 MB. Xác nhận File type → Parquet, để phần nén ở Detect automatically, rồi click Parse information →.
- Ở bước Parse information, ClickHouse xem trước một dòng mẫu và tự nhận diện các cột. Trong
phần Upload data to, chọn Existing table, chọn Database chứa bảng của bạn (thường
là
default), và đặt Table →forex. Kiểm tra rằng các field nguồn (datetime,bid,ask,base,quote) khớp với các cột tương ứng — chúng sẽ tự map. Để các field thừa_path/_file/_sizekhông map vào đâu. Rồi click Details and settings →.
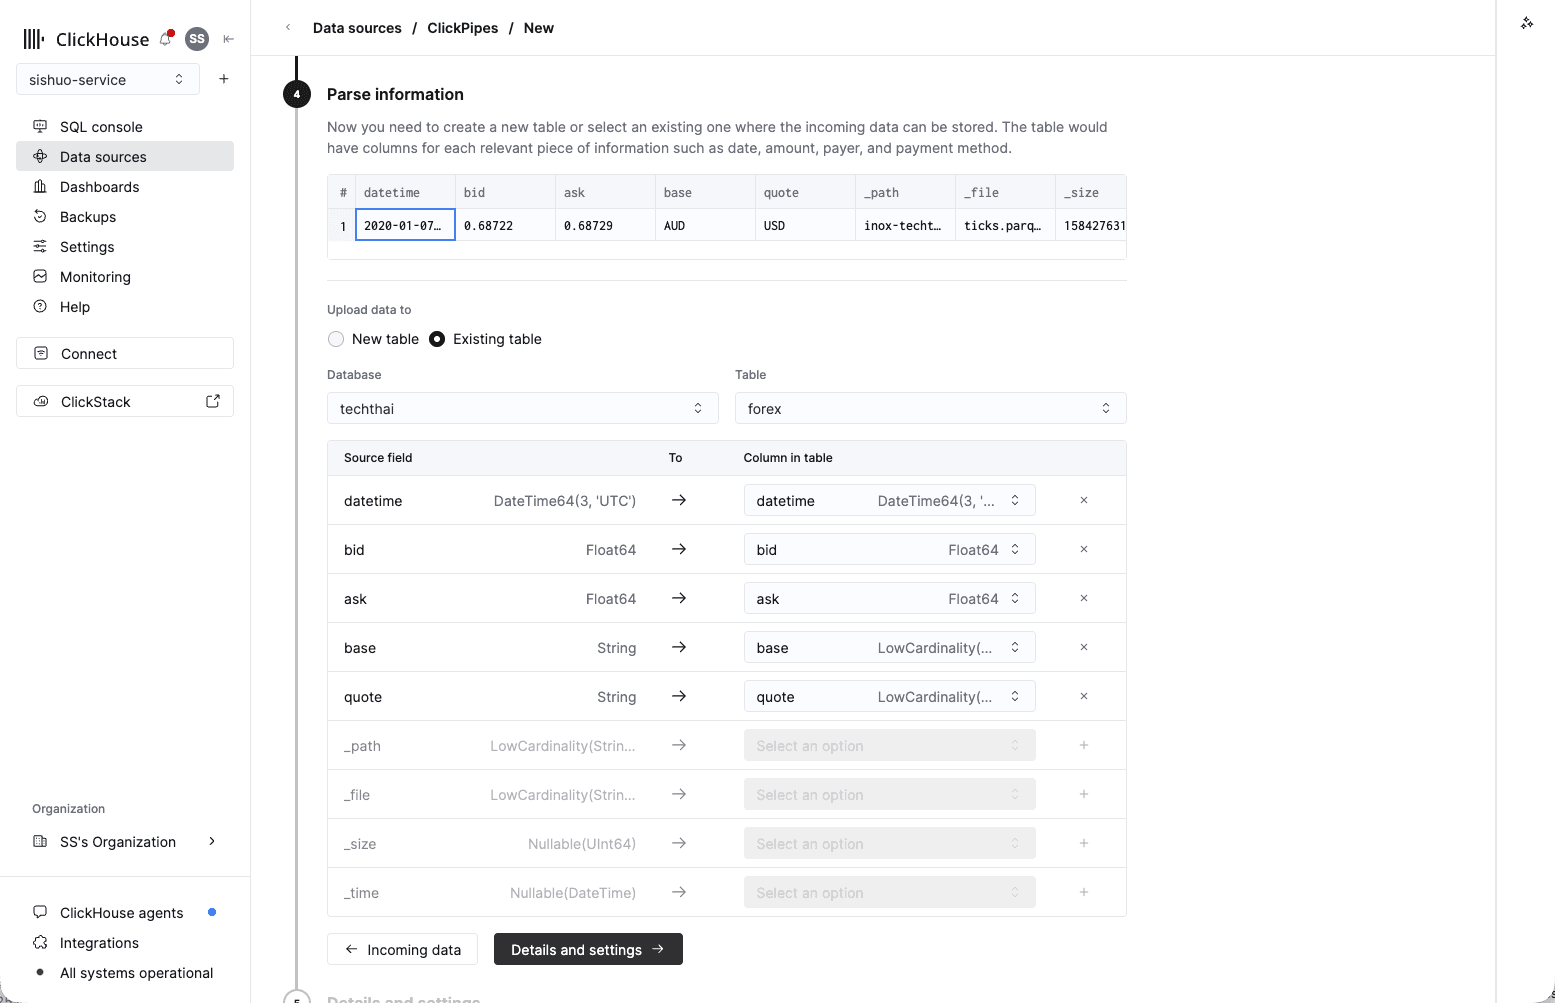
Ảnh chụp cho thấy database techthai của người trình bày — hãy dùng database nào đang chứa bảng của bạn.
- Ở bước Details and settings, để nguyên phần Permissions mặc định (ClickPipes tự tạo một user ghi riêng cho bạn), rồi click Create ClickPipe.
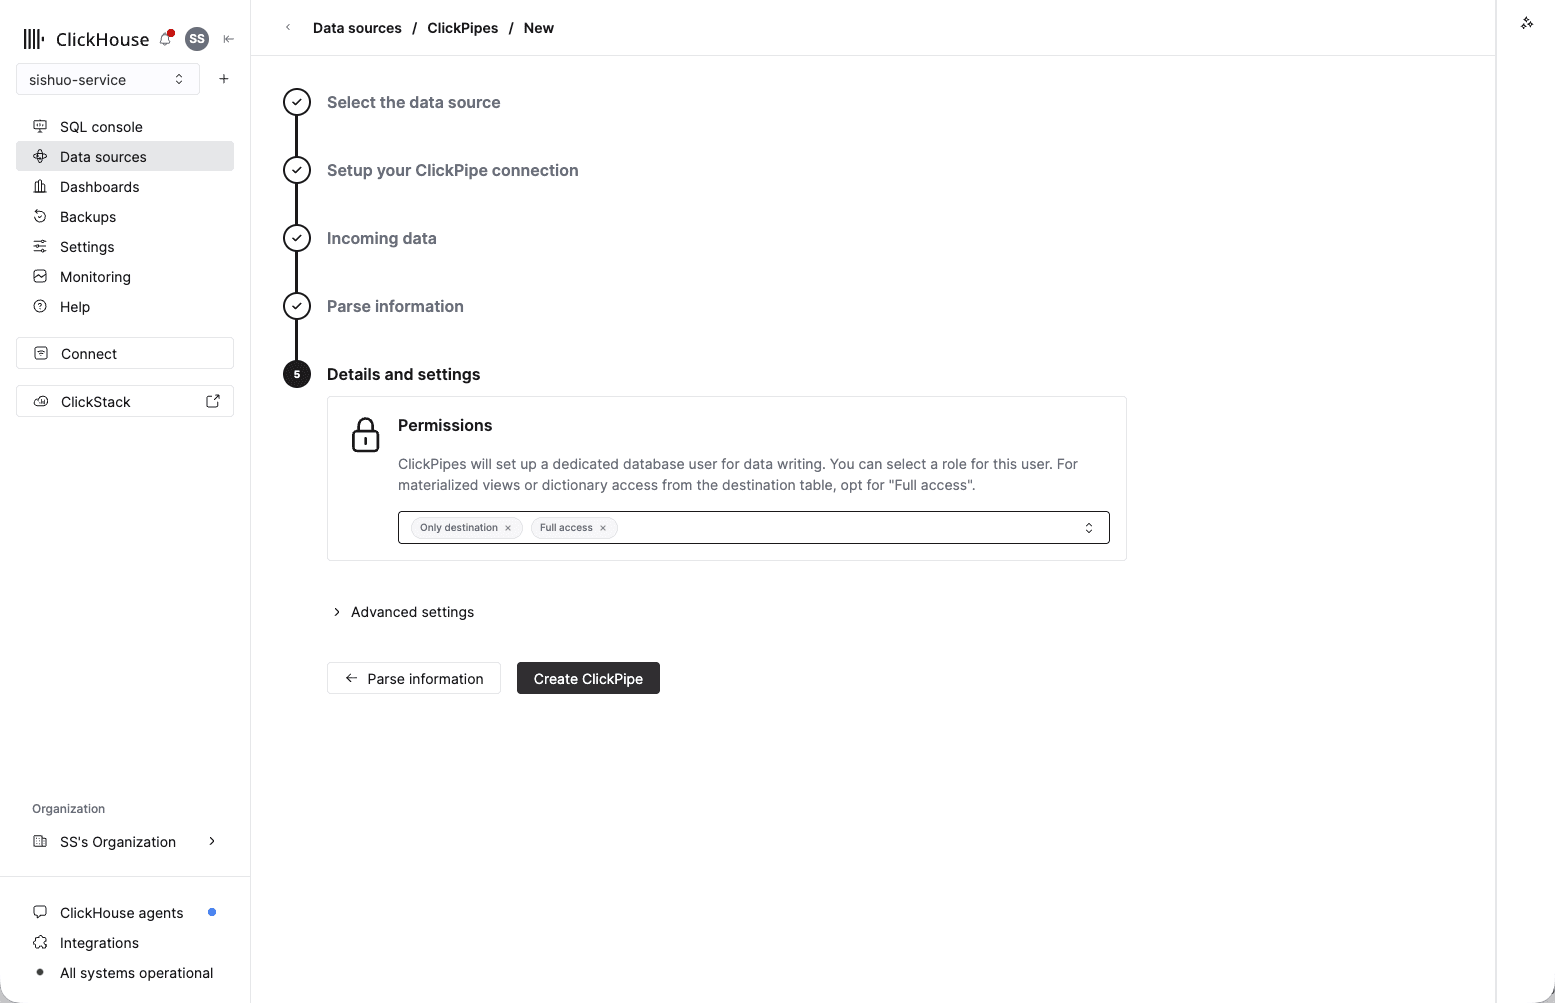
Không cần Spark job, không cần loader tự viết.
- Bạn được đưa về Data sources, nơi ClickPipe của bạn xuất hiện. Sau vài giây, Status chuyển sang Completed và Records hiển thị 26,488,218 — toàn bộ tick đã được nạp từ object storage.
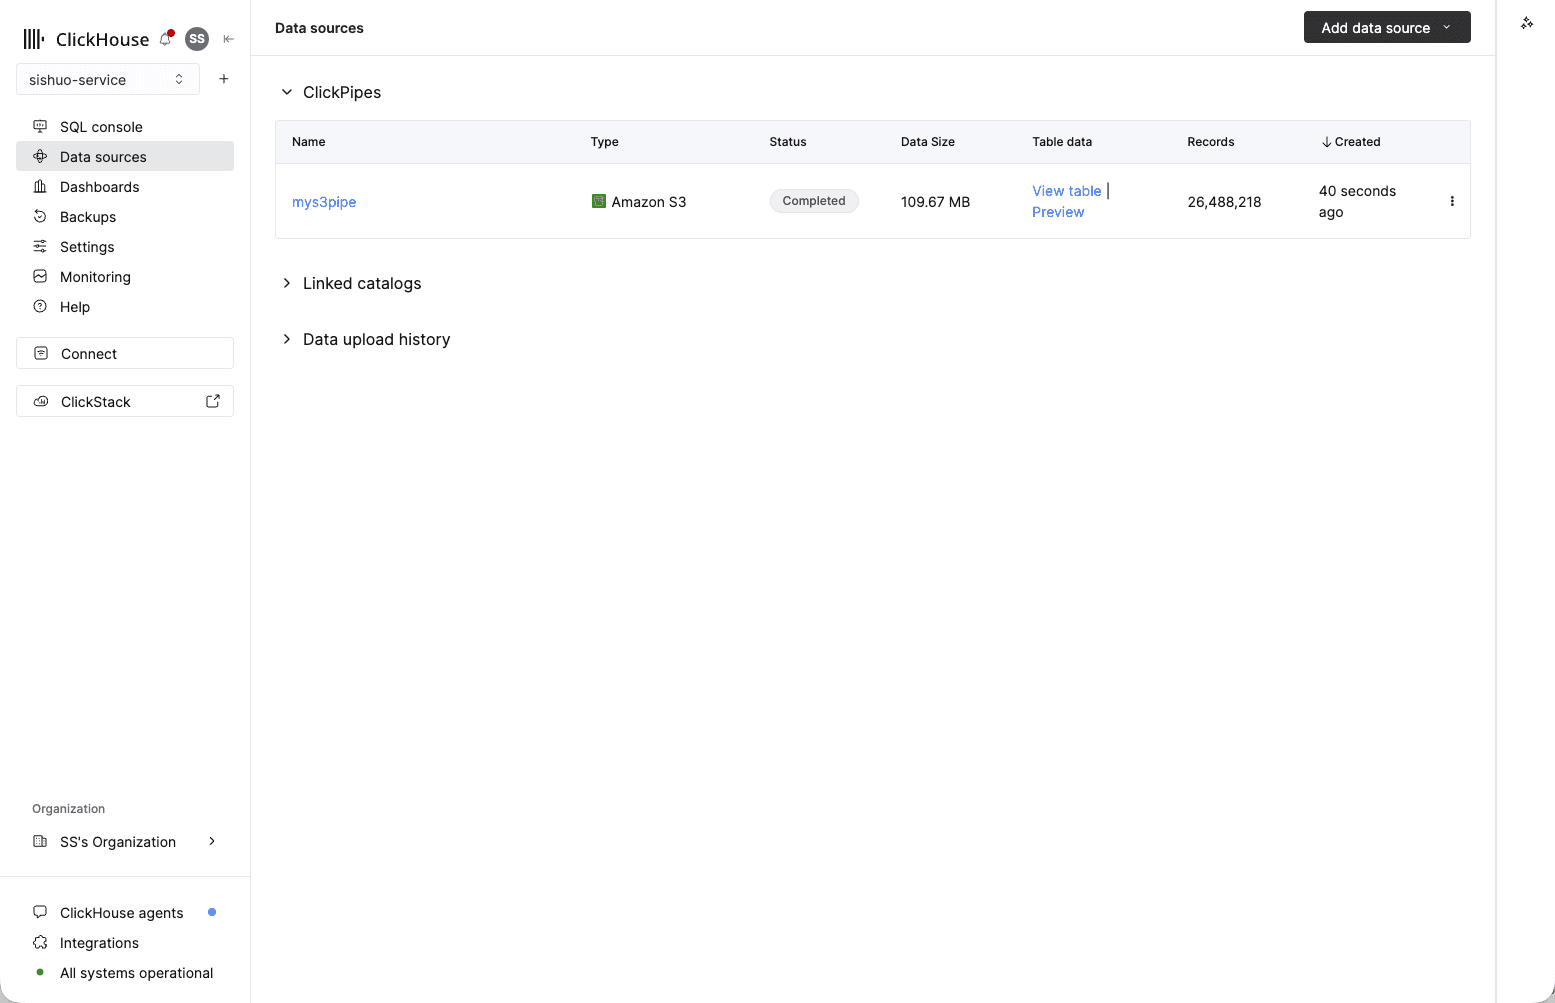
Kiểm tra xem đã nạp được gì. Chạy câu này trong SQL Console:
-- expect 26,488,218 ticks across 12 pairs
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;
Bạn sẽ thấy
ticks = 26,488,218 và pairs = 12. Đó là ~26.5 triệu dòng được nạp từ object storage chỉ trong vài giây.
Cách 2 — câu one-liner s3(), nhanh nhất khi demo
Giờ hãy nạp đúng dữ liệu đó bằng một câu lệnh SQL duy nhất, trực tiếp từ file công khai. Trước tiên hãy làm trống bảng để số dòng không bị nhân đôi, rồi insert:
-- clear the rows ClickPipes just loaded so we don't double up
TRUNCATE TABLE forex;

-- load all ~26.5M ticks from the public S3 file in one line (server-side)
INSERT INTO forex
SELECT * FROM s3('https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquet', NOSIGN, 'Parquet');

-- and check again (expect 26,488,218)
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;
NOSIGN có nghĩa là "không dùng credential" — chỉ cần vậy là đọc được một bucket công khai.
SELECT * hoạt động ngay vì thứ tự cột của bảng khớp với file.
ClickPipes so với hàm s3() — khi nào dùng cái nào
Cùng 26,488,218 dòng, nạp theo hai cách. Khác biệt nằm ở chuyện xảy ra sau lần nạp đầu tiên — bạn muốn một pipeline liên tục được quản lý, hay chỉ một lần đọc nhanh gọn.
| ClickPipes | Hàm bảng s3() | |
|---|---|---|
| Nó là gì | Một dịch vụ nạp dữ liệu được quản lý hoàn toàn, thiết lập trong console | Một hàm SQL bạn gọi trực tiếp trong truy vấn |
| Phù hợp nhất cho | Production và các tác vụ nạp liên tục mà bạn muốn cài rồi quên | Nạp nhanh một lần, khám phá tùy hứng, script |
| File mới / liên tục | Có thể theo dõi liên tục một bucket hoặc stream và nạp dữ liệu mới không ngừng | Một lần — mỗi lần chạy chỉ đọc những gì đang có |
| Thiết lập | UI hướng dẫn từng bước, không cần SQL | Một câu INSERT … SELECT duy nhất |
| Giám sát và retry | Có sẵn — trạng thái, xử lý lỗi và retry ngay trong console | Không có — bạn tự chạy lại nếu thất bại |
| Nguồn dữ liệu | Rất nhiều: S3, GCS, Azure, Kafka và các stream khác, CDC từ Postgres/MySQL, và hơn nữa | Chỉ object storage (các hàm cùng họ: gcs(), azureBlobStorage(), url()) |
Nguyên tắc chung: chọn ClickPipes khi dữ liệu liên tục đổ về và bạn muốn nó được quản lý;
chọn s3() khi bạn chỉ cần kéo một file vào ngay lúc này. Hôm nay bạn dùng câu one-liner để
truy vấn được thật nhanh — giờ hãy truy vấn nó.
02 Tạo bảng
Một câu CREATE TABLE cho 26.5M tick forex, và lý do base cùng quote đứng đầu sort key — quyết định mà bạn sẽ cảm nhận được ở module 04.
04 Chạy các truy vấn thị trường
Bảy truy vấn trên 26.5M tick, mỗi truy vấn thay thế cả một trang SQL: đếm gần đúng, topK, nến OHLC, phân vị, combinator -If, argMax, và màn kết về sort key.