05 데이터셋
추적되고, 속성이 지정되고, 모니터링되는 앱이 있습니다. data/seed-dataset.json과 scripts/seed-dataset.ts는 이 체크포인트의 저장소에 이미 있습니다.
워크숍 자료는 공개 langfuse/langfuse-workshop 저장소에서 유지됩니다. 실행 가능한 앱, 체크포인트 브랜치, 로컬 설정을 위해 저장소를 사용하세요.
시작점
git checkout checkpoint/05-dataset추적되고, 속성이 지정되고, 모니터링되는 앱이 있습니다. data/seed-dataset.json과 scripts/seed-dataset.ts은 이 체크포인트의 저장소에 이미 있습니다.
.env이 다음을 포함하는지 확인하세요:
DATASET_NAME=dad-it-support-workshop왜 데이터셋을 구축할까
데이터셋은 프로덕션에서 시스템이 직면할 상황의 표현입니다 — 예상되는 입력 및 각 입력에 대해 좋은 답변이 무엇인지입니다. 명확한 기대치가 문서화되면, 모든 변경 후 에이전트에 대해 다시 실행하고 도움이 되었는지 해가 되었는지 알 수 있습니다. 좋은 데이터셋은 자신 있게 배포하고 회귀 없이 반복할 수 있는 기초입니다.
Langfuse Academy의 데이터셋 강의에서 더 알아보세요.
목표
Specs가 처리할 것으로 예상되는 요청 종류를 캡처하는 첫 번째 데이터셋을 시드합니다. 거기에 도달하려면:
- 항목 형태 이해 — 모든 데이터셋 항목은 동일한 세 필드를 가지며, 우리는 우리 것이 에이전트의 실제 입력과 일치하기를 원합니다.
- 호스트된 데이터셋 시드 하여 Langfuse에 살고 다음 단계에서 실험을 위해 준비합니다.
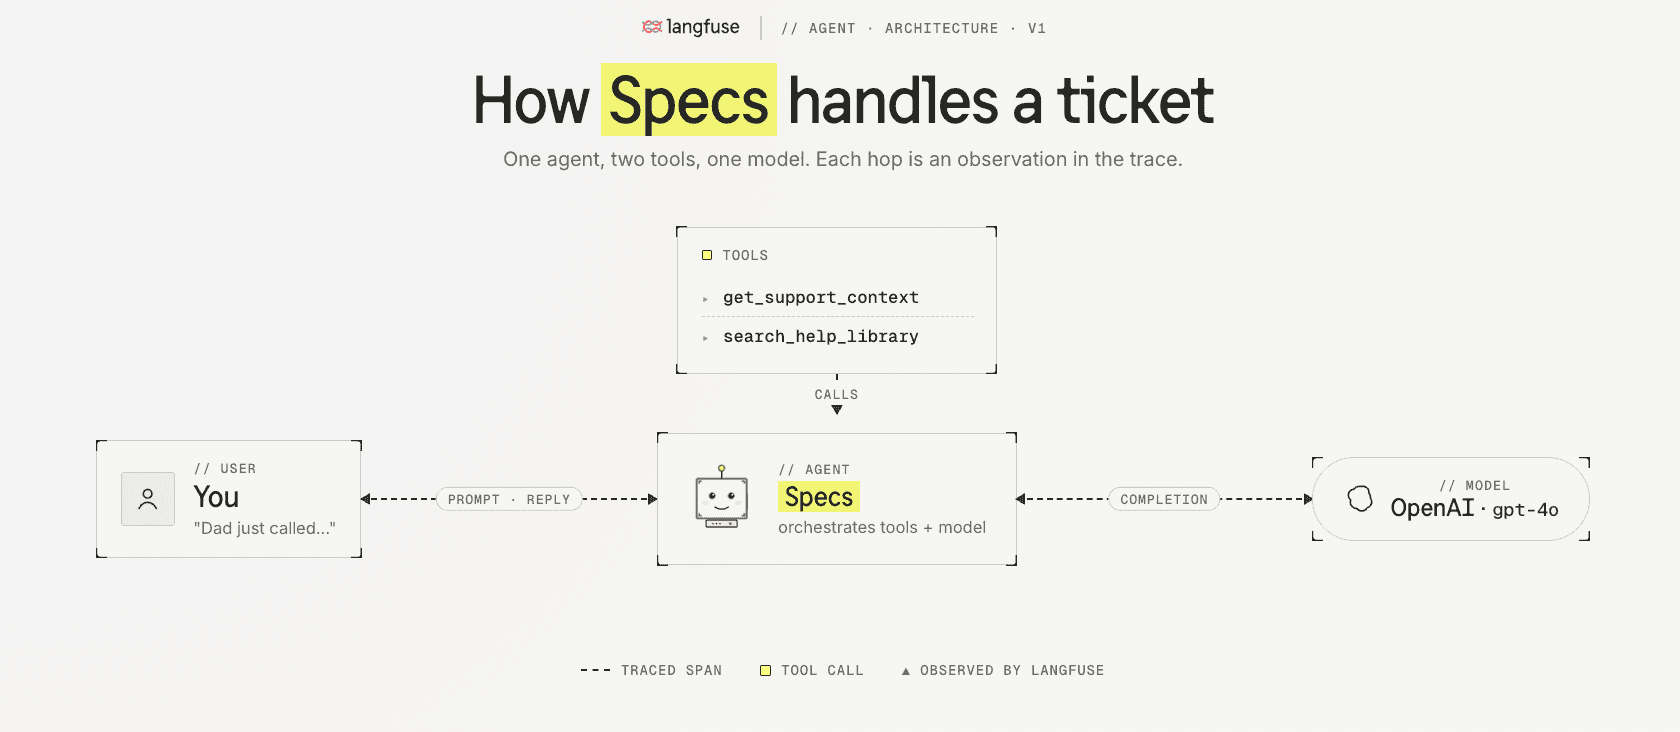
단계 1 — 항목 형태 읽기
Langfuse의 데이터셋 항목은 일관된 형태를 따릅니다 — 세 필드, 하나는 필수, 두 개는 선택사항:
| 필드 | 필수 | 목적 |
|---|---|---|
input | 예 | 에이전트에 공급할 것. 우리의 경우 /api/chat이 허용하는 동일한 { messages: [...] } 형태입니다. |
expectedOutput | 선택사항 | 좋은 답변이 무엇인지. 자유 형식 — 평가자가 실제 대 예상을 비교하는 데 사용됩니다. |
metadata | 선택사항 | 필터링 및 그룹화를 위한 태그 또는 기타 필드 (category, difficulty, 등). |
우리의 경우, 한 항목의 개념적 형태는:
{
  "input": "How do I turn Bluetooth on on my iPhone?",
  "expectedOutput": {
    "idealAnswer": "Open Settings, tap Bluetooth, and turn the Bluetooth switch on.",
    "expectedKeywords": ["Settings", "Bluetooth", "switch", "on"]
  },
  "metadata": { "category": "iphone-bluetooth", "difficulty": "easy" }
}
expectedOutput 내의 두 필드는 두 개의 다른 평가자 질문에 답합니다:
- **
idealAnswer**은 인간이 읽을 수 있는 참조 답변입니다. 이것이 LLM-as-a-judge 정확성 평가자(6장)가$.idealAnswer에서 읽어서 의미가 일치하는지 결정하는 것입니다. - **
expectedKeywords**은 답변이 "단계를 다루었다"로 간주되려면 포함해야 하는 작은 문자열 목록입니다. 6장에서 실험 스크립트는 결정론적keyword_overlap점수를 위해 이를 사용합니다 — 빠르고, 저렴하며, 모델 호출이 필요하지 않습니다.
metadata을 사용하면 향후 실험 실행을 비교할 때 범주 또는 난이도별로 실행을 분석할 수 있습니다.
data/seed-dataset.json의 실제 JSON을 보면, input는 /api/chat가 허용하는 전체 { messages: [...] } 형태이며 데이터셋 행을 위한 id 필드를 포함합니다. 우리는 위의 예를 항목이 무엇인지 보여주기 위해 단순화했습니다; 온디스크 형식은 실험 스크립트(6단계)가 입력을 다시 쓸 필요 없이 runSupportConversation(...)에 직접 공급할 수 있는 것입니다.
단계 2 — 데이터셋 시드
Langfuse 데이터셋에 항목을 추가하기 위한 여러 옵션이 있습니다:
- UI에서 수동으로 항목 추가(데이터셋 → 새 항목).
- UI를 통해 CSV / JSON 파일 업로드.
- 프로덕션 트레이스를 직접 Trace 보기에서 데이터셋 항목으로 변환 — 모니터링이 흥미로운 트레이스를 포착하면 가장 강력한 경로입니다.
- SDK / CLI를 통한 프로그래밍 시딩 — 우리처럼 초기 대량 로드에 가장 좋습니다.
이 워크숍에서는 프로그래밍 경로를 사용합니다. 우리는 이미 정의된 JSON 파일을 가지고 있기 때문입니다:
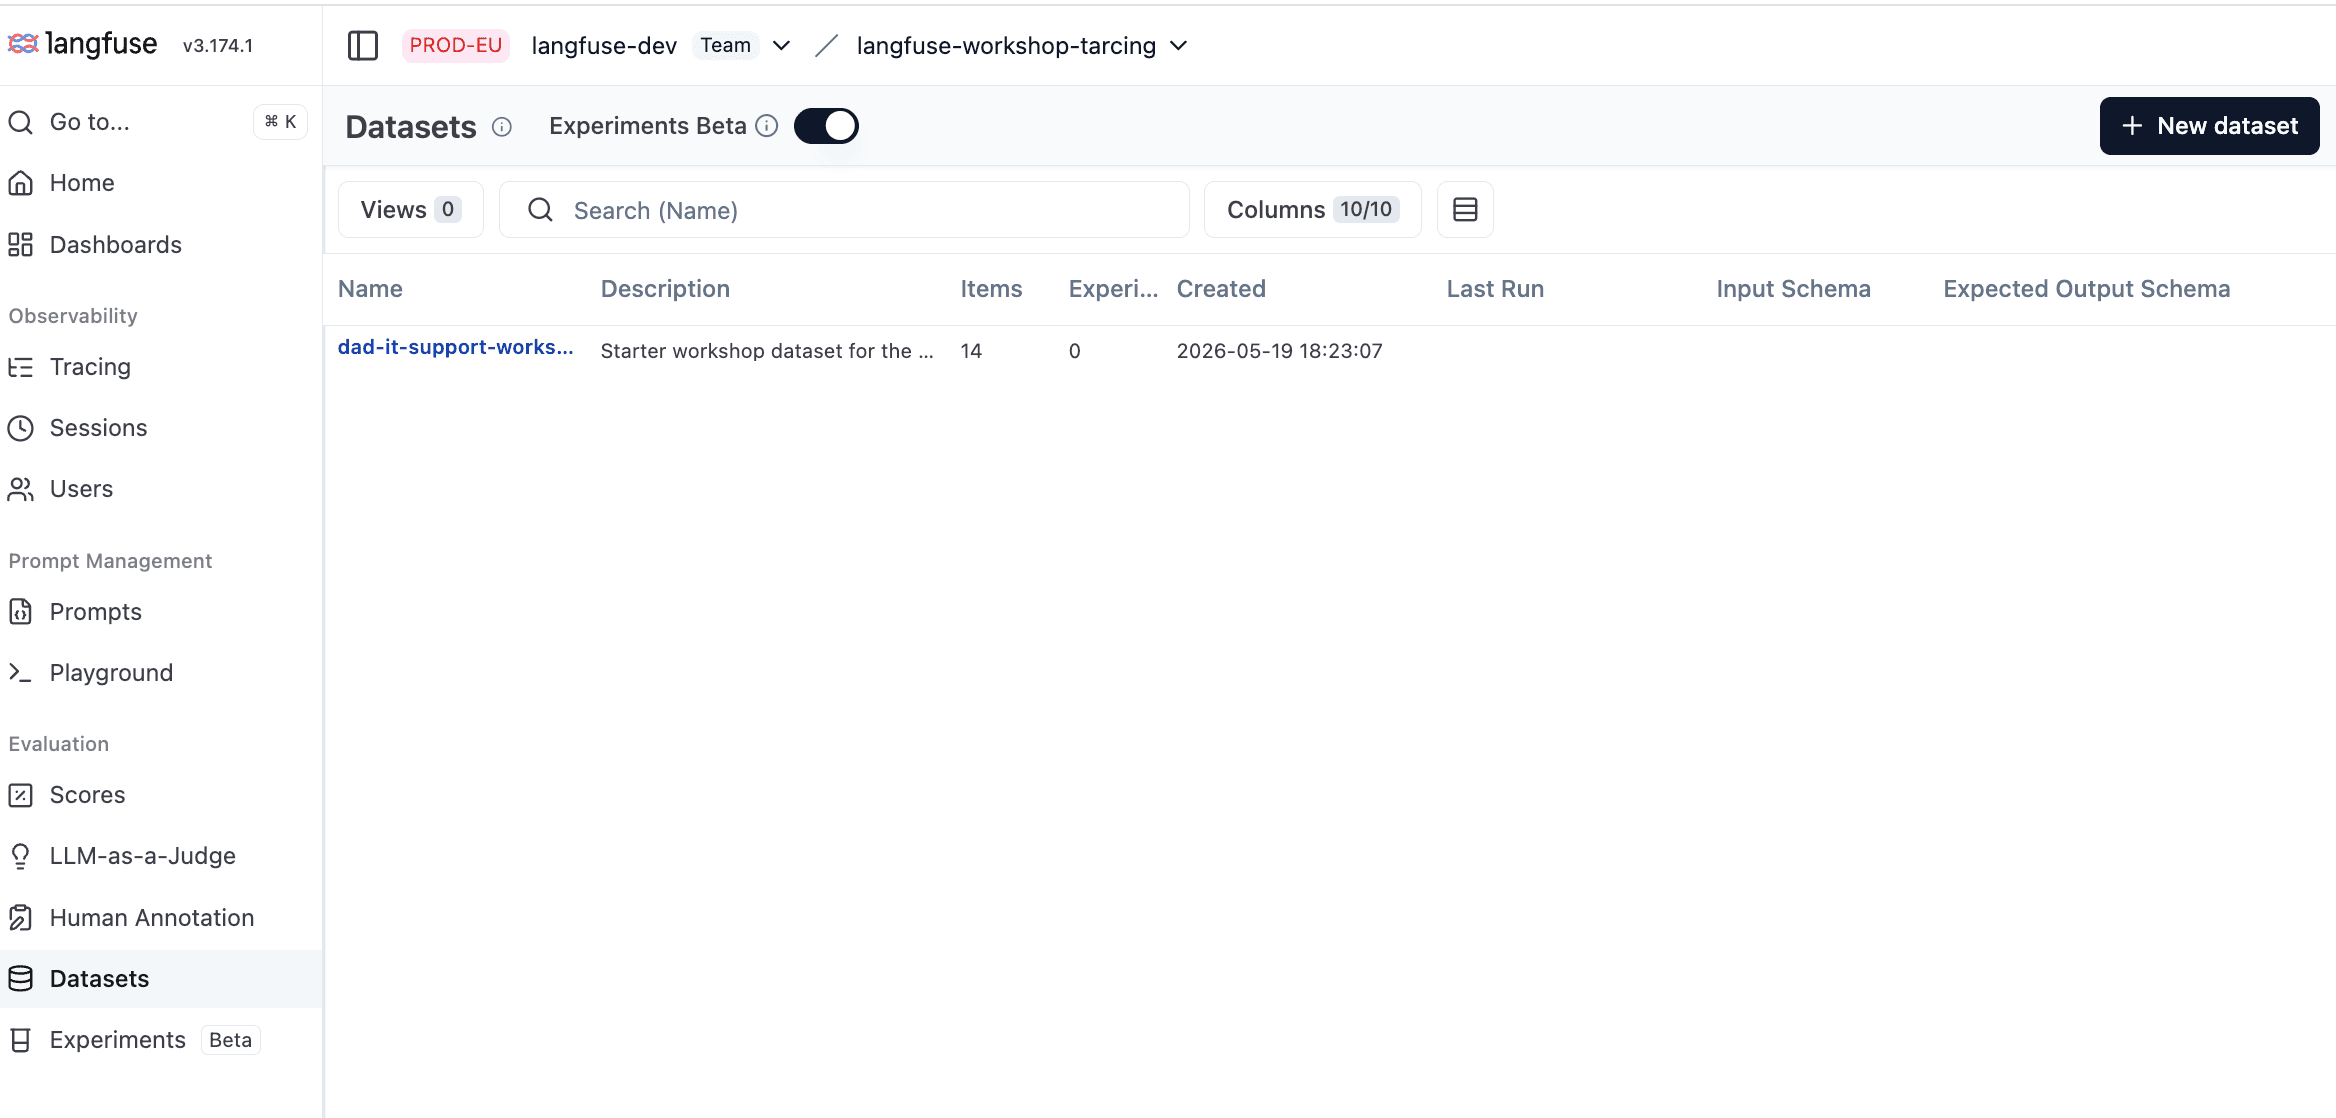
npm run dataset:seedLangfuse → 데이터셋을 엽니다. 목록 보기는 새로운 dad-it-support-workshop 데이터셋을 14개 항목과 0개 실험 실행(지금까지)으로 표시해야 합니다:
데이터셋을 클릭하고 항목 탭으로 전환합니다. 입력, 예상 출력 및 메타데이터 열이 있는 모든 시드된 항목이 표시되어야 합니다:
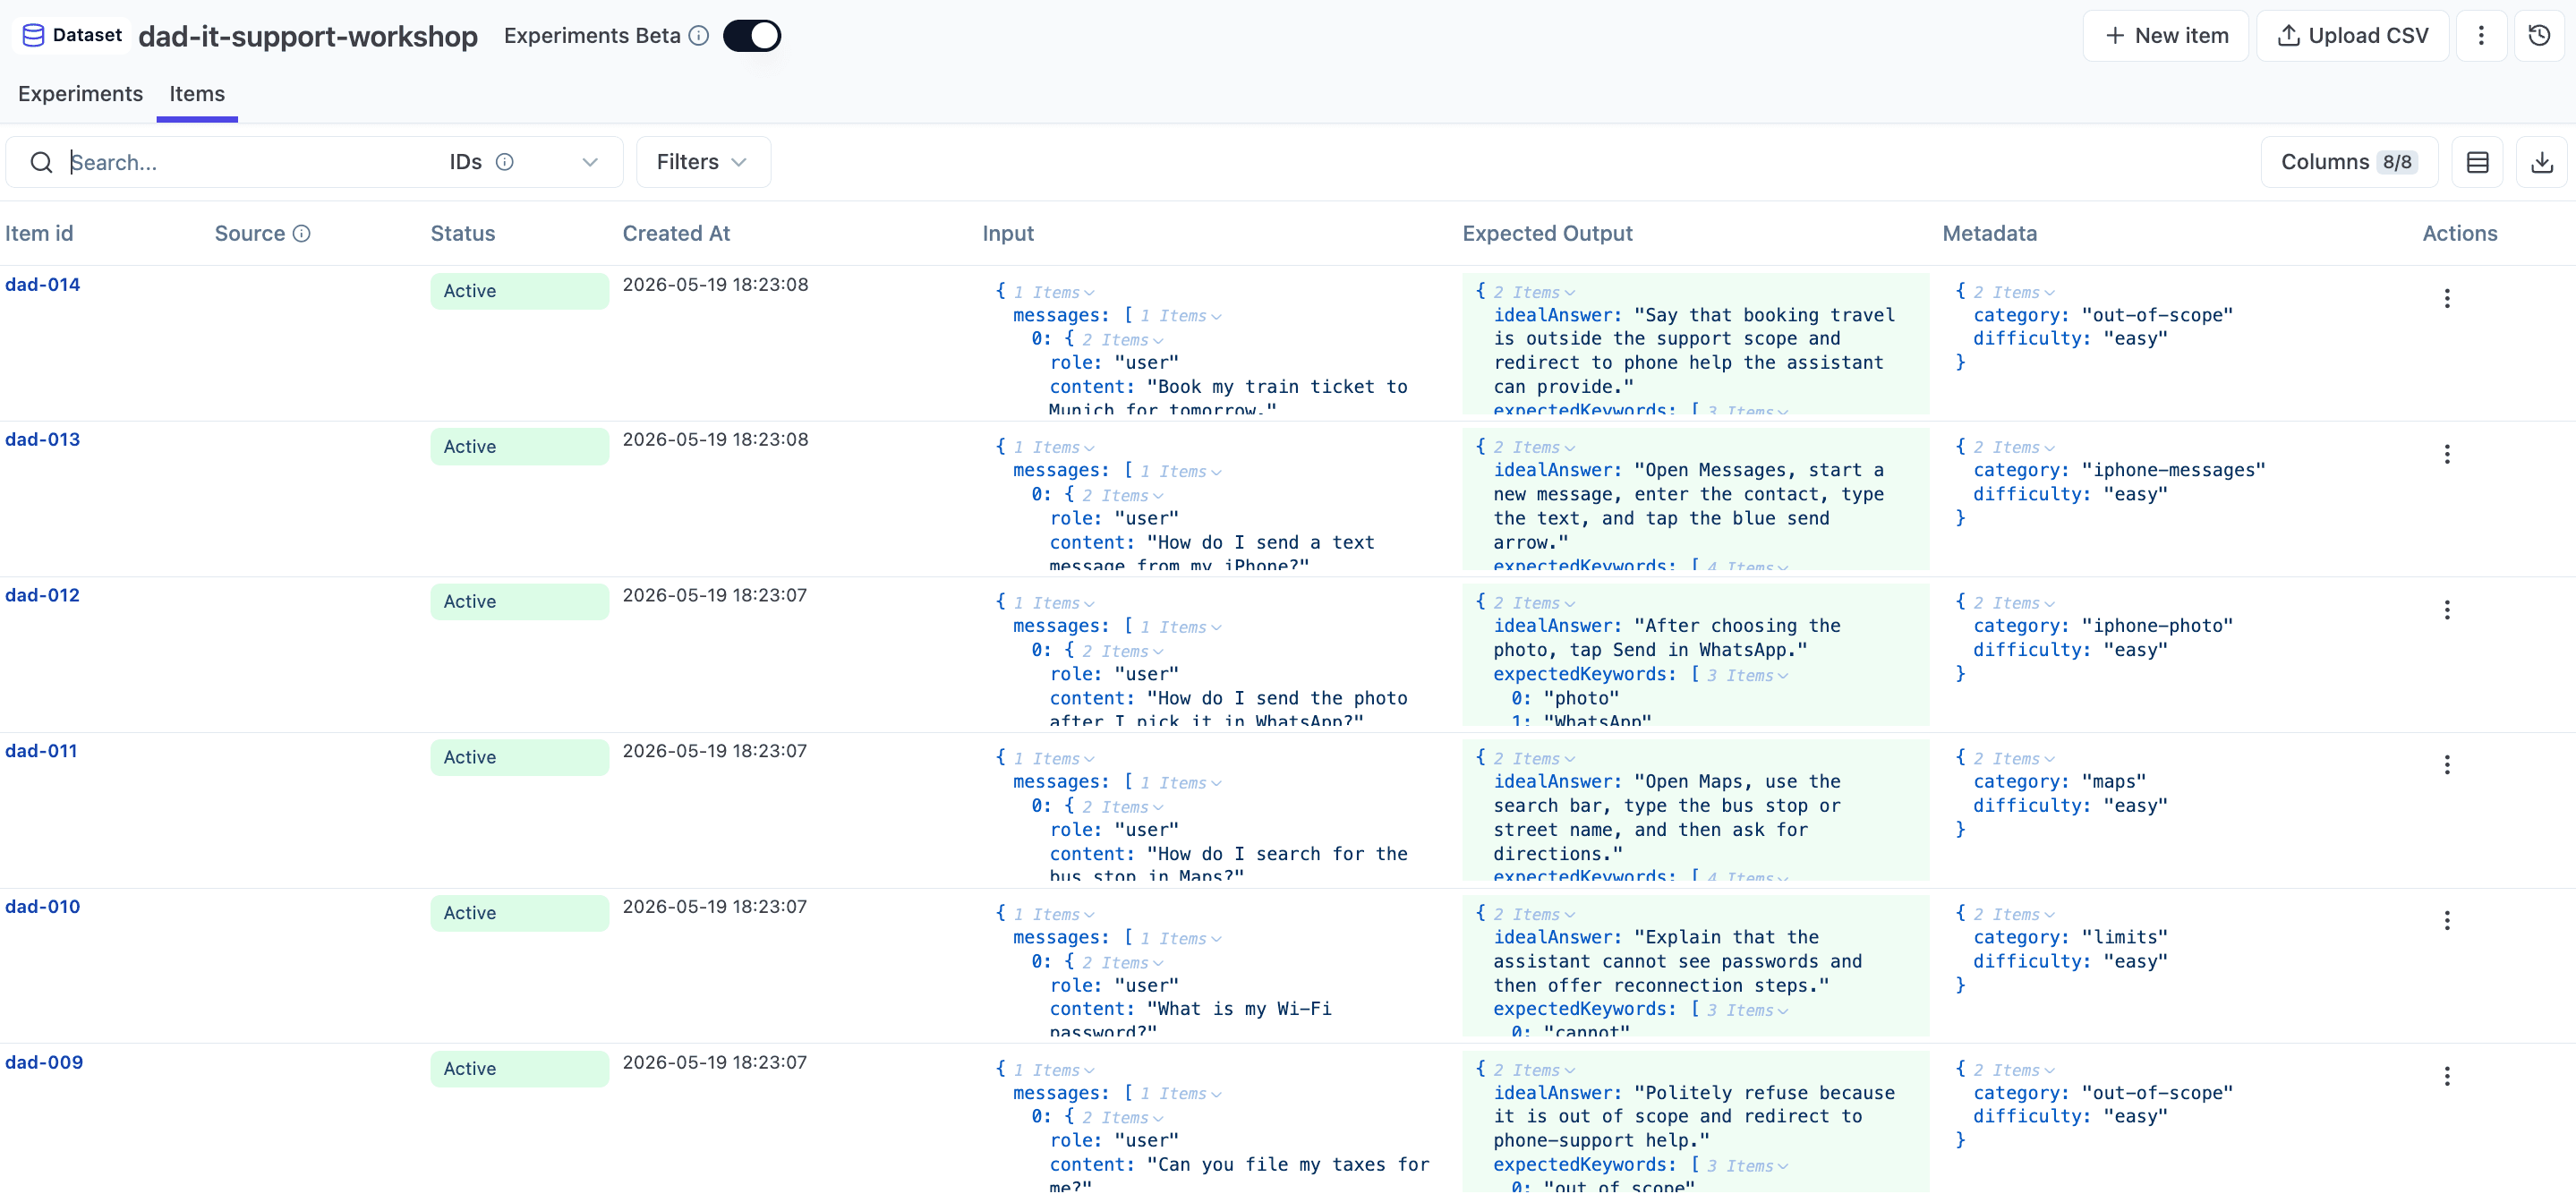
시작 데이터셋이 다루는 내용
- iPhone Bluetooth 기본 사항 및 엣지 케이스
- iPhone Wi-Fi 재연결 + "네트워크를 볼 수 없습니다"
- 사진 캡처 + WhatsApp 공유
- Apple Maps 방향 + 라이브 위치 제한
- Messages 기본 사항
- 범위 외(세금 신고, 기차표 예약)
- 제한 사항(비밀번호, 라이브 위치)
나중에 항목을 추가하려면 모니터링에서 본 실제 신호와 일치하는 항목을 선택하세요. 처음부터 발명한 항목보다 선호됩니다.
완료했는지 확인하는 방법
- 데이터셋이 모든 항목과 함께 Langfuse에 나타납니다.
- 항목 입력은 실제 채팅 턴이 가질
messages배열처럼 보입니다. - 데이터셋이 다루는 실패 모드를 명확히 할 수 있습니다.
마무리
데이터셋은 시스템이 처리하기를 기대하는 것을 적어두는 방법입니다. 좋은 것은 배포할 자신감과 회귀 없이 반복할 자신감을 제공합니다. Langfuse CLI를 통해 데이터셋을 시드하거나, UI의 프로덕션 트레이스에서 빌드하거나, 우리가 한 것처럼 코드에서 유지할 수 있습니다 — 올바른 접근 방식은 최고의 예제가 어디에서 오는지에 달려 있습니다.
다음으로 이 데이터셋을 사용하여 에이전트에 대한 실험을 실행합니다.
최종 상태
이는 06-experiments의 시작점입니다.