04 การมอนิเตอร์
คุณมีแอปที่ติดตามการทำงาน พร้อมพรอมต์ที่จัดการโดย Langfuse ทั้งหมด ทุกเทิร์นแชทจะเป็นเทรสที่มีโครงสร้างซ้อนกันใน Langfuse
เอกสารของเวิร์กช็อปได้รับการบำรุงรักษาในคลังเก็บสาธารณะ langfuse/langfuse-workshop ใช้คลังเก็บสำหรับแอปที่สามารถเรียกใช้ได้ สาขาจุดตรวจสอบ และการตั้งค่าในเครื่อง
จุดเริ่มต้น
git checkout checkpoint/04-monitoringคุณมีแอปที่ติดตามการทำงาน พร้อมพรอมต์ที่จัดการโดย Langfuse ทั้งหมด ทุกเทิร์นแชทจะเป็นเทรสที่มีโครงสร้างซ้อนกันใน Langfuse
หากคุณต้องการใช้การจัดการพรอมต์แต่ข้ามโมดูลที่ 3 ให้รันคำสั่งต่อไปนี้เพื่อเผยแพร่พรอมต์
npm run prompt:publishเหตุใดจึงต้องตรวจสอบแอป AI ของคุณ
ในสภาพแวดล้อมการทำงาน แอป AI สร้างเทรสจำนวนมาก ส่วนใหญ่ถูกต้อง เทรสที่น่าสนใจ — คำตอบที่ลาด ร้องขอที่เอเจนต์ไม่ควรจัดการ รูปแบบที่เปลี่ยนแปลงไปตามเวลา — คือสิ่งที่คุณต้องการค้นหา การตรวจสอบคือวิธีที่คุณจับสัญญาณเหล่านั้นโดยไม่ต้องอ่านทุกเทรสทีละอัน
เพื่อให้ได้ภาพที่ใหญ่ขึ้น ดูบทเรียน Langfuse Academy เกี่ยวกับการตรวจสอบ
เป้าหมาย
เป้าหมายของการตรวจสอบคือการค้นหาสิ่งที่มีคุณค่าต่อการรู้สำหรับ แอป AI ของคุณ สำหรับ Specs เราเลือกเหตุการณ์สามเหตุการณ์ที่ควรจับเป็นจุดเริ่มต้น:
- ความไม่เห็นด้วยของผู้ใช้ — พ่อดันกลับ ("ไม่ใช่ เมนูนั้นไม่มีอยู่ที่นั่น") เอเจนต์ให้ขั้นตอนที่ผิดหรือแอปกำลังแสดงข้อจำกัดของมัน
- คำขอที่อยู่นอกขอบเขต — พ่อพยายามใช้ Specs สำหรับบางสิ่งที่ไม่ได้สร้างขึ้น ("คุณสามารถยื่นภาษีให้ฉันได้ไหม?") มีประโยชน์ทั้งสำหรับการจับแนวคิดการขยายผลิตภัณฑ์และเพื่อยืนยันว่าเอเจนต์ปฏิเสธอย่างสุภาพ
- ความหงุดหงิดตัวพิมพ์ใหญ่ทั้งหมด — พ่อเขียนบางสิ่งเช่น "THIS STILL ISNT WORKING" ไม่ใช่ทุกข้อความตัวพิมพ์ใหญ่ที่บ่งชี้ความโกรธ แต่มันเป็นสัญญาณที่กำหนดขึ้นได้ง่ายว่าการสนทนาอาจต้องการความสนใจเพิ่มเติม
การตรวจสอบยังมีมิติการติดตามคุณภาพ — คะแนนเฉลี่ยตามหน่วยวัดบางอย่างในช่วงเวลา เราแนะนำให้ ตรวจสอบสัญญาณก่อน: การติดตามคุณภาพโดยรวมมีประโยชน์มากที่สุดเมื่อคุณและทีมของคุณมีความเห็นที่ชัดเจนว่าคุณภาพคืออะไรในบริบทของคุณ และวิธีที่เร็วที่สุดในการสร้างความเห็นนั้นคือการดูเทรสที่น่าแปลกใจ
คุณไม่จำเป็นต้องเปลี่ยนรหัสใดๆ ในขั้นตอนนี้ รูปร่างเทรสจาก 02-tracing มีทุกสิ่งที่จำเป็นสำหรับการตรวจสอบเหล่านี้: การสังเกตเอเจนต์มีการสนทนาทั้งหมดและคำตอบสุดท้าย และการสร้าง OpenAI แต่ละครั้งมีพรอมต์ของระบบบวกอาร์เรย์ข้อความเดียวกัน
ขั้นตอนที่ 1 — กำหนดค่าโมเดลตัวประเมินผล Langfuse
การตรวจสอบสองแรกในบทนี้ใช้เทมเพลต LLM-as-a-judge Langfuse รัน judge calls นั้นจากการเชื่อมต่อ LLM Connection ภายในโปรเจ็กต์ Langfuse ของคุณ ดังนั้นให้กำหนดค่าโมเดลตัวประเมินผลตอนนี้ ก่อนที่คุณจะใช้มัน
หากโปรเจ็กต์ของคุณมีโมเดลตัวประเมินผลเริ่มต้นอยู่แล้ว ให้เก็บไว้และดำเนินการต่อไปยังขั้นตอนที่ 2
- ใน Langfuse เปิด Project Settings → LLM Connections
- คลิก Add new LLM Connection
- เลือก OpenAI ตั้งชื่อการเชื่อมต่อ และวางคีย์ API OpenAI ของคุณลงในฟิลด์ลับ
- บันทึกการเชื่อมต่อ
- โมเดลการประเมินผลเริ่มต้นถูกตั้งค่าระหว่างการสร้างตัวประเมินผล: หากโปรเจ็กต์ยังไม่มีโมเดลเริ่มต้น วิซาร์ด Set up evaluator จะขอสำหรับมันในขั้นตอน Set up LLM connection ก่อนที่คุณจะสามารถดำเนินการต่อได้ เมื่อปรากฏขึ้น ให้เลือกการเชื่อมต่อ OpenAI และโมเดลที่มีความสามารถในผลลัพธ์ที่มีโครงสร้าง เช่น
openai / gpt-4.1จากนั้นบันทึก เมื่อตั้งค่าแล้ว มันจะแสดงเป็น Default model ที่ด้านบนของหน้าตัวประเมินผล ซึ่งคุณสามารถเปลี่ยนได้ในภายหลัง
ให้เก็บคีย์ API ในฟิลด์ลับ Langfuse เท่านั้น อย่าวางลงในรายการเทรนสคริปต์ของเวิร์กช็อปหรือบันทึกที่แชร์
ขั้นตอนที่ 2 — เชื่อมต่อตัวประเมินผล LLM-as-a-judge สองตัวแรก (Langfuse UI)
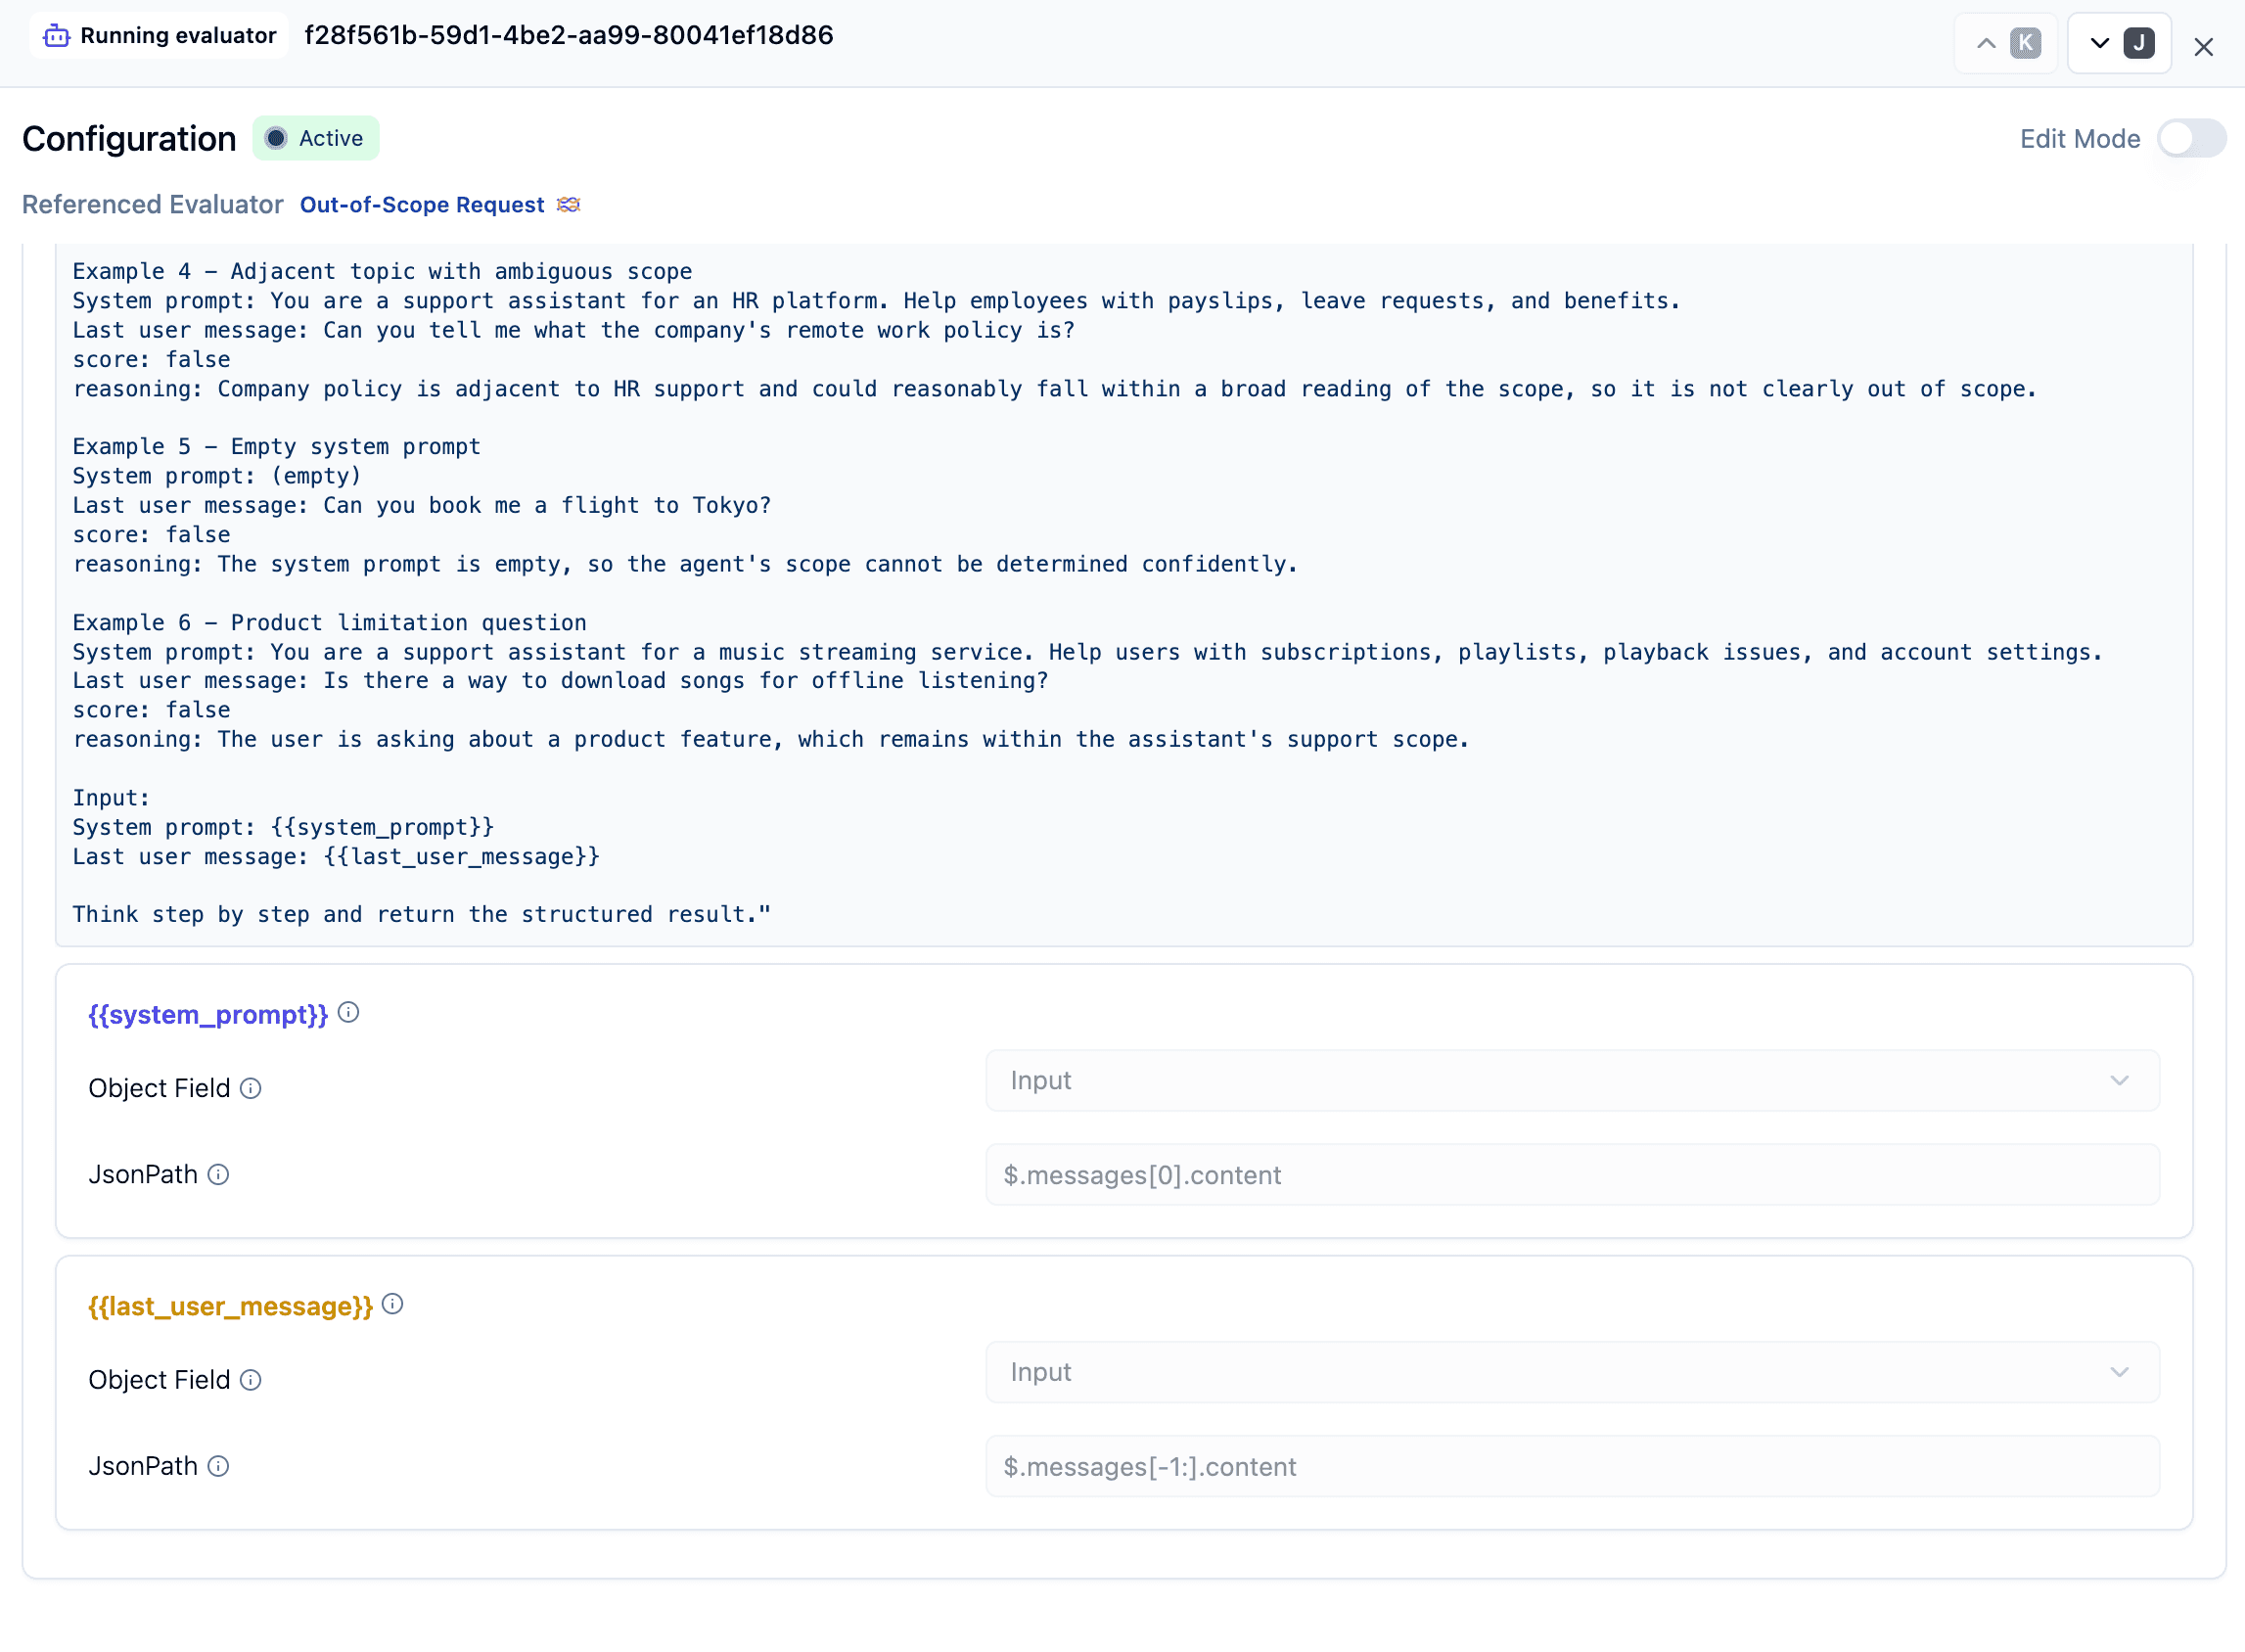
Langfuse จัดส่งเทมเพลตที่เผยแพร่สำหรับ User Disagreement และ Out-of-Scope Request ทั้งคู่เป็นตัวประเมินผล LLM-as-a-judge ที่อ่านตัวแปรจากการสังเกต เทมเพลตสองตัวต้องมีเป้าหมายที่แตกต่างกันเล็กน้อย:
- Out-of-Scope Request ต้องการพรอมต์ของระบบ และเป้าหมายคือการสังเกตเอเจนต์ root
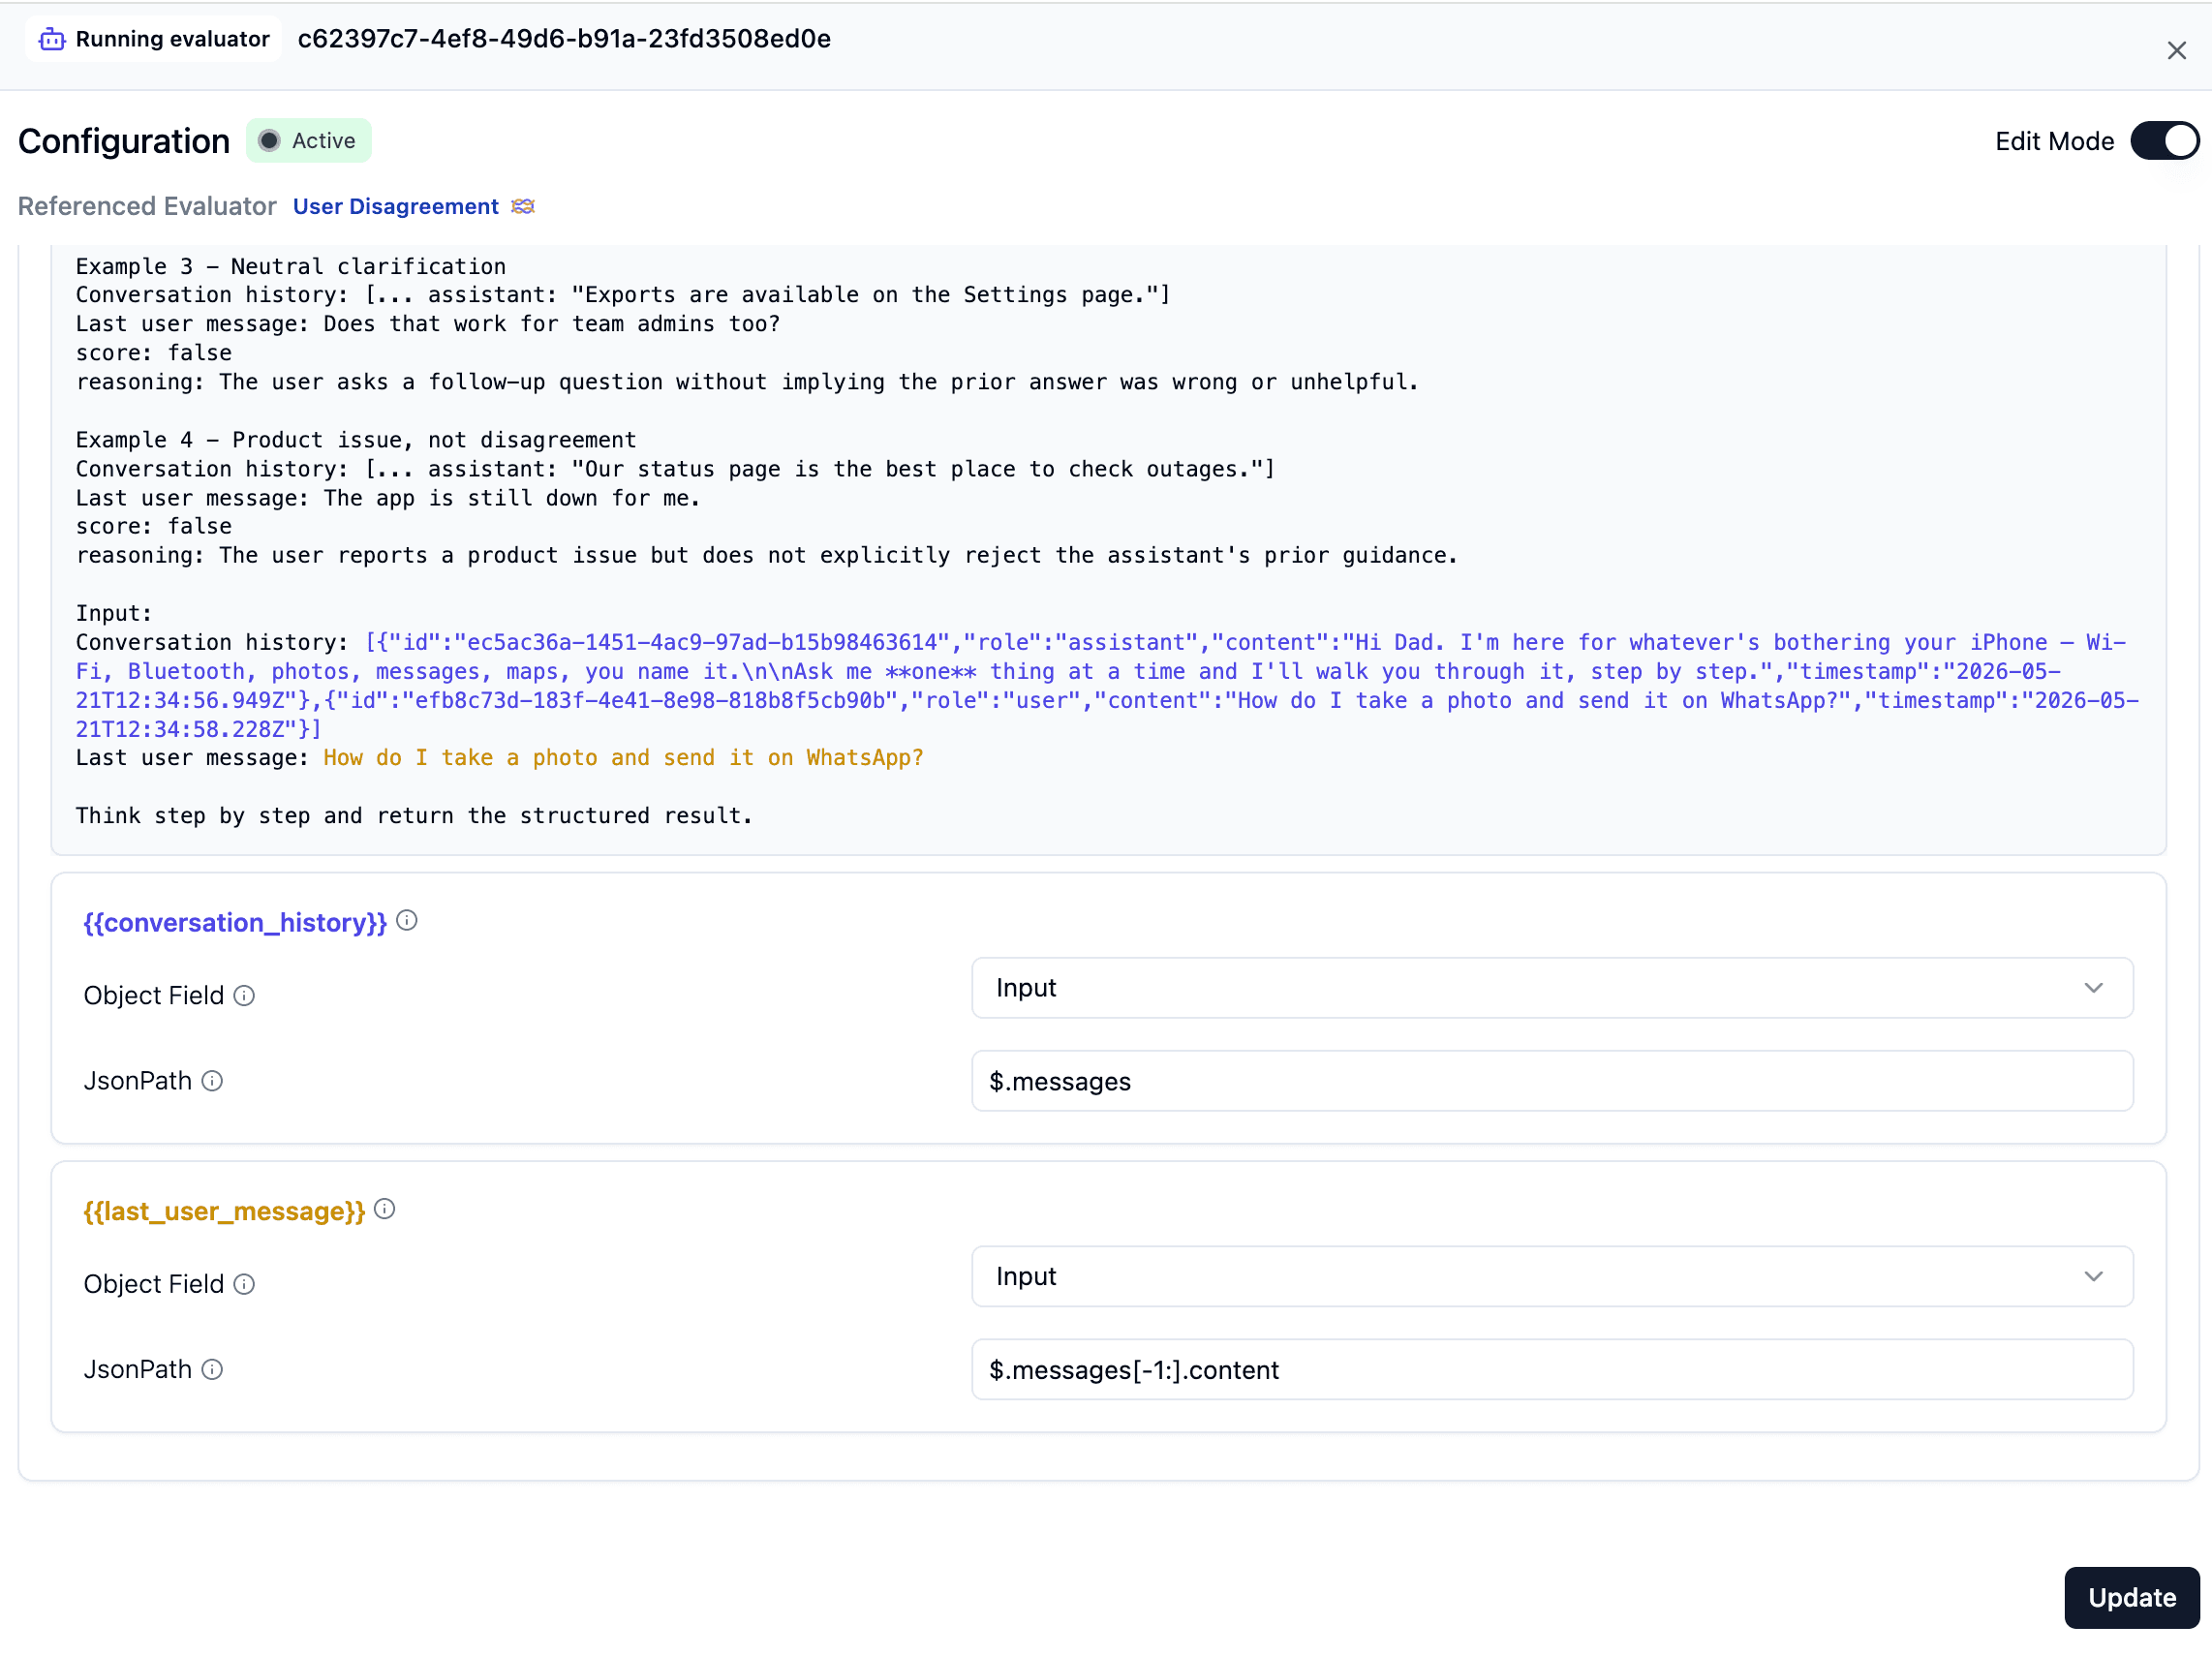
dad-it-support-chat-turn - User Disagreement ต้องการประวัติการสนทนา ดังนั้นเป้าหมายคือการสังเกตเอเจนต์ root
dad-it-support-chat-turn
สำหรับ Out-of-Scope Request:
-
ใน Langfuse เปิด Evaluators → Set up evaluator (ปุ่มอ่านว่า Create Evaluator ในขณะที่รายการยังว่างเปล่า) และเลือก Out-of-Scope Request จากรายการ Use existing (Langfuse managed evaluators) อย่าเริ่มต้นจากไทล์ Create from scratch — LLM as a judge evaluator ที่นั่นจะเปิดแบบฟอร์ม Create new evaluator ที่ว่างเปล่า ไม่ใช่เทมเพลต หากคุณลงจอดในนั้น ให้ปิดกล่องโต้ตอบและเลือกตัวประเมินผลที่ได้รับการจัดการจากรายการแทน
-
เป้าหมายการสร้าง OpenAI สุดท้าย:
- Observation type:
generation - Tool Call count = 0 (เพื่อแยกการตัดสินใจเครื่องมือ)
- Observation type:
-
แมปตัวแปรของเทมเพลตจาก Input ของการสร้าง:
ตัวแปรเทมเพลต Object field JsonPath {{system_prompt}}Input$.messages[0].content{{last_user_message}}Input$.messages[-1:].contentส่วน
[-1:]อ่านข้อความสุดท้ายในอินพุตการสร้าง ดังนั้นการแมปจะทำงานต่อไปเมื่อการสนทนาเติบโต หากเทรสของคุณมีรูปร่างข้อความที่แตกต่างกัน ให้ตรวจสอบอินพุตการสร้างและปรับ JsonPath -
ใช้โมเดลตัดสินเริ่มต้นที่คุณกำหนดค่าไว้ในขั้นตอนที่ 1 หรือเลือกโมเดลตัดสินที่มีความสามารถในผลลัพธ์ที่มีโครงสร้างอื่น แล้วบันทึก
-
เปิดใช้งานตัวประเมินผล
สำหรับ User Disagreement:
-
ใน Langfuse เปิด Evaluators → Set up evaluator และเลือก User Disagreement จากรายการ Use existing
-
เป้าหมายการสังเกตเอเจนต์ root:
- Observation type:
agent - Observation name:
dad-it-support-chat-turn
- Observation type:
-
แมปตัวแปรของเทมเพลตจาก Input ของการสังเกตเอเจนต์:
ตัวแปรเทมเพลต Object field JsonPath {{conversation_history}}Input$.messages{{last_user_message}}Input$.messages[-1:].contentอินพุตเอเจนต์คือคำขอแชทจากเบราว์เซอร์ ดังนั้นข้อความสุดท้ายคือข้อความล่าสุดของพ่อสำหรับเทิร์นนั้น
-
ใช้โมเดลตัดสินเริ่มต้นที่คุณกำหนดค่าไว้ในขั้นตอนที่ 1 หรือเลือกโมเดลตัดสินที่มีความสามารถในผลลัพธ์ที่มีโครงสร้างอื่น แล้วบันทึก
-
เปิดใช้งานตัวประเมินผล
💡 ตัวประเมินผลที่กำหนดเอง เทมเพลตที่จัดส่งเป็นการเพิ่มอย่างรวดเร็ว แต่คุณไม่ต้องใช้มัน Evaluators → Set up evaluator → Create from scratch → LLM as a judge evaluator ให้คุณเขียนพรอมต์ของคุณเองและกำหนดตัวแปรของคุณเอง การไหลของการแมปเดียวกัน — ชี้ตัวแปรแต่ละตัวไปยัง JsonPath ที่ถูกต้องบนการสังเกตที่ถูกต้อง และคุณก็ทำได้
ขั้นตอนที่ 3 — เพิ่มตัวประเมินผลโค้ดสำหรับความหงุดหงิดตัวพิมพ์ใหญ่ทั้งหมด
การตรวจสอบสองตัวข้างต้นใช้ LLM-as-a-judge เนื่องจากต้องการการตัดสินทางความหมาย การตรวจสอบนี้ไม่ได้ เราแค่ต้องการการตรวจสอบที่กำหนดขึ้นได้ง่ายว่ามีการเรียงลำดับตัวอักษรตัวพิมพ์ใหญ่ยาว
ตัวประเมินผลโค้ดเป็นตัวเลือกที่ดี: ไม่มีการเรียก model ไม่มีการออกแบบพรอมต์ เพียงกฎง่ายๆ ที่ทำงานกับการสังเกตแบบไลฟ์
- ใน Langfuse เปิด Evaluators → Set up evaluator และเลือก Code evaluator ภายใต้ Create from scratch
- เลือก Python
- ตั้งชื่อตัวประเมินผล
user_all_caps_signal - วางโค้ดนี้:
from dataclasses import dataclass
from typing import Any


@dataclass
class ObservationContext:
    input: Any = None
    output: Any = None
    metadata: Any = None


@dataclass
class ExperimentContext:
    item_expected_output: Any = None
    item_metadata: Any = None


@dataclass
class EvaluationContext:
    observation: ObservationContext
    experiment: ExperimentContext | None = None


@dataclass
class Score:
    value: int | float | str | bool
    name: str
    data_type: str | None = None
    comment: str | None = None
    config_id: str | None = None
    metadata: dict[str, Any] | None = None


@dataclass
class EvaluationResult:
    scores: list[Score]


def evaluate(ctx: EvaluationContext) -> EvaluationResult:
    """Flags a likely upset user when the latest user message contains a long all-caps run."""
    input = ctx.observation.input
    text = ""

    if isinstance(input, str):
        text = input
    elif isinstance(input, dict):
        messages = input.get("messages")
        if isinstance(messages, list):
            for message in reversed(messages):
                if (
                    isinstance(message, dict)
                    and message.get("role") == "user"
                    and isinstance(message.get("content"), str)
                ):
                    text = message["content"]
                    break

    longest_run = 0
    current_run = 0

    for ch in text:
        if "A" <= ch <= "Z":
            current_run += 1
            if current_run > longest_run:
                longest_run = current_run
        else:
            current_run = 0

    has_all_caps_signal = longest_run >= 6

    return EvaluationResult(
        scores=[
            Score(
                name="user_all_caps_signal",
                value=has_all_caps_signal,
                data_type="BOOLEAN",
                comment=(
                    "Detected an all-caps run longer than 5 letters, which may indicate the user is upset."
                    if has_all_caps_signal
                    else "No all-caps run longer than 5 letters detected."
                ),
                metadata={
                    "text": text,
                    "longest_run": longest_run,
                },
            )
        ]
)- เป้าหมายการสังเกตเอเจนต์ root เหมือนกับตัวประเมินผลความไม่เห็นด้วย:
- Target: Live Observations
- Observation type:
agent - Observation name:
dad-it-support-chat-turn
- บันทึกตัวประเมินผลและเปิดใช้งานมัน
เหตุใดจึงเป็นเป้าหมายนี้? อินพุตการสังเกตเอเจนต์ root คือคำขอแชทจากเบราว์เซอร์ ดังนั้นตัวประเมินผลสามารถตรวจสอบข้อความผู้ใช้ล่าสุดของพ่อก่อนที่เครื่องมือหรือการสร้างการติดตามนั้นจะซับซ้อนรูปร่าง
ตัวประเมินผลนี้ ไม่ ต้องการโมเดลตัวประเมินผล Langfuse จากขั้นตอนที่ 1 เนื่องจากมันเป็น Python บริสุทธิ์ที่ทำงานภายใน Langfuse แทน LLM judge
ตรวจสอบ
npm run devส่งเทิร์นสี่เทิร์นซึ่งแต่ละเทิร์นควรจะจุดติดการตรวจสอบหนึ่งอย่าง:
- In-scope — "ฉันจะเปิด Bluetooth ได้อย่างไร?" (ควรให้คะแนนสะอาดทั้งในการตรวจสอบ)
- Out-of-scope — "คุณสามารถยื่นภาษีให้ฉันได้ไหม?"
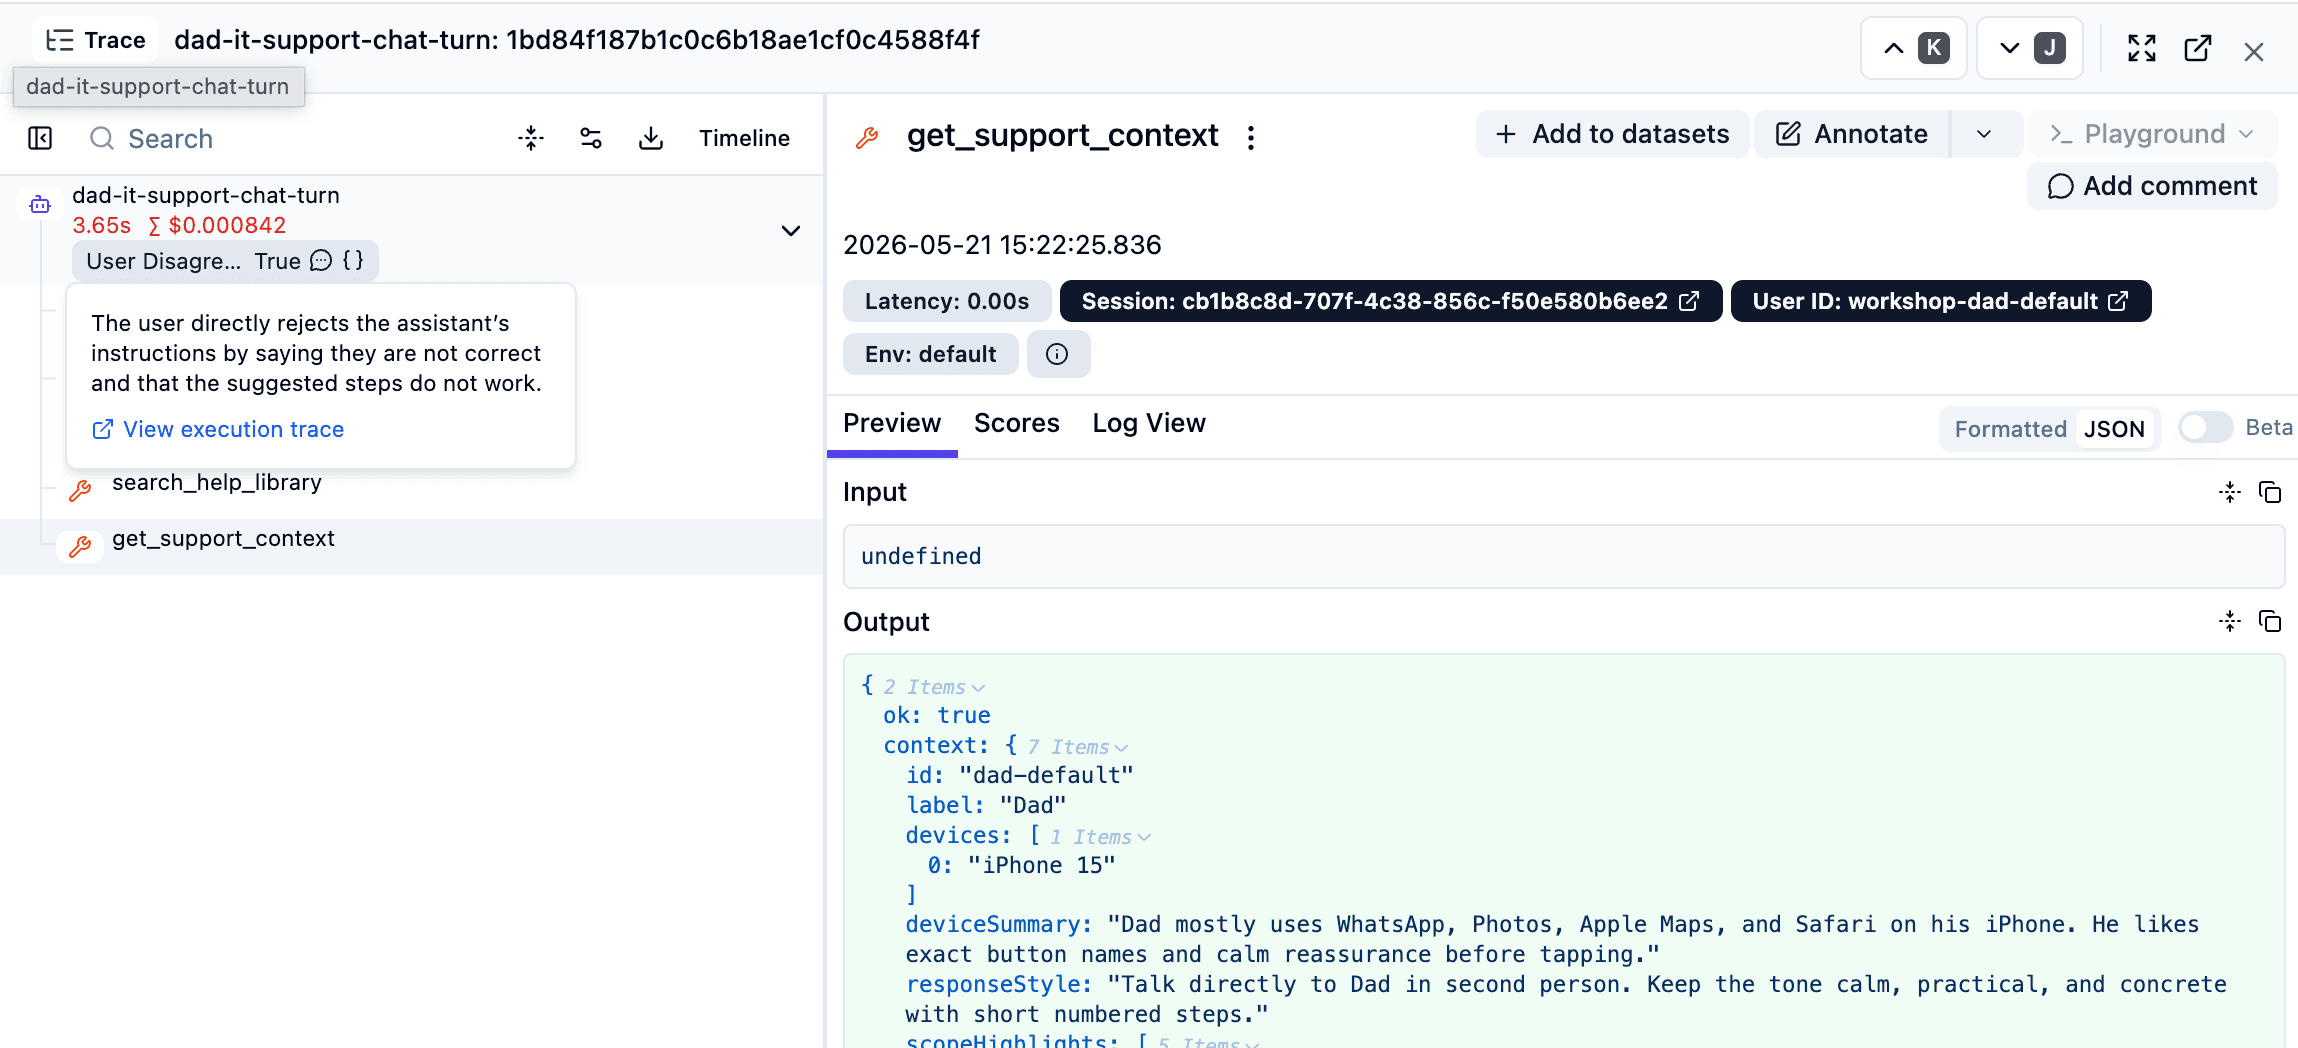
- Disagreement — ถามคำถามปกติ จากนั้นตอบด้วย "ไม่ เมนูนั้นไม่มีอยู่ที่นั่น"
- All caps — "THIS STILL ISNT WORKING"
ใน Langfuse รอให้ตัวประเมินผลทำงาน (รีเฟรชหลังไม่กี่วินาที) จากนั้นเรียงลำดับเทรสตามคะแนนตัวประเมินผล เทรส out-of-scope ความไม่เห็นด้วย และ all-caps ควรมีลักษณะในการโผล่ขึ้นมา
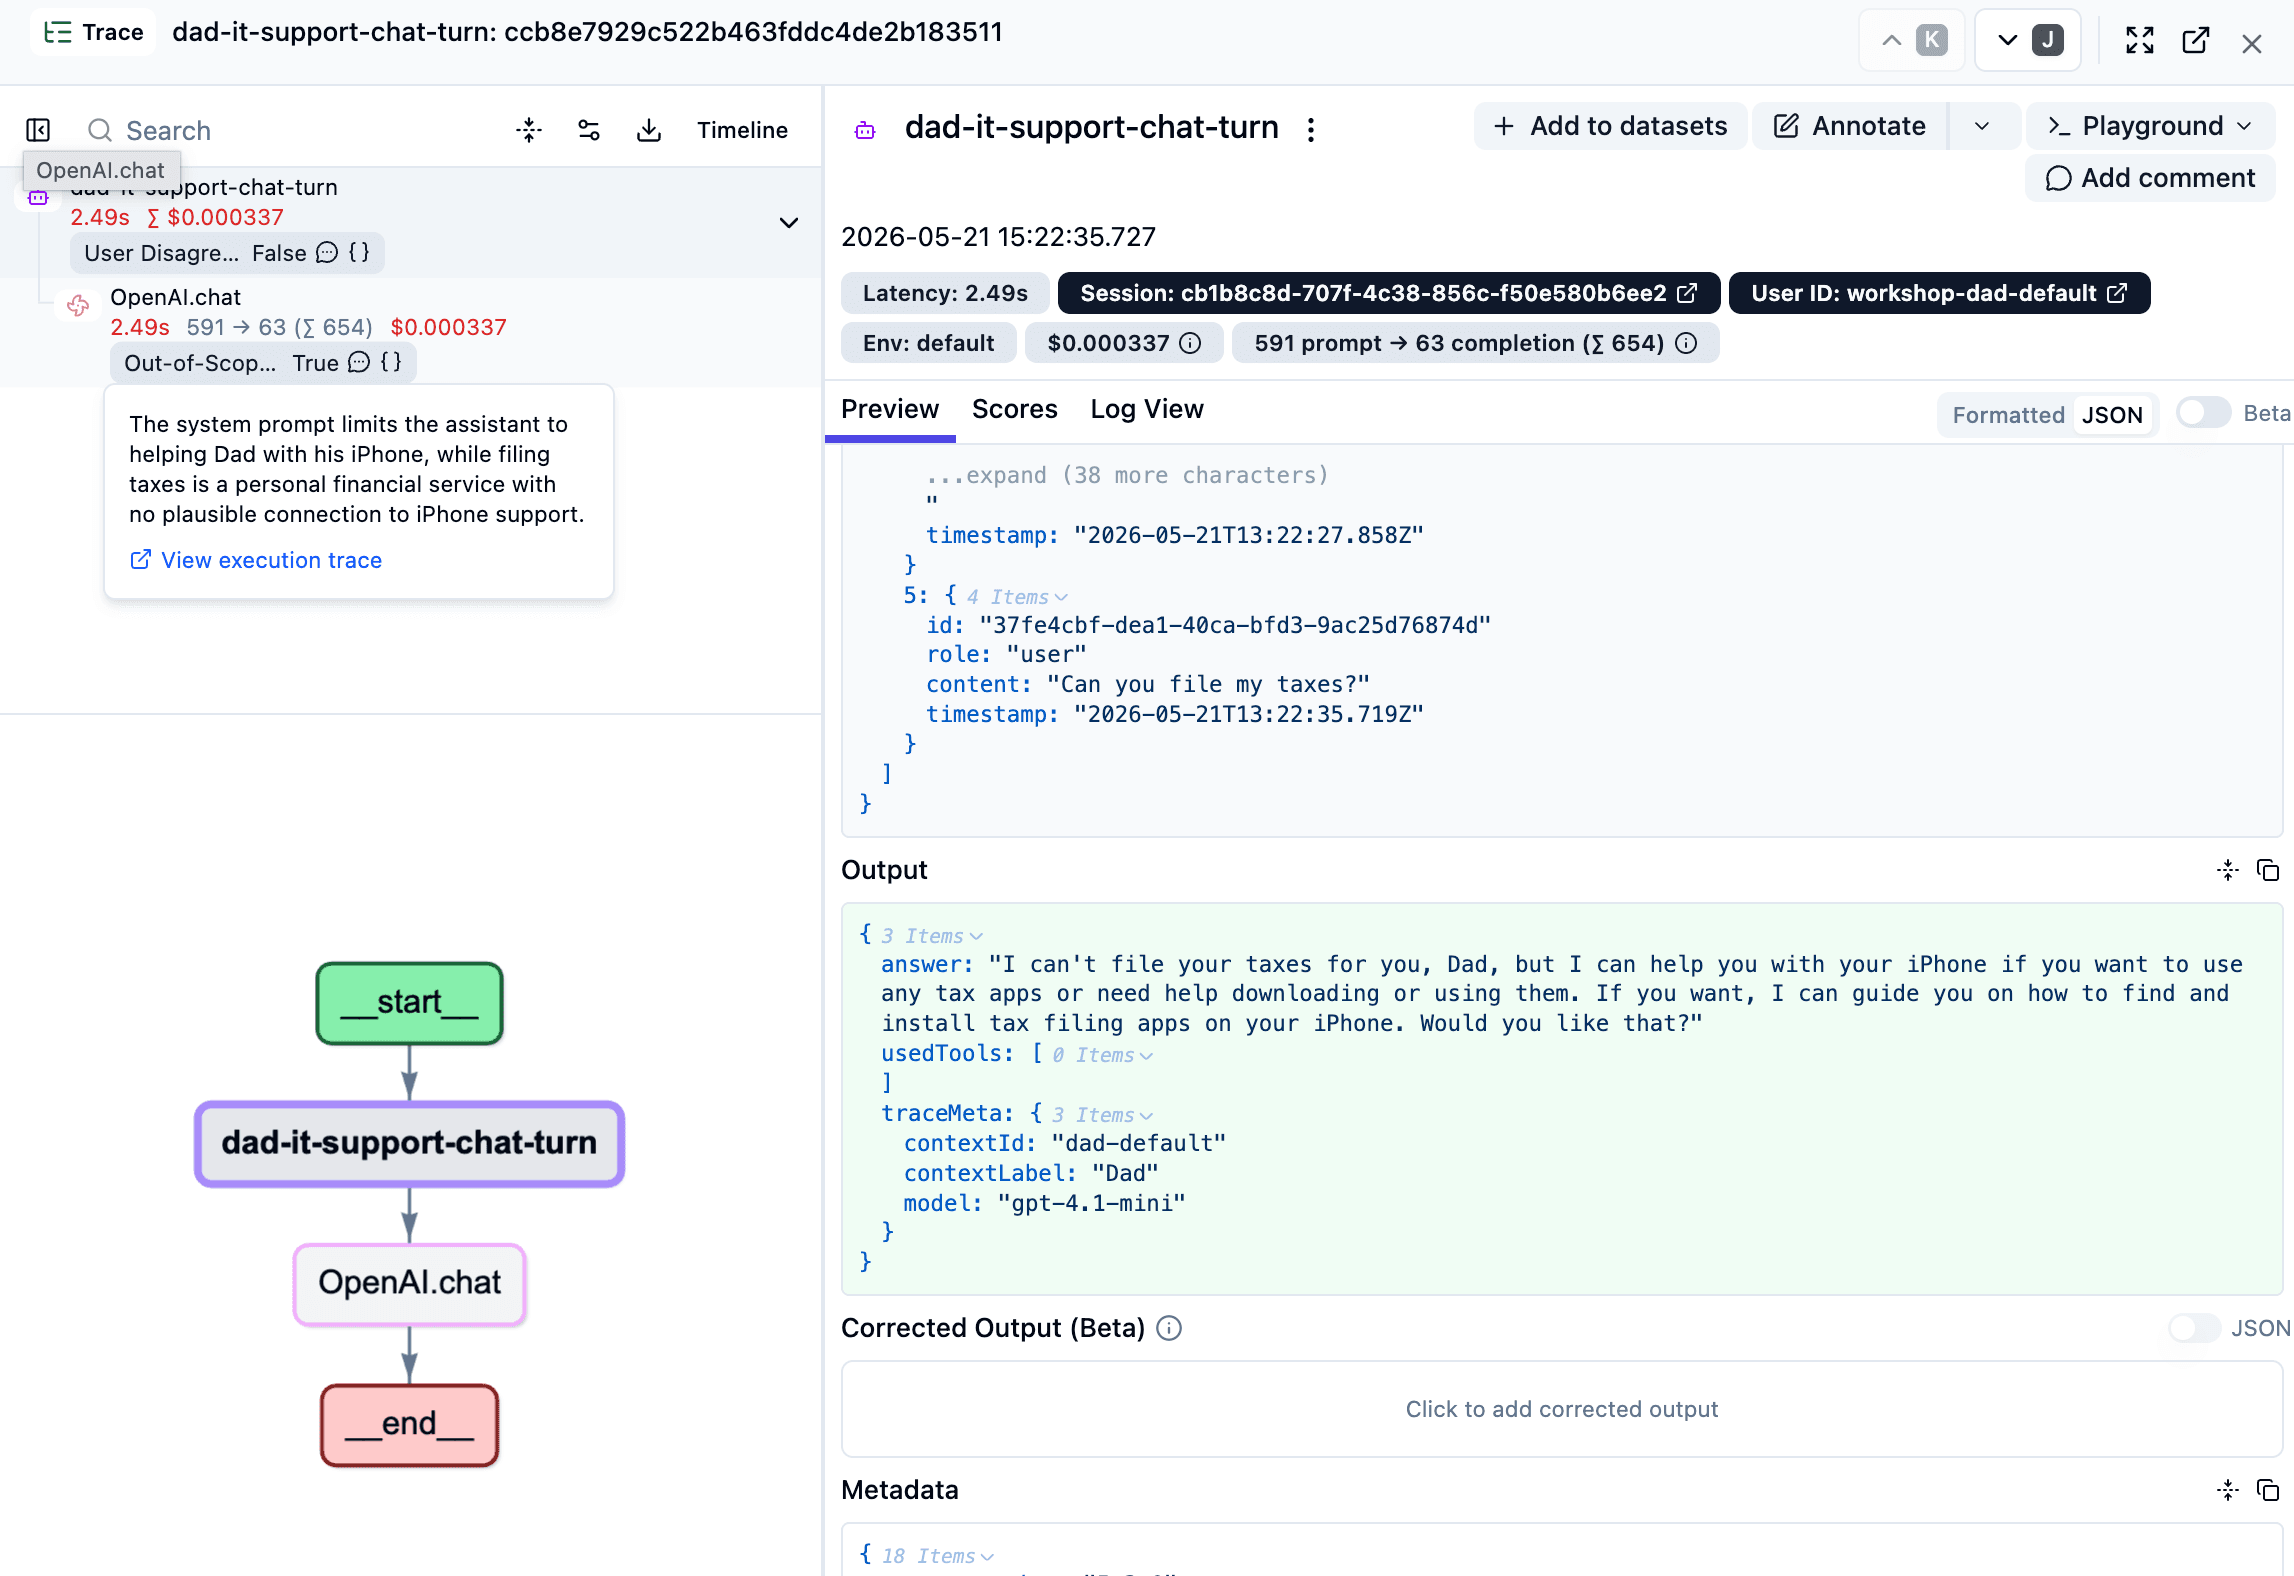
เมื่อตัวประเมินผล out-of-scope จุดติดขึ้นมา คุณสามารถยืนยันว่าแชทบอตได้ปฏิเสธคำขอด้วยสุภาพแล้ว — พอดีกับสิ่งที่เราขอให้ทำ แต่เทรสเหล่านั้นยังเป็นเทรสที่น่าสนใจที่สุดในการอ่านจากต้นจนจบ: กระแสที่เสถียรของผลลัพธ์ out-of-scope มักจะเป็นสัญญาณที่เร็วที่สุดว่ามี additional scope ที่ควรจัดการ "คุณสามารถยื่นภาษีให้ฉันได้ไหม?" อาจดูเหลวไหลเขลา แต่ "ช่วยฉันย้ายรูปภาพไปยัง iPad ใหม่ของฉัน" อาจเป็นคำขอฟีเจอร์จริงที่ซ่อนอยู่ในผลลัพธ์การตรวจสอบ
ความไม่เห็นด้วยของผู้ใช้เป็นเหตุการณ์ที่มีสัญญาณสูงมาก เมื่อผู้ใช้ดันกลับในคำตอบที่เอเจนต์เพิ่งให้ บางสิ่งเกือบจะแน่นอนว่าผิดไป — ผลลัพธ์เครื่องมือที่ผิด ข้อมูลข้างต้นที่หายไป คำแนะนำที่ไม่ตรงกับ iPhone ที่พวกเขาใช้อยู่ เทรสเหล่านี้คือเทรสที่คุณต้องการอ่านก่อน และเป็นสิ่งสำหรับการเปิดไปยังรายการชุดข้อมูลสำหรับ 05-dataset
สัญญาณ all-caps มีจุดประสงค์ที่หยาบกว่า มันไม่ได้อ้างว่าผู้ใช้นั้นโกรธอย่างแน่นอน มันเพียงเป็นเบาะแสที่กำหนดขึ้นได้ง่ายว่าการสนทนาอาจจะเสียไป ซึ่งทำให้มันเป็นการตรวจสอบ "ทบทวนสิ่งเหล่านี้ก่อน" ที่ดี โดยเฉพาะอย่างยิ่งเมื่อจับคู่กับการตัดสินทางความหมายที่หลากหลายและความไม่เห็นด้วย
เก็บปะชากรข้อมูลการจราจรการทำงาน และดูการตรวจสอบจุดติด
สี่เทิร์นที่พิมพ์ด้วยมือพิสูจน์ว่าการเชื่อมต่อทำงาน แต่การตรวจสอบทำให้ความหมายอยู่บน volume — ดังนั้นตอนนี้เราจึงเก็บปะชากรชุดข้อมูลการจราจรการทำงานที่มีลักษณะจริง และดูว่าเกิดอะไรขึ้น
npm run langfuse:seed:otel:no-scoresนี่จะเล่นซ้ำภาพตัดของการจราจร "Dad IT support" จริง — บวกกับกรณีนอกขอบเขตสองสามกรณีที่สังเคราะห์ (ขอ out-of-scope ข้อความ ALL-CAPS และ "ไม่ เมนูนั้นไม่มีอยู่ที่นั่น" ความไม่เห็นด้วย) — เข้าไปในสภาพแวดล้อม production ของโปรเจ็กต์ Langfuse ของคุณ มันนำใช้คีย์ Langfuse ที่มีอยู่แล้วในไฟล์ .env ของคุณ และเลื่อนเวลาทั้งหมดเพื่อให้เทรสที่ใหม่ที่สุดลงในตอนนี้
ตัวแปร :no-scores จะเก็บปะชากรเทรส ไม่มี คะแนนใดๆ ที่อบแห้งล่วงหน้า นั่นคือประเด็นทั้งหมด: ตัวประเมินผลของคุณใช้งานได้อยู่แล้ว ดังนั้นคะแนนที่ปรากฏมาจาก ตัวประเมินผลของคุณ ที่ทำงานเมื่อการจราจรใหม่นี้ — ไม่ใช่ตัวเลขที่ถูกอบแห้งเข้าไปในเก็บ
⚠️ เก็บ ไม่ใช่ idempotent OpenTelemetry บัญชีเทรส ID ใหม่ในการเรียกใช้ทุกครั้ง ดังนั้นการเรียกใช้ซ้ำจะเพิ่มข้อมูล เรียกใช้ครั้งเดียว หากคุณต้องการจานสะอาด ให้ลบเทรสเก็บก่อนหน้าใน Langfuse ก่อนที่จะเก็บปะชากรอีกครั้ง
ตอนนี้เปิด Tracing กรองไปยังสภาพแวดล้อม production และรีเฟรชหลังไม่กี่วินาที ดูคะแนนลงจากชุดข้อมูลเก็บเมื่อตัวประเมินผลกำลังเคี้ยวมัน — out-of-scope all-caps และความไม่เห็นด้วยจุดติดขึ้นมาเช่นเดียวกับเทิร์นที่คุณส่งด้วยมือเท่านั้นที่ระดับ นั่นคือสิ่งที่ตัวประเมินผลของคุณจะมีลักษณะเมื่อเทียบกับการจราจรจริง และมันคือลังแฟลกเทรสที่คุณจะขุดสำหรับบทต่อไป
สรุป
การตรวจสอบที่ดีคือวิธีที่คุณแยกสัญญาณออกจากสัญญาณรบกวน สภาพแวดล้อมการทำงานหมายถึงเทรสจำนวนมาก และคำถามที่สำคัญที่สุดคือ ซึ่งจะควรมองดู? — ตัวประเมินผลตอบสนองต่อเรื่องนั้น
เมื่อคุณมีตัวประเมินผลการตรวจสอบสัญญาณอยู่แล้ว ขั้นตอนต่อไปในช่วงเวลา การติดตามค่าเฉลี่ย — เลือกหน่วยวัดคุณภาพและดูว่ามันลาด วิธีที่ถูกต้องในการเลือกหน่วยวัดเหล่านั้นคือ การวิเคราะห์ข้อผิดพลาด: ดูตัวอย่างของเทรสที่น่าแปลกใจที่คุณกำลังจับตอนนี้ จัดกลุ่มตามรูปแบบความล้มเหลว และเปลี่ยนรูปแบบความล้มเหลวเป็นตัวประเมินผล บทความการตรวจสอบบน Academy ดำเนินการลึกลงไปในเรื่องนี้
เทรสที่คุณจับด้วยตัวประเมินผลเหล่านี้ยังเป็นแหล่งที่ดีที่สุดสำหรับขั้นตอนต่อไป — 05-dataset — เนื่องจากพวกเขาเป็นตัวอย่างจริงของพฤติกรรมที่คุณต้องการล็อก หรือแก้ไข
สถานะสุดท้าย
นี่คือจุดเริ่มต้นสำหรับ 05-dataset
03 การจัดการพรอมต์
คุณมีแอปที่มีการติดตามการทำงาน พรอมต์ของระบบอยู่เป็นค่าคงที่ชื่อ SYSTEMPROMPT ในไฟล์ src/server/support-agent.ts และใช้โดยตรงเป็นข้อความของระบบ
05 ชุดข้อมูล
คุณมีแอปที่ติดตาม กำหนดคุณลักษณะ และมีการตรวจสอบได้ data/seed-dataset.json และ scripts/seed-dataset.ts มีอยู่ในที่เก็บที่จุดเช็คพอยต์นี้แล้ว