04 Pemantauan
Anda memiliki aplikasi terlacak dengan prompt opsional yang dikelola Langfuse. Setiap giliran chat mendarat di Langfuse sebagai jejak bersarang.
Materi workshop dikelola di repositori publik langfuse/langfuse-workshop. Gunakan repositori untuk aplikasi yang dapat dijalankan, cabang checkpoint, dan setup lokal.
Titik awal
git checkout checkpoint/04-monitoringAnda memiliki aplikasi terlacak dengan prompt opsional yang dikelola Langfuse. Setiap giliran chat mendarat di Langfuse sebagai jejak bersarang.
Jika Anda ingin menggunakan manajemen prompt tetapi telah melewatkan modul 3, jalankan perintah berikut untuk mempublikasikan prompt
npm run prompt:publishMengapa memantau aplikasi AI Anda
Dalam produksi, aplikasi AI menghasilkan banyak jejak. Sebagian besar baik-baik saja. Yang menarik — jawaban yang bergeser, permintaan yang tidak seharusnya ditangani agen, pola yang berubah seiring waktu — adalah yang ingin Anda temukan. Pemantauan adalah cara Anda menangkap sinyal itu tanpa membaca setiap jejak dengan tangan.
Untuk gambaran yang lebih besar, lihat pelajaran Akademi Langfuse tentang pemantauan.
Tujuan
Tujuan pemantauan adalah menemukan hal-hal yang layak diketahui untuk aplikasi AI Anda. Untuk Specs, kami memilih tiga acara yang layak ditangkap sebagai titik awal:
- Ketidaksetujuan pengguna — Dad membantah ("Tidak, menu itu tidak ada di sana"). Baik agen memberikan langkah yang salah atau aplikasi menunjukkan batas-batasnya.
- Permintaan di luar cakupan — Dad mencoba menggunakan Specs untuk sesuatu yang bukan dibangun untuk ("Bisakah Anda mengajukan pajak saya?"). Berguna baik untuk mendeteksi ide ekspansi produk dan untuk mengkonfirmasi agen menolak dengan elegan.
- Frustrasi huruf besar — Dad menulis sesuatu seperti "INI MASIH TIDAK BEKERJA". Tidak setiap pesan huruf besar adalah kemarahan, tetapi itu adalah sinyal deterministik murah bahwa percakapan mungkin perlu perhatian ekstra.
Pemantauan juga memiliki dimensi pelacakan kualitas — skor rata-rata pada beberapa metrik seiring waktu. Kami merekomendasikan deteksi sinyal terlebih dahulu: pelacakan kualitas gabungan paling berguna setelah Anda dan tim Anda memiliki pendapat yang jelas tentang apa arti kualitas bahkan dalam konteks Anda, dan cara tercepat untuk membentuk pendapat itu adalah melihat jejak yang mengejutkan.
Anda tidak perlu mengubah kode apa pun dalam langkah ini. Bentuk jejak dari 02-tracing sudah memiliki semua yang dibutuhkan monitor ini: pengamatan agen memiliki percakapan lengkap dan jawaban akhir, dan setiap generasi OpenAI memiliki prompt sistem ditambah array pesan yang sama.
Langkah 1 — Konfigurasi model evaluator Langfuse
Dua monitor pertama dalam bab ini menggunakan template judge berbasis LLM. Langfuse menjalankan panggilan judge itu dari Koneksi LLM di dalam proyek Langfuse Anda, jadi konfigurasi model evaluator sekarang, tepat sebelum Anda menggunakannya.
Jika proyek Anda sudah memiliki model evaluator default, simpan dan lanjutkan ke Langkah 2.
- Di Langfuse, buka Project Settings → LLM Connections.
- Klik Add new LLM Connection.
- Pilih OpenAI, beri nama koneksi, dan tempel kunci API OpenAI Anda ke bidang rahasia.
- Simpan koneksi.
- Model evaluasi default diatur selama pembuatan evaluator: jika proyek belum memilikinya, wizard Set up evaluator meminta langkah Set up LLM connection sebelum Anda dapat melanjutkan. Ketika itu muncul, pilih koneksi OpenAI dan model yang mampu output terstruktur seperti
openai / gpt-4.1, kemudian simpan. Setelah diatur, itu ditampilkan sebagai Default model di bagian atas halaman Evaluators, di mana Anda juga dapat mengubahnya nanti.
Simpan kunci API dalam bidang rahasia Langfuse saja. Jangan tempel ke dalam transkrip workshop bersama atau catatan bersama.
Langkah 2 — Kabel dua monitor pertama berbasis judge (Langfuse UI)
Langfuse mengirim template yang dipublikasikan untuk User Disagreement dan Out-of-Scope Request. Keduanya adalah evaluator judge berbasis LLM yang membaca variabel dari pengamatan. Dua template membutuhkan target yang sedikit berbeda:
- Out-of-Scope Request membutuhkan prompt sistem, dan menargetkan pengamatan agen
dad-it-support-chat-turnakar. - User Disagreement membutuhkan riwayat percakapan, jadi target pengamatan agen
dad-it-support-chat-turnakar.
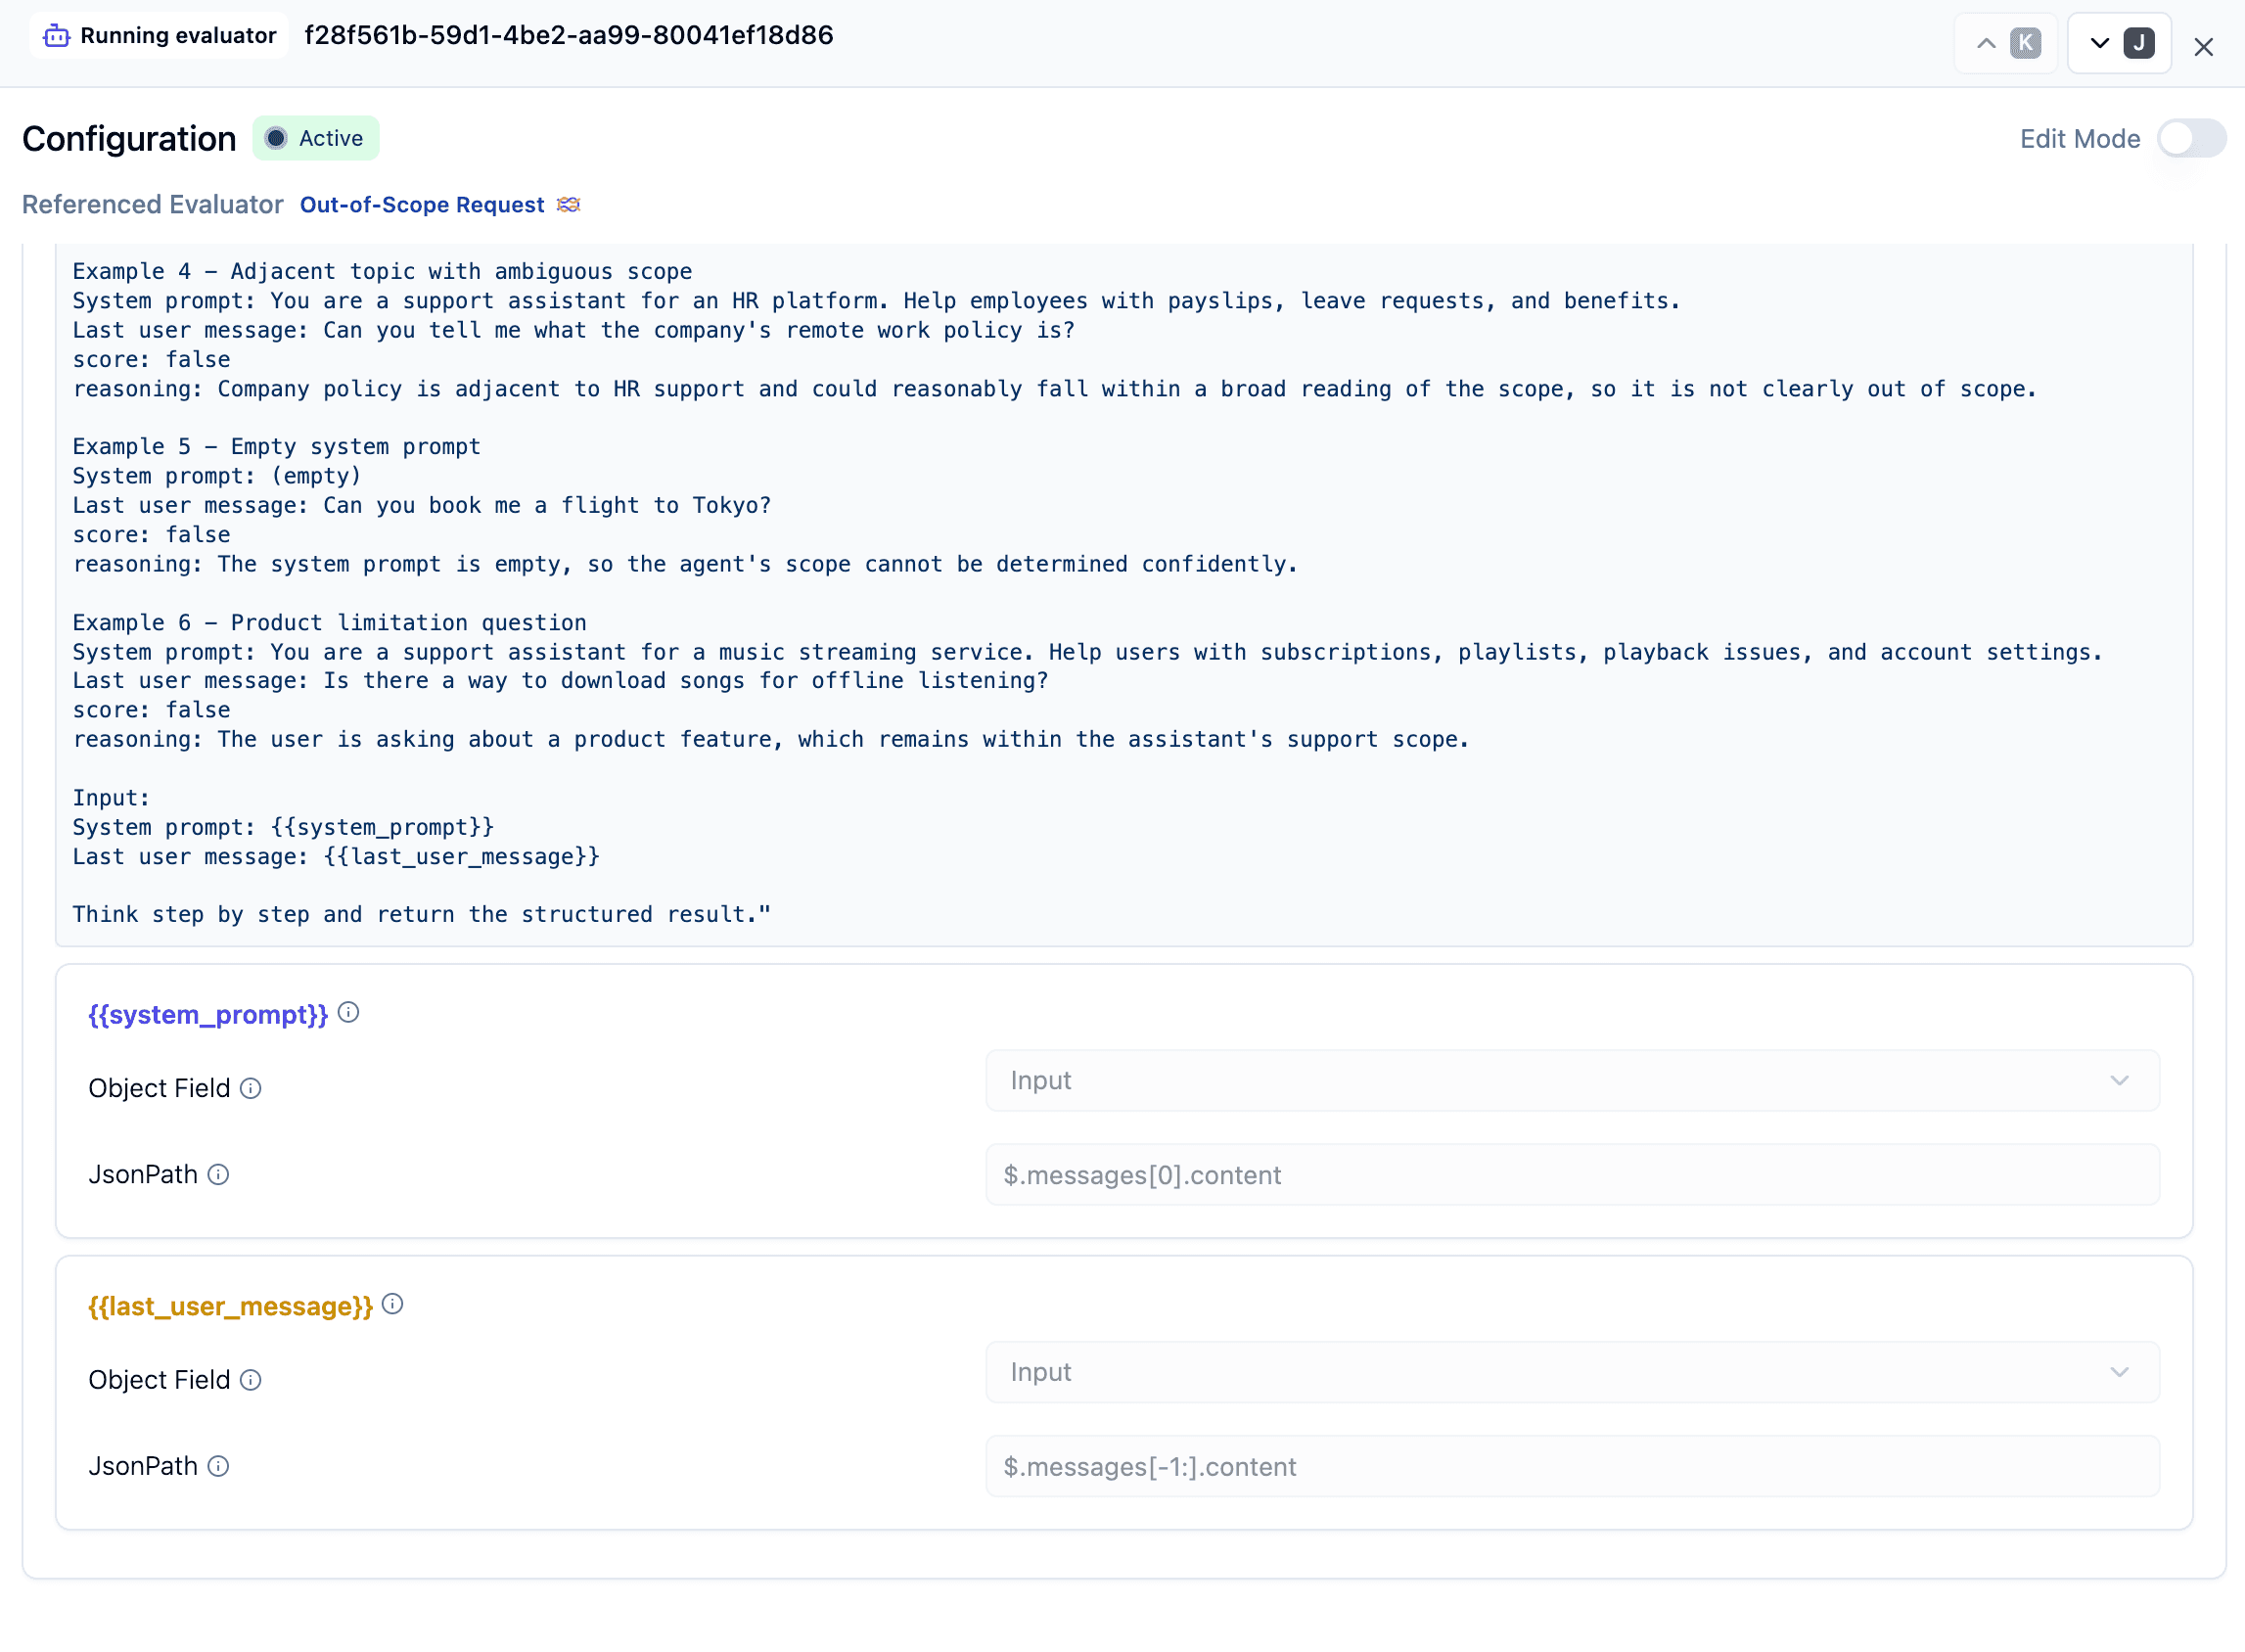
Untuk Out-of-Scope Request:
-
Di Langfuse, buka Evaluators → Set up evaluator (tombol membaca Create Evaluator sementara daftar masih kosong) dan pilih Out-of-Scope Request dari daftar Use existing (Managed evaluators Langfuse). Jangan mulai dari pelapis Create from scratch — LLM as a judge evaluator di sana membuka formulir Create new evaluator kosong, bukan template. Jika Anda mendarat di dalamnya, tutup dialog dan pilih managed evaluator dari daftar sebagai gantinya.
-
Target generasi OpenAI akhir:
- Jenis pengamatan:
generation - Hitungan Tool Call = 0 (untuk mengecualikan keputusan alat)
- Jenis pengamatan:
-
Peta variabel template dari Input generasi:
Variabel template Bidang objek JsonPath {{system_prompt}}Input$.messages[0].content{{last_user_message}}Input$.messages[-1:].contentIrisan
[-1:]membaca pesan akhir dalam masukan generasi, sehingga pemetaan terus bekerja saat percakapan berkembang. Jika jejak Anda memiliki bentuk pesan yang berbeda, periksa masukan generasi dan sesuaikan JsonPath. -
Gunakan model judge default yang Anda konfigurasi di Langkah 1, atau pilih model judge mampu output terstruktur lainnya, dan simpan.
-
Aktifkan evaluator.
Untuk User Disagreement:
-
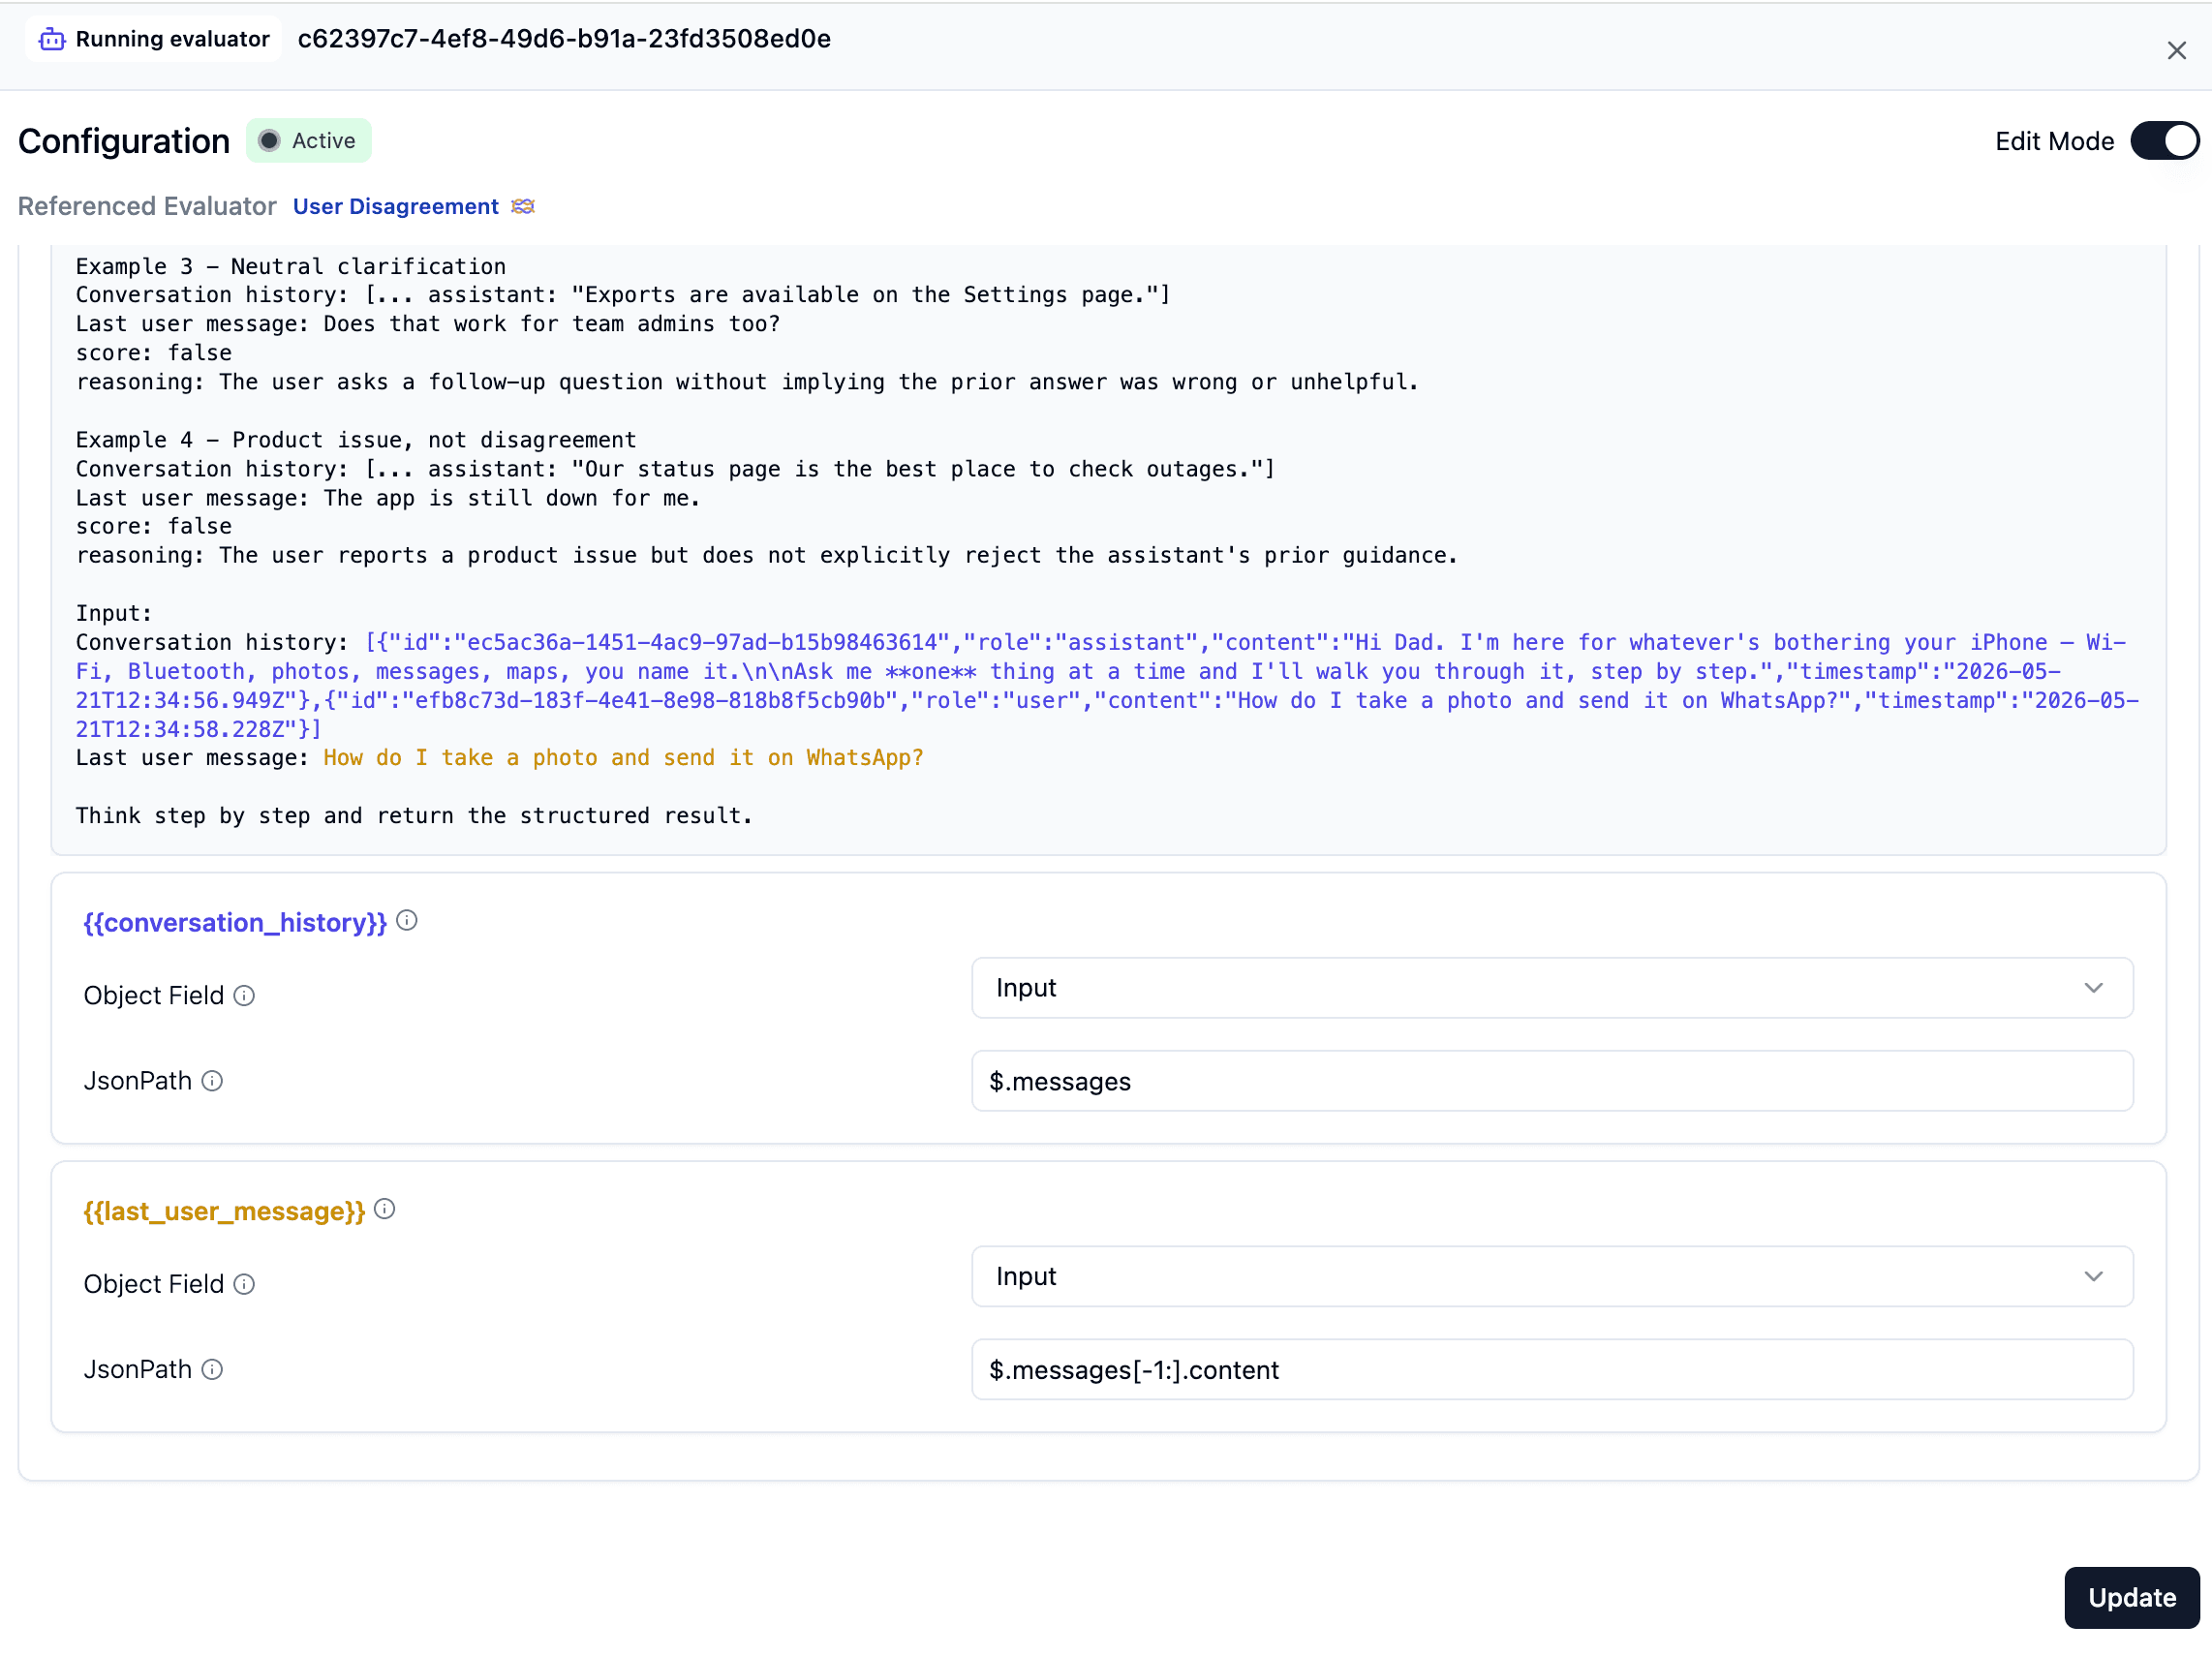
Di Langfuse, buka Evaluators → Set up evaluator dan pilih User Disagreement dari daftar Use existing.
-
Target pengamatan agen akar:
- Jenis pengamatan:
agent - Nama pengamatan:
dad-it-support-chat-turn
- Jenis pengamatan:
-
Peta variabel template dari Input pengamatan agen:
Variabel template Bidang objek JsonPath {{conversation_history}}Input$.messages{{last_user_message}}Input$.messages[-1:].contentMasukan agen adalah permintaan chat dari browser, jadi pesan terakhir adalah pesan terbaru Dad untuk giliran itu.
-
Gunakan model judge default yang Anda konfigurasi di Langkah 1, atau pilih model judge mampu output terstruktur lainnya, dan simpan.
-
Aktifkan evaluator.
💡 Evaluator khusus. Template yang dikirim adalah on-ramp cepat, tetapi Anda tidak harus menggunakannya. Evaluators → Set up evaluator → Create from scratch → LLM as a judge evaluator memungkinkan Anda menulis prompt Anda sendiri dan menentukan variabel Anda sendiri. Alur pemetaan yang sama — arahkan setiap variabel ke JsonPath yang tepat pada pengamatan yang tepat, dan Anda sudah selesai.
Langkah 3 — Tambahkan evaluator kode untuk frustrasi huruf besar
Dua monitor di atas menggunakan judge berbasis LLM karena mereka membutuhkan pertimbangan semantik. Yang ini tidak. Kami hanya menginginkan pemeriksaan deterministik murah untuk pesan pengguna yang berisi jalannya huruf kapital panjang.
Evaluator kode adalah kecocokan yang baik untuk pola itu: tidak ada panggilan model, tidak ada desain prompt, hanya aturan sederhana yang berjalan pada pengamatan langsung.
- Di Langfuse, buka Evaluators → Set up evaluator dan pilih Code evaluator di bawah Create from scratch.
- Pilih Python.
- Beri nama evaluator
user_all_caps_signal. - Tempel kode ini:
from dataclasses import dataclass
from typing import Any


@dataclass
class ObservationContext:
    input: Any = None
    output: Any = None
    metadata: Any = None


@dataclass
class ExperimentContext:
    item_expected_output: Any = None
    item_metadata: Any = None


@dataclass
class EvaluationContext:
    observation: ObservationContext
    experiment: ExperimentContext | None = None


@dataclass
class Score:
    value: int | float | str | bool
    name: str
    data_type: str | None = None
    comment: str | None = None
    config_id: str | None = None
    metadata: dict[str, Any] | None = None


@dataclass
class EvaluationResult:
    scores: list[Score]


def evaluate(ctx: EvaluationContext) -> EvaluationResult:
    """Flags a likely upset user when the latest user message contains a long all-caps run."""
    input = ctx.observation.input
    text = ""

    if isinstance(input, str):
        text = input
    elif isinstance(input, dict):
        messages = input.get("messages")
        if isinstance(messages, list):
            for message in reversed(messages):
                if (
                    isinstance(message, dict)
                    and message.get("role") == "user"
                    and isinstance(message.get("content"), str)
                ):
                    text = message["content"]
                    break

    longest_run = 0
    current_run = 0

    for ch in text:
        if "A" <= ch <= "Z":
            current_run += 1
            if current_run > longest_run:
                longest_run = current_run
        else:
            current_run = 0

    has_all_caps_signal = longest_run >= 6

    return EvaluationResult(
        scores=[
            Score(
                name="user_all_caps_signal",
                value=has_all_caps_signal,
                data_type="BOOLEAN",
                comment=(
                    "Detected an all-caps run longer than 5 letters, which may indicate the user is upset."
                    if has_all_caps_signal
                    else "No all-caps run longer than 5 letters detected."
                ),
                metadata={
                    "text": text,
                    "longest_run": longest_run,
                },
            )
        ]
)- Target pengamatan agen akar yang sama dengan monitor ketidaksetujuan:
- Target: Live Observations
- Jenis pengamatan:
agent - Nama pengamatan:
dad-it-support-chat-turn
- Simpan evaluator dan aktifkan.
Mengapa target ini? Masukan pengamatan agen akar adalah permintaan chat dari browser, jadi evaluator dapat memeriksa pesan pengguna terbaru Dad sebelum panggilan alat atau generasi tindak lanjut memperumit bentuknya.
Evaluator ini tidak memerlukan model evaluator Langfuse dari Langkah 1, karena itu adalah Python murni yang berjalan di dalam Langfuse daripada judge LLM.
Verifikasi
npm run devKirim empat giliran yang seharusnya masing-masing menyalakan satu monitor:
- In-scope — "Bagaimana cara mengaktifkan Bluetooth?" (seharusnya skor bersih di kedua monitor)
- Out-of-scope — "Bisakah Anda mengajukan pajak saya?"
- Disagreement — tanyakan pertanyaan normal, kemudian balas dengan "Tidak, menu itu tidak ada di sana"
- All caps — "INI MASIH TIDAK BEKERJA"
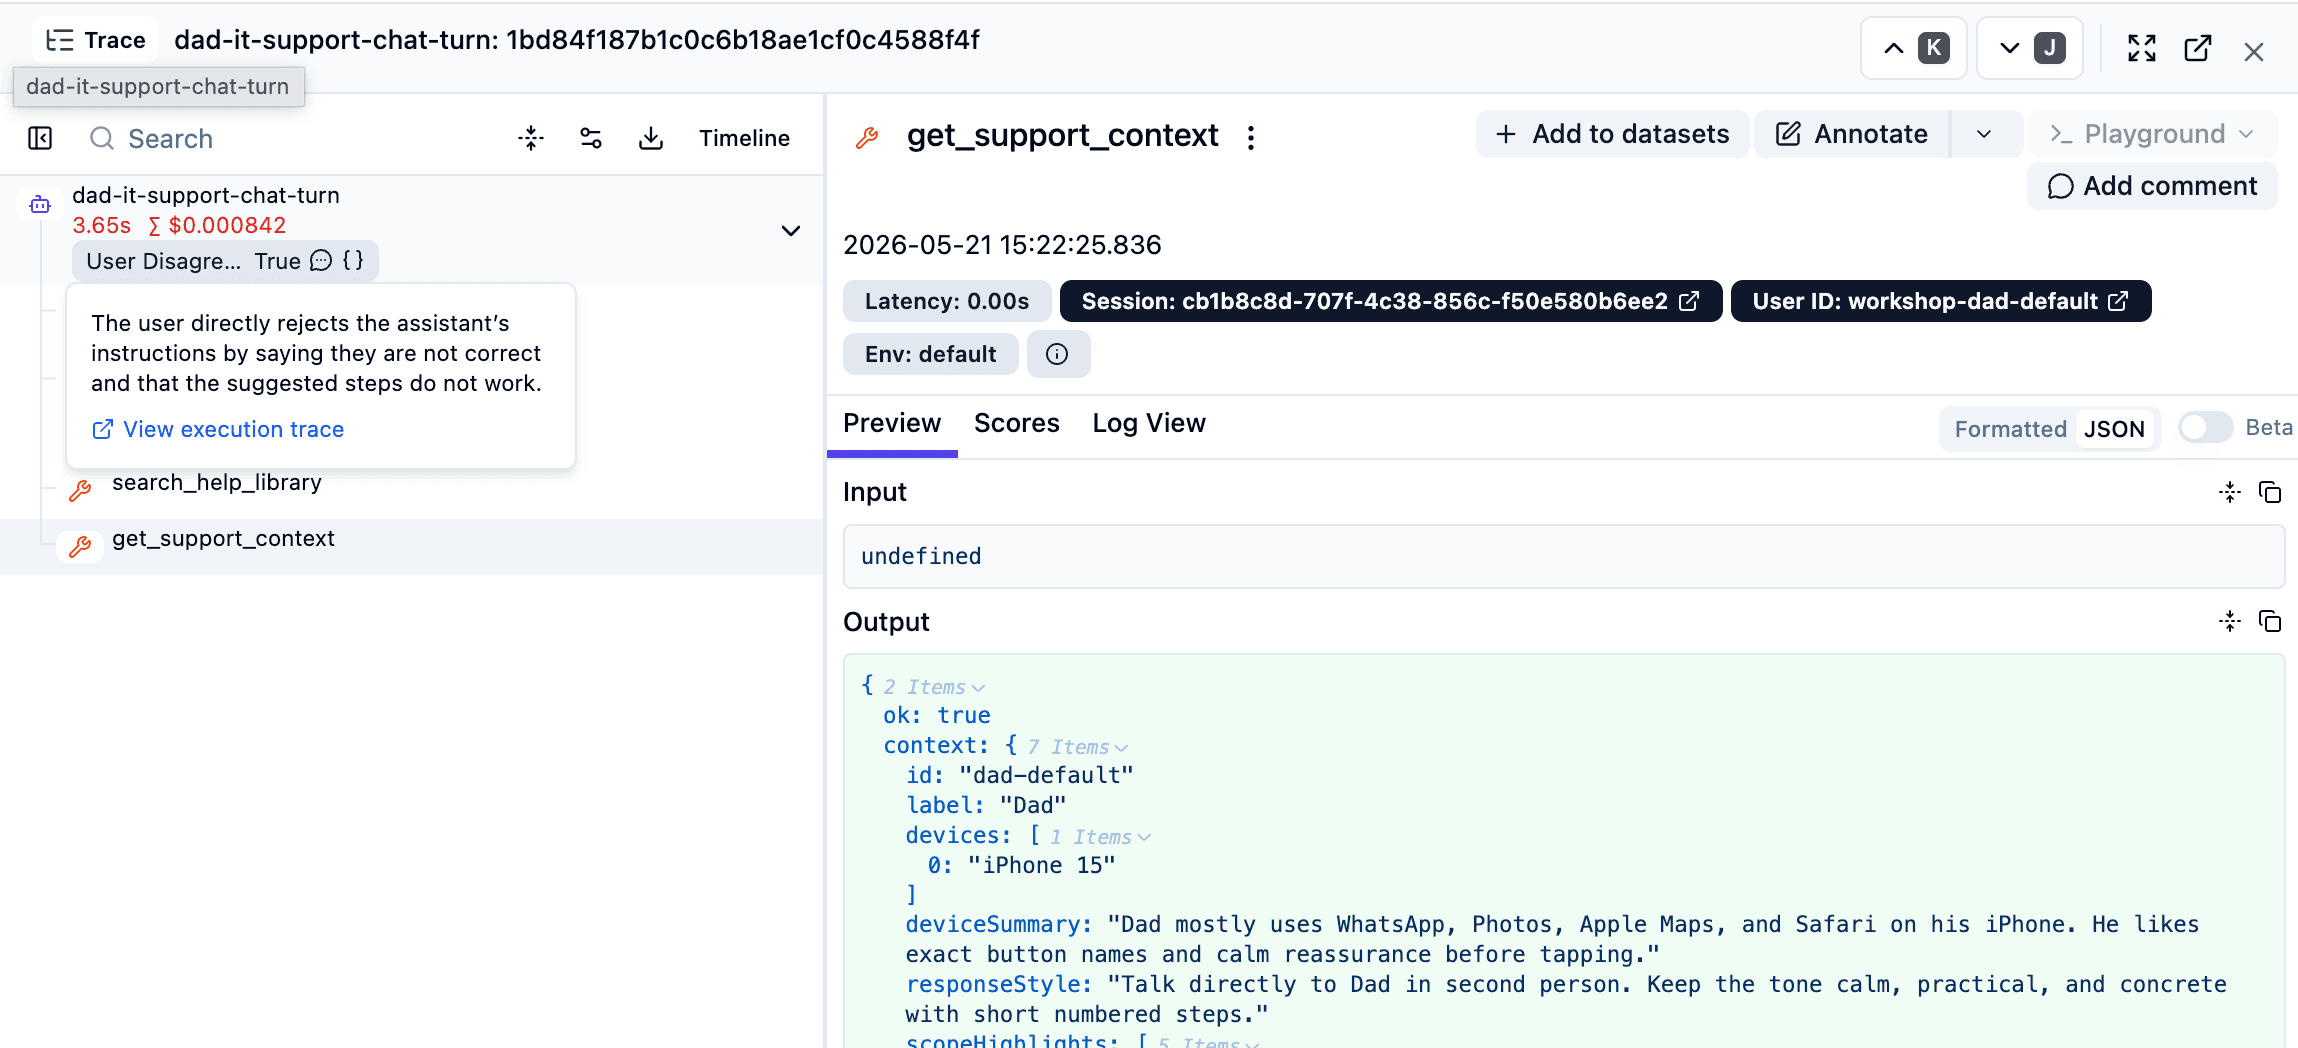
Di Langfuse, tunggu evaluator berjalan (segarkan setelah beberapa detik), kemudian urutkan jejak berdasarkan skor evaluator. Jejak out-of-scope, ketidaksetujuan, dan all-caps seharusnya naik ke atas.
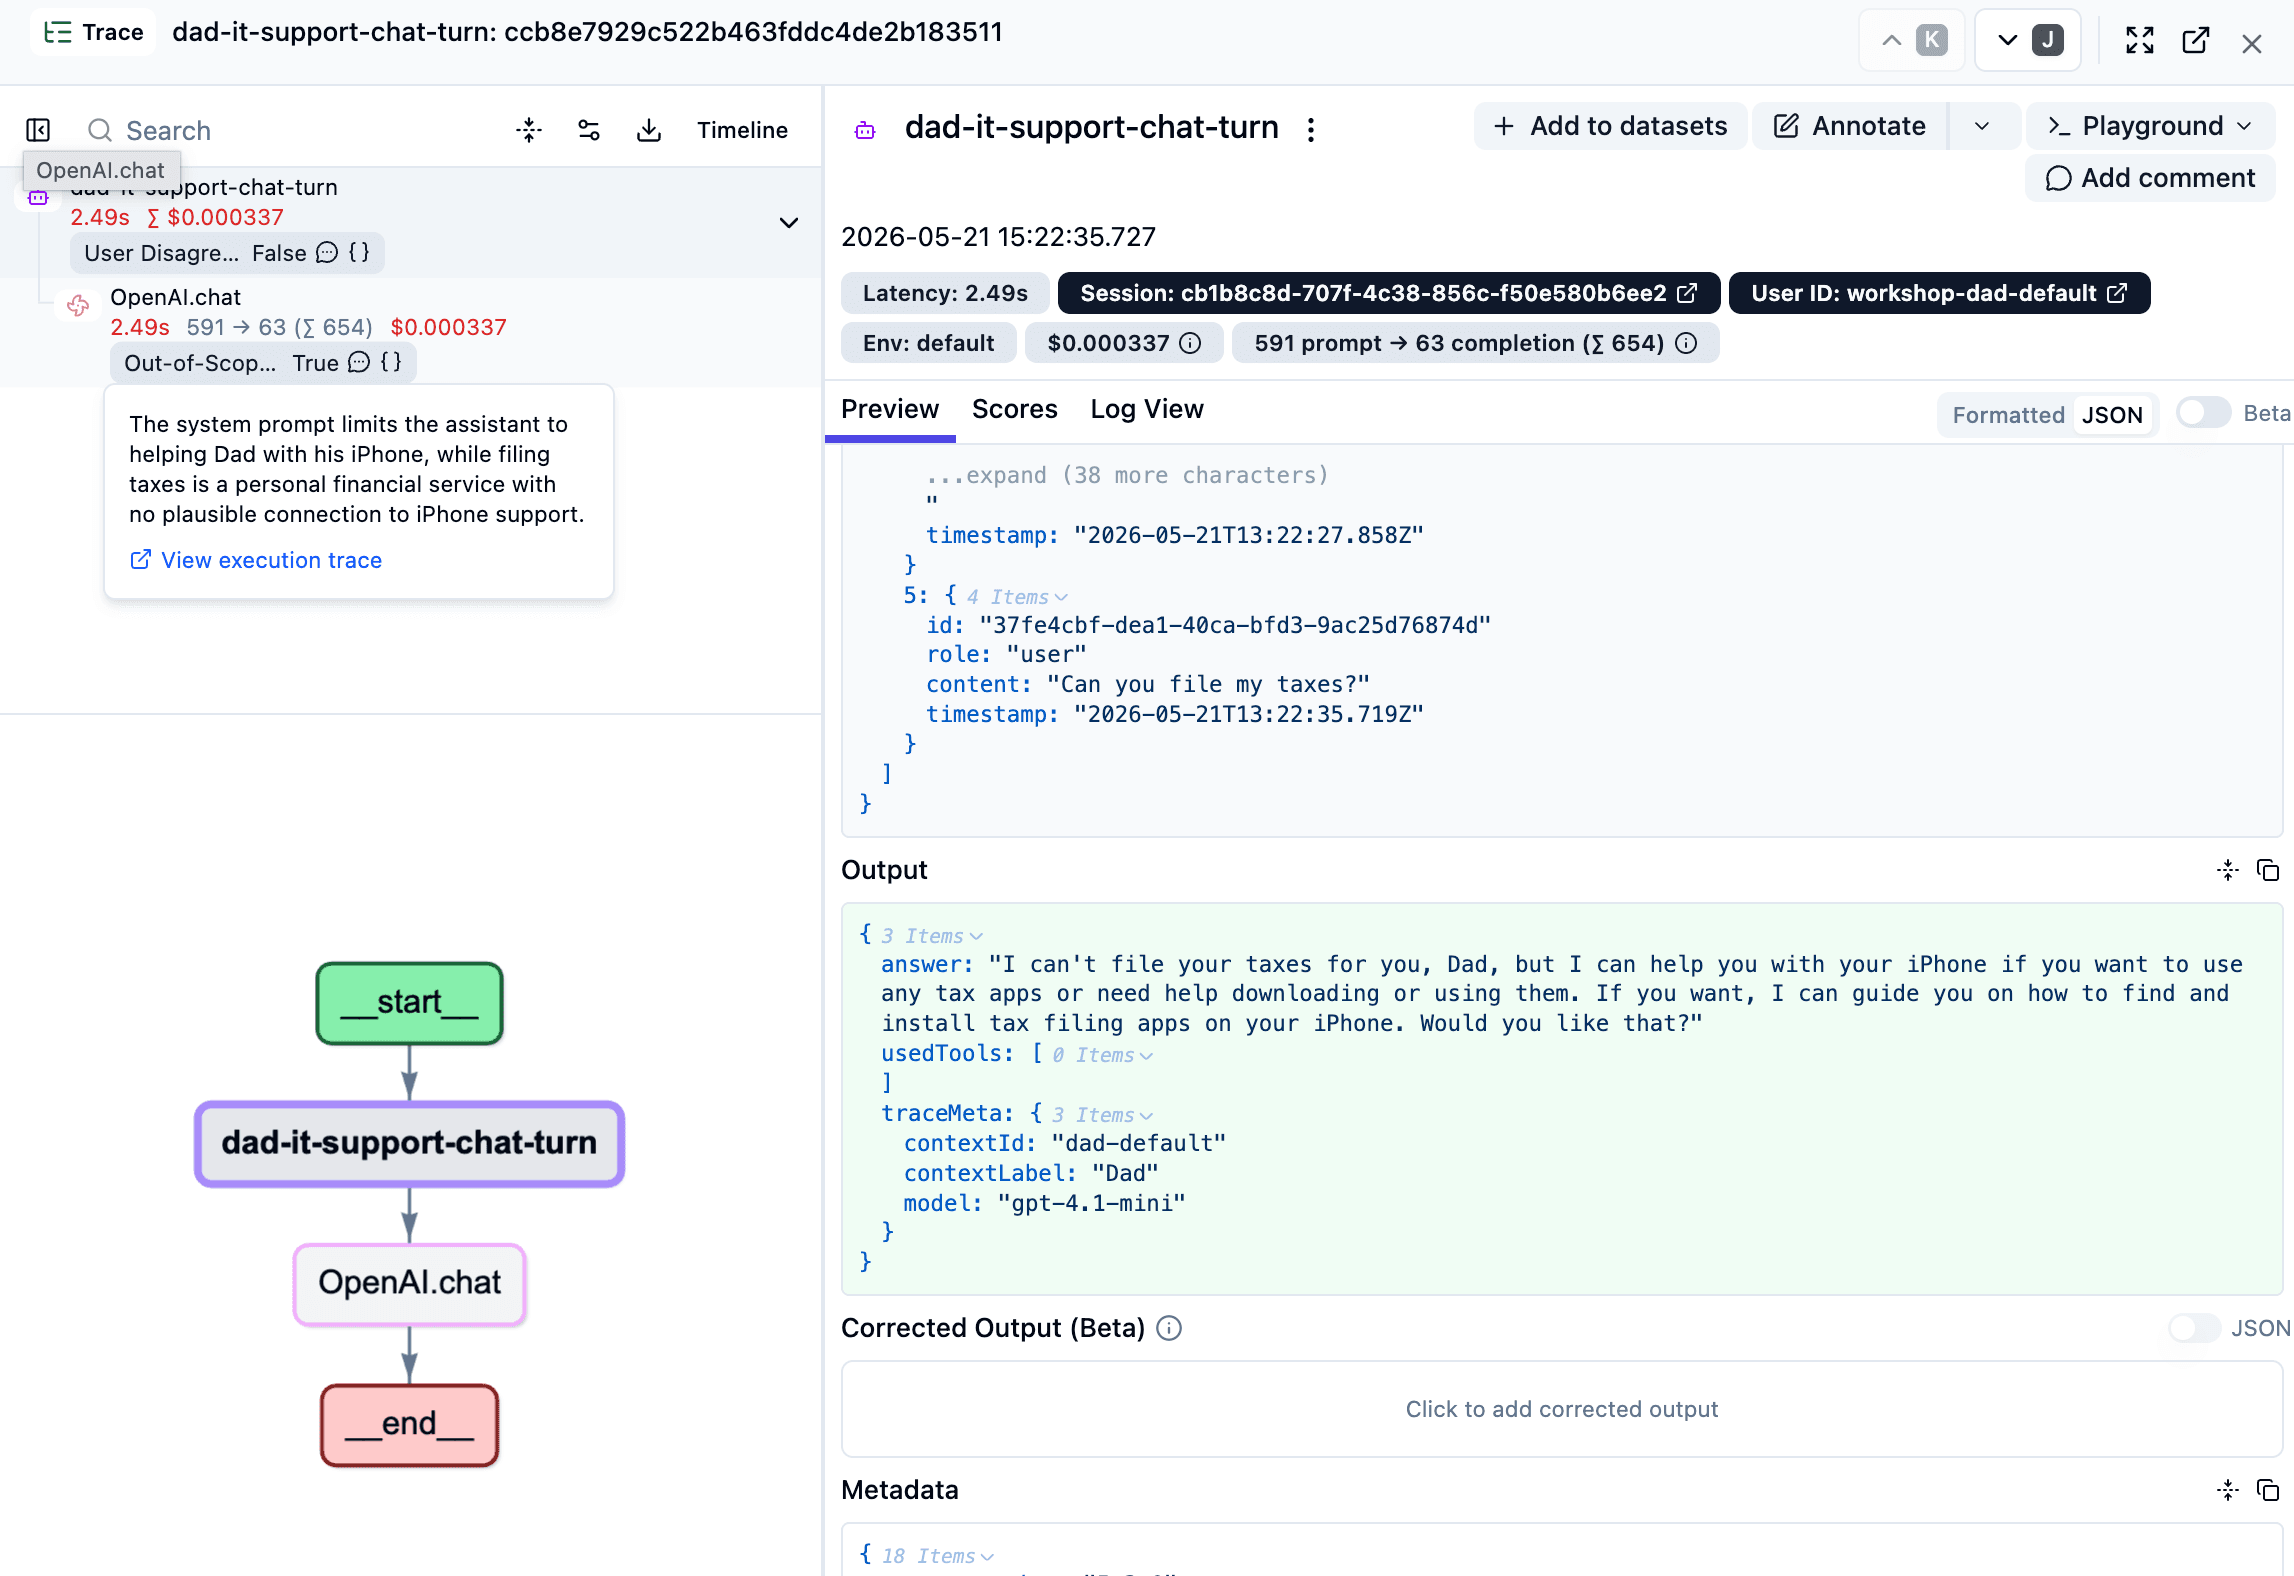
Ketika monitor out-of-scope menyala, Anda dapat mengkonfirmasi chatbot sudah menolak permintaan dengan elegan — persis apa yang kami minta untuk dilakukannya. Tetapi jejak itu juga merupakan jejak paling menarik untuk dibaca dari akhir ke akhir: aliran hit out-of-scope yang stabil sering kali merupakan sinyal awal bahwa ada cakupan tambahan yang layak ditangani. "Bisakah Anda mengajukan pajak saya?" itu konyol, tetapi "Bantu saya memindahkan foto ke iPad baru saya" mungkin permintaan fitur nyata yang tersembunyi dalam output monitor.
Ketidaksetujuan pengguna adalah acara signal yang jauh lebih tinggi. Ketika pengguna membantah jawaban yang baru saja diberikan agen, sesuatu hampir pasti salah — hasil alat yang salah, konteks yang hilang, instruksi yang tidak cocok dengan iPhone yang mereka gunakan. Ini adalah jejak yang ingin Anda baca terlebih dahulu, dan mereka adalah kandidat utama untuk berubah menjadi item dataset untuk 05-dataset.
Sinyal all-caps sengaja lebih kasar. Ini bukan klaim bahwa pengguna pasti marah; itu hanya petunjuk deterministik murah bahwa percakapan mungkin tidak berjalan dengan baik. Itu membuat monitor "tinjau yang pertama" yang baik, terutama ketika dipasangkan dengan judge ketidaksetujuan dan out-of-scope yang lebih kaya.
Benih lalu lintas produksi dan tonton monitor menyala
Empat giliran yang diketik dengan tangan membuktikan kabelnya bekerja. Tetapi pemantauan menghasilkan nilai pada volume — jadi mari kita sekarang benih batch data produksi realistis dan lihat apa yang terjadi.
npm run langfuse:seed:otel:no-scoresIni memutar ulang snapshot lalu lintas "Dukungan IT Dad" nyata — ditambah beberapa kasus tepi sintetis (permintaan out-of-scope, pesan ALL-CAPS, dan "tidak, menu itu tidak ada di sana" ketidaksetujuan) — ke lingkungan production proyek Langfuse Anda. Ini menggunakan kembali kunci Langfuse yang sudah ada di .env dan menggeser setiap stempel waktu sehingga jejak terbaru mendarat di "sekarang".
Varian :no-scores menabur jejak tanpa skor yang sudah dipanggang. Itu seluruh pooin: evaluator Anda sudah aktif, jadi skor yang muncul berasal dari monitor Anda berjalan melawan lalu lintas segar ini — bukan dari angka yang dipanggang ke dalam benih.
⚠️ Benihnya bukan idempoten. OpenTelemetry mencetak ID jejak segar pada setiap jalankan, jadi menjalankan kembali menggandakan data. Jalankan sekali; jika Anda memerlukan status bersih, hapus jejak benih sebelumnya di Langfuse sebelum menabur lagi.
Sekarang buka Tracing, saring ke lingkungan production, dan segarkan setelah beberapa detik. Tonton skor mendarat di seluruh batch yang ditabur saat evaluator mengunyah — kasus tepi out-of-scope, all-caps, dan ketidaksetujuan naik persis seperti giliran yang Anda kirim dengan tangan, hanya dalam skala. Itu adalah apa yang akan terlihat seperti monitor Anda melawan lalu lintas nyata, dan itu adalah tumpukan jejak yang ditandai yang akan Anda tambang untuk bab berikutnya.
Kesimpulan
Monitor yang baik adalah cara Anda memisahkan sinyal dari kebisingan. Produksi berarti banyak jejak, dan pertanyaan paling penting adalah mana yang harus saya lihat? — monitor menjawab itu.
Setelah Anda memiliki monitor permintaan-sinyal di tempat, langkah selanjutnya dari waktu ke waktu adalah pelacakan metrik rata-rata — memilih metrik kualitas dan menonton mereka bergeser. Cara yang tepat untuk memilih metrik itu adalah analisis kesalahan: lihat sampel jejak mengejutkan yang Anda tangkap sekarang, kelompokkan mereka berdasarkan mode kegagalan, dan ubah mode kegagalan menjadi evaluator. Pelajaran pemantauan di Akademi masuk lebih dalam tentang ini.
Jejak yang Anda tangkap dengan monitor ini juga merupakan sumber terbaik untuk langkah selanjutnya — 05-dataset — karena mereka contoh nyata dari perilaku yang ingin Anda kunci atau perbaiki.
Status akhir
Ini adalah titik awal untuk 05-dataset.
03 Manajemen Prompt
Anda memiliki aplikasi yang terlacak dengan baik. Prompt sistem hidup sebagai konstanta bernama SYSTEMPROMPT di src/server/support-agent.ts dan digunakan langsung sebagai pesan sistem.
05 Kumpulan Data
Anda memiliki aplikasi terlacak, beratribut, dan dipantau. data/seed-dataset.json dan scripts/seed-dataset.ts sudah ada di repo di checkpoint ini.