02 衡量质量
用 Langfuse 的 evaluators、数据集和 trace,逐题、逐档位地看清冠军到底有多好。
起点
模块 01 已完成:Arena 已跑过,Leaderboard 有数据,你也有了一个
获胜的 config_id(<model>__<prompt>,例如 claude-sonnet-5__P1_zeroshot)。
为什么
赢下 Arena 只告诉你某个配置在总量上于每个正确答案的成本这项指标上胜过了其他配置。 它不会告诉你它怎么赢的、它最弱的地方在哪,也不会告诉你它的 SQL 是 仅仅正确,还是真的写得好。在你基于这个模型继续做事(改进它、发布 它)之前,值得先理解它,就像你不只想知道一个 候选人通过了面试,还想知道哪些题他答得漂亮、哪些是 勉强过关。Langfuse 里已经有了你需要的一切:模块 01 的 evaluators 给每个条目都打了分,而每个条目都有完整的 trace。本模块讲的是 读懂这些细节,而不是产生新数据。
概念:底层原理
Trace → observations → scores。 Langfuse 用同一种方式组织 agent 的每一次 运行:
- 一条 trace 就是一次 agent 运行,一次
model × prompt × question执行,命名为agent_run,并用config_id打标签。 - Observations 是那条 trace 内部的 span。这里只有一个
llm_call,它是一个 generation 类型的 observation,承载模型调用的 prompt、completion 和 token 用量。 Experiment Item 的输出记录了 leaderboard 所用的精确端到端成本和延迟。 SQL 执行这一步没有单独的 observation,SQL 是作为一次普通的 ClickHouse 调用执行的,没有属于自己的 Langfuse span; 生成的 SQL 及其结果集落在 trace 根节点的 input/output 上。 - Scores 是模块 01 里那些 evaluators 事后附加到 trace/数据集条目上的东西:
correctness(二元执行准确率)、agent-arena-llm-judge(分级的 LLM-as-a-judge SQL 质量),以及一个outcome类别。Langfuse evaluator 定义名是llm_judge;它实际写出、harness 等待的 score 名准确地是agent-arena-llm-judge。
每条 trace 都是一次 agent_run,带有一个子 observation,即 llm_call generation,外加 Langfuse 的 evaluators 在打分后附上的三个 score:correctness、agent-arena-llm-judge 和 outcome。
档位(Tiers)。 源语料包含 20 个 YAML 问题,但 q019 和 q020 是 few-shot
保留样例。在全新项目中,初始化到 arena-golden 的 18 个实验问题各有一个 tier,从 1
(最简单,单表计数和过滤)到 5(最难,多表 join、
漏斗、毛利计算)。之所以要有逐档位准确率,是因为一个配置的整体
数字可能用亮眼的 tier-1/2 表现掩盖 tier-5 的崩盘。
Outcome 类别。 Langfuse 的 correctness Code Evaluator
(eval/langfuse_evaluators/correctness_evaluator.py)会把每个已完成的
Experiment Item 归入下列之一,按答案"走到多远"的顺序排列:
| Outcome | 它的含义 |
|---|---|
correct | 结果集与黄金结果集一致。 |
model_error | 在生成任何 SQL 之前,OpenRouter 调用本身就失败了(密钥错误/过期、限流、provider 故障)。 |
sql_policy_rejected | agents/sqlguard.py 在生成的 SQL 到达 ClickHouse 之前就拦下了它(不是单条 SELECT,或命中了禁用关键字)。 |
sql_exec_error | SQL 到了 ClickHouse,但查询执行失败(语法错误、列名不存在等)。 |
empty_but_expected | 查询跑通了但返回零行,而黄金答案有行。 |
wrong_result | 查询跑通并返回了行,但与黄金结果集不一致。 |
每一种都对应不同的修法:sql_policy_rejected 的运行需要一个更好的 system prompt
来强调保持只读;sql_exec_error 通常意味着方言差距(见
P3_dialect);empty_but_expected 和 wrong_result 通常意味着过滤、join 或
聚合的逻辑错误。
目标
能够熟练阅读你获胜配置的逐档位准确率和 outcome 分布,
理解辅助的 agent-arena-llm-judge 信号在原始
correctness 之上补充了什么,并且能从 leaderboard 的一行下钻到任意一个问题
背后那条确切的 Langfuse trace。
步骤 1:阅读逐档位准确率和 outcome 分布
打开 http://localhost:5174 → Leaderboard,点进你获胜配置的 那一行。除了准确率、延迟和每个正确答案的成本,每个配置还会展示:
- 逐档位准确率:
arena-golden里的问题按难度档位分组; 一个整体看起来很强的配置在最难的档位上仍可能不稳,而这 正是聚合数字最容易掩盖的那类差距。 - Outcome 分布:并不是每个非正确答案都以同样的方式失败。有些 SQL 被 沙箱拒绝,有些返回 ClickHouse 错误,有些返回空 结果,有些只是返回了错误的结果集。每一种都是不同的问题, 修法也不同。
怎么读它。 逐档位准确率是一张小表或一组条形图,tier
1–5 各一行,从右往左扫,看数字在哪里掉下来;一个在
tier 1–2 上近乎完美、到 tier 4–5 就断崖的配置,是在告诉你它处理简单查找
没问题,但在 join 和多步聚合上吃力。Outcome 分布是每个类别的
计数(correct、sql_policy_rejected、sql_exec_error、
empty_but_expected、wrong_result),一堆 sql_exec_error 指向方言
问题,一堆 wrong_result 指向逻辑问题,两者需要
不同的修法。
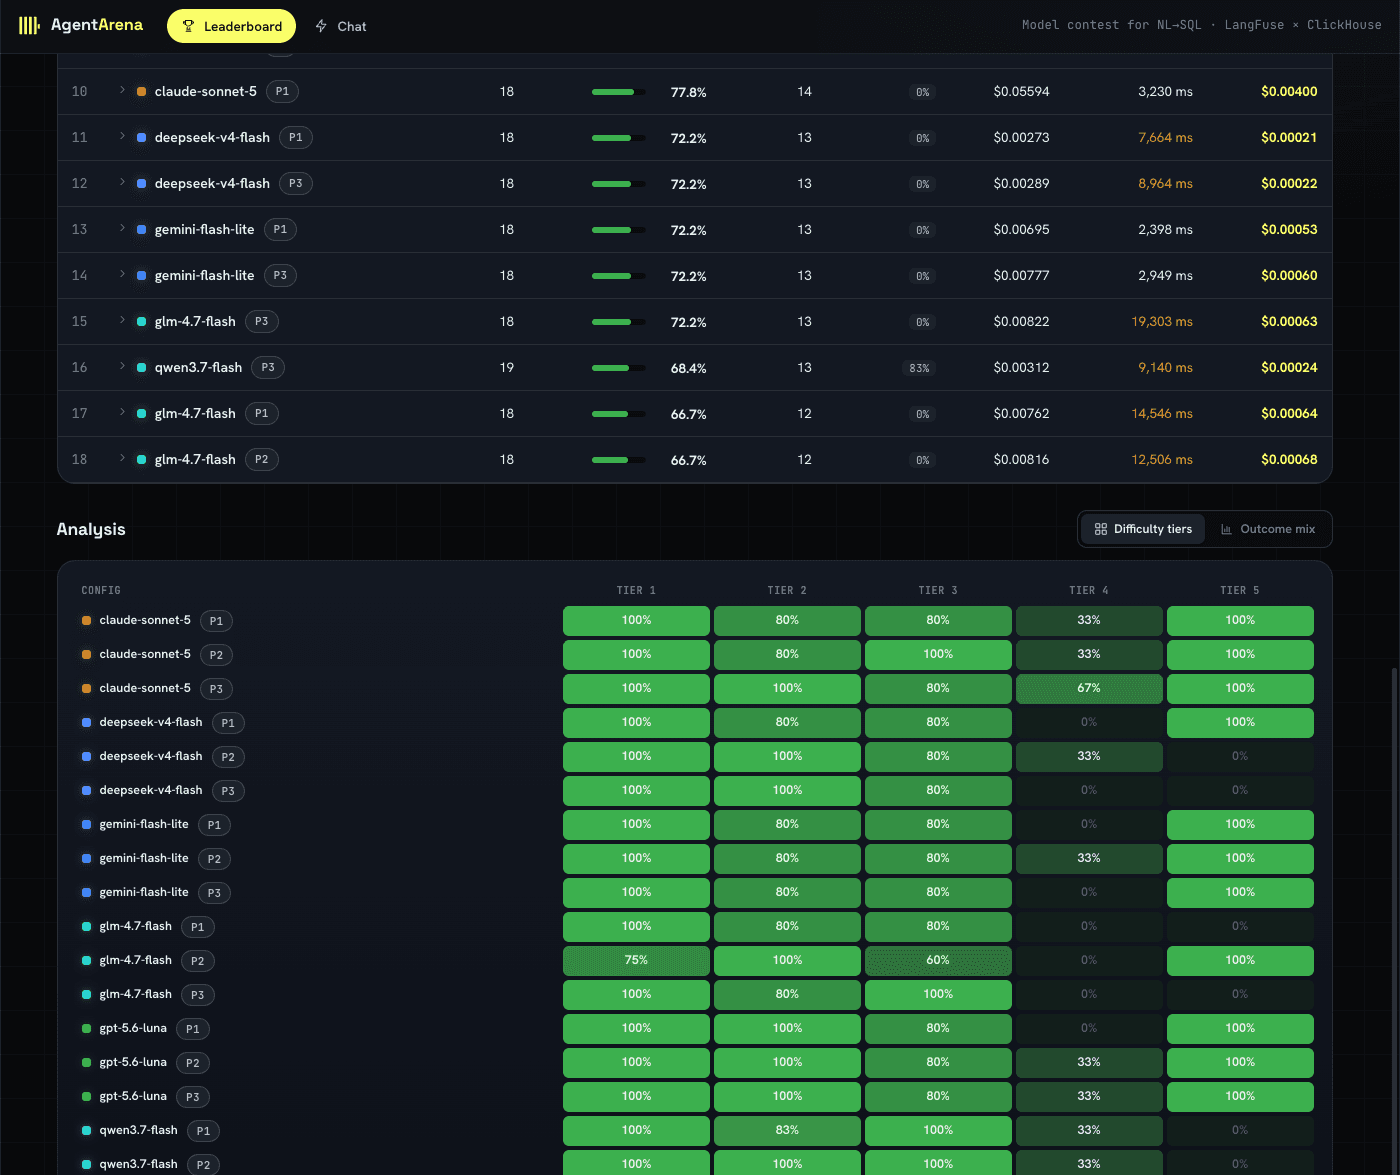
Difficulty tiers 视图暴露出被整体准确率掩盖的规律。在这次运行里,大多数 配置在 tier 1–3 上都很强,而 tier 4 是最明显的共同短板;对比 各行,看看获胜配置是否也有同样的下滑。
步骤 2:阅读 agent-arena-llm-judge 这个辅助信号
correctness score 是二元的:结果集是否匹配,是或不是。你在
模块 01 里配置的 evaluator 定义 llm_judge 所输出的
agent-arena-llm-judge score 是一个辅助的、
更细粒度的信号,在那个二元结果之上,用 LLM-as-a-judge 给 SQL 质量打分。
一个配置可以在执行准确率上正确,同时写出的 SQL 却是
审阅者会挑出来的(多余的子查询、脆弱的日期比较、一个恰好
在这份数据上返回正确行、但换个数据就不成立的 join)。用
agent-arena-llm-judge 来发现"通过"和"写得好"之间的差距。
步骤 3:下钻到单条 trace
从 leaderboard 的某一行点进它的逐题结果,然后点开任意一个
问题打开它的 Langfuse trace。每条 trace 都携带该问题的完整路径:
发给模型的 prompt、生成的 SQL、模型的 llm_call
generation(prompt、completion 和 token 计数)、Experiment Item 上的精确成本和端到端
延迟,以及,如果这个问题失败了,返回的 ClickHouse
错误。这就是同一种
读 trace 的技能,等到 模块 04 里问题开始来自真实用户而不是
黄金数据集时,你还会再用一次。
挑两三个你获胜配置答错(或者 agent-arena-llm-judge 分数低)的问题,
把它们的 trace 从头到尾读一遍。你要找的是规律:某种
表述、某种 join、某种日期过滤,是模型一贯处理不好的。
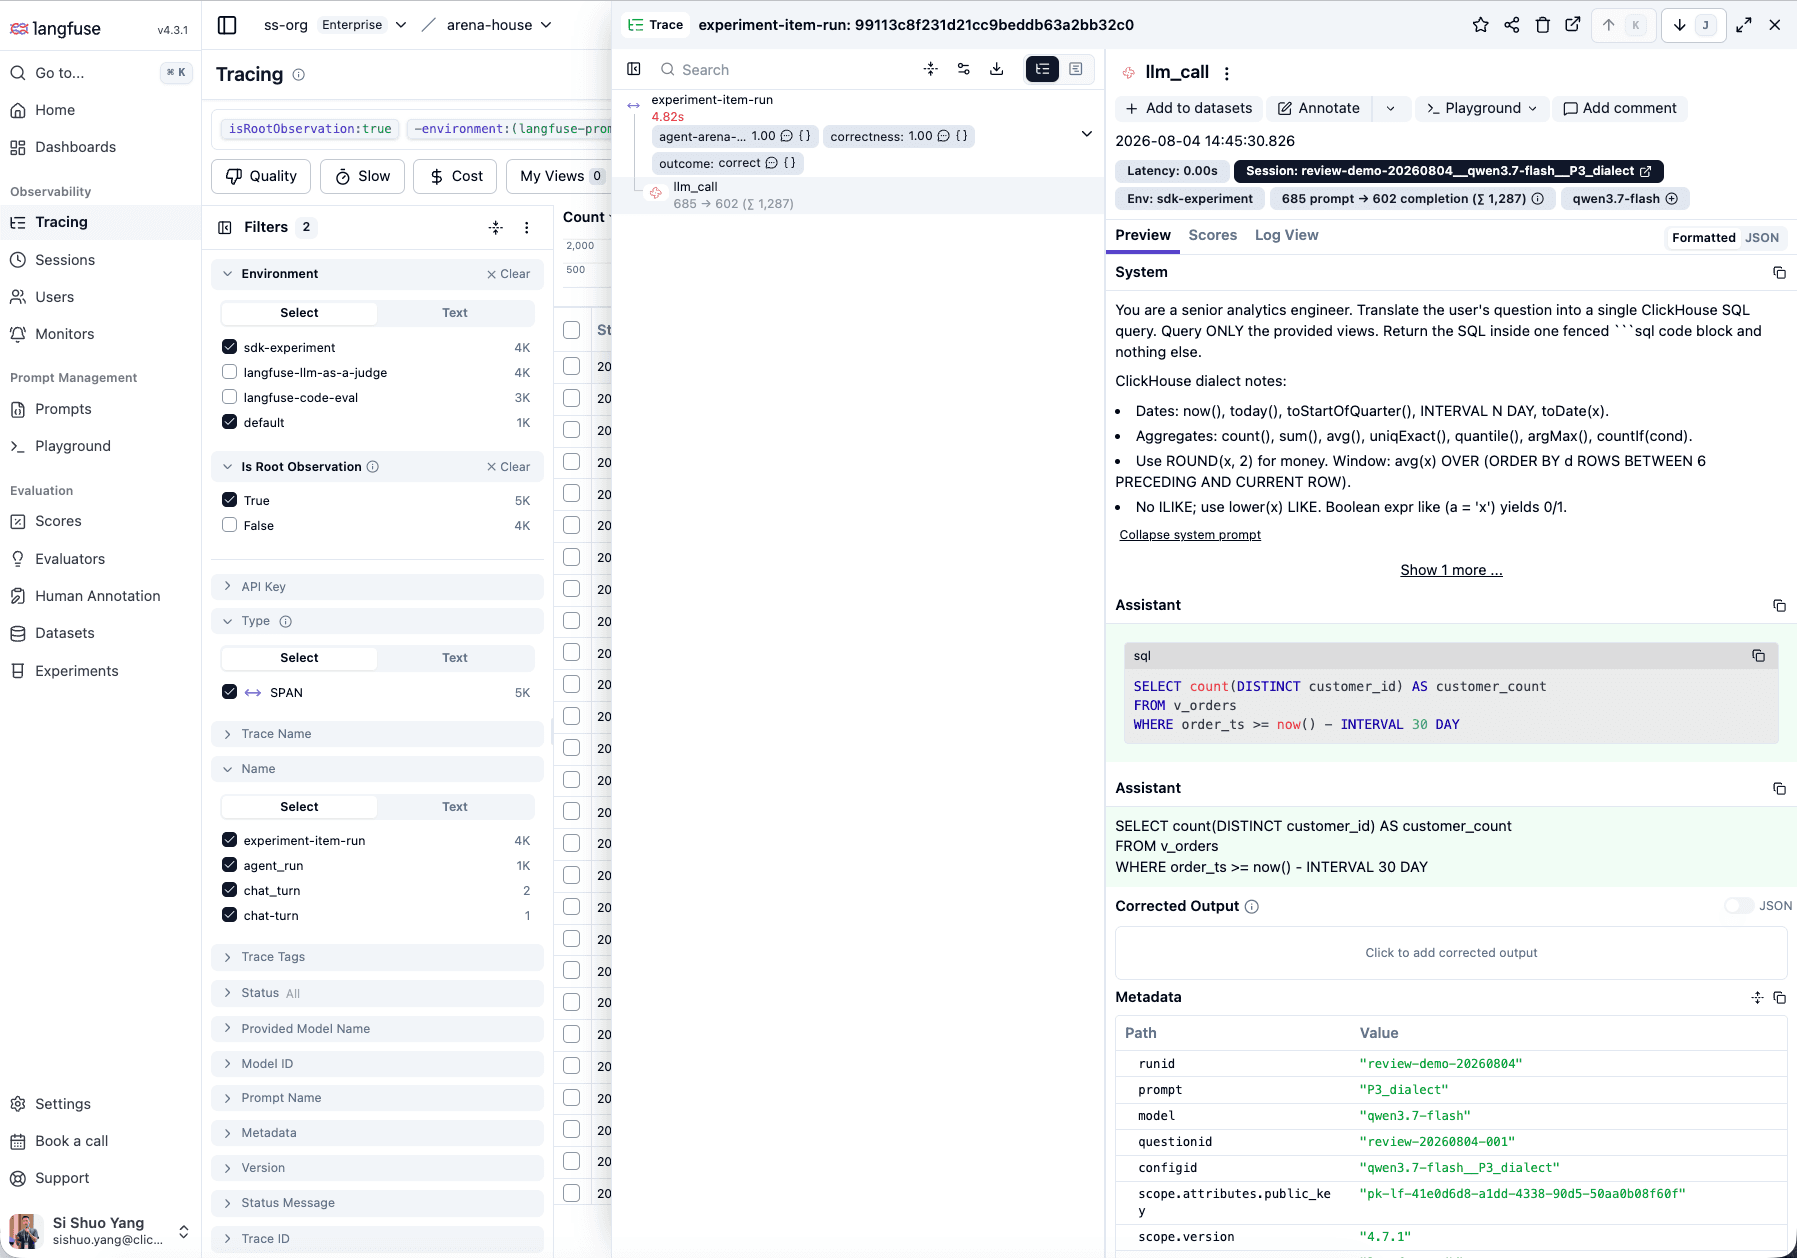
一个 Langfuse Experiment Item 把 trace 顶部的那些 score 与它下面确切的
llm_call 连接起来。详情面板显示 prompt、生成的 SQL、token 用量、
延迟和运行元数据,足以解释这个问题为什么通过或失败。
如何确认你已完成
- 你能说出获胜配置在至少某一个具体档位上的准确率,而不只是 它的整体数字。
- 你能指出至少一个
correctness和agent-arena-llm-judge结论不一致的问题, 或者说明为什么在你这次运行里它们没有分歧。 - 你至少打开过一条 Langfuse trace,并能针对那个问题把 prompt → 生成的 SQL → 结果或错误讲一遍。
练习:拆解并诊断一种失败模式
把步骤 3 的读 trace 变成一份可以交给 模块 03 的书面产出:
-
从你获胜配置的逐题结果里,挑 2–3 个要么
correctness = 0、要么agent-arena-llm-judge得分低的问题。 -
对每一个,打开它的 Langfuse trace 并填好下表中的一行:
问题 它生成了什么 为什么失败 Outcome 类别 (问题文本) (它产出的 SQL,简要写) (你的判断:join 错了、缺日期过滤、读错了表述……) ( sql_exec_error/wrong_result/ ……) -
横向看你这 2–3 行,找出重复出现的规律,同一类 join、同一种 日期过滤错误、同一种模型一贯读错的表述。这里要的是一个 规律,而不是一串互不相关的 bug。
你找到的那个规律会成为模块 03 的种子:把观察到的失败 变成能锁定修复效果的新黄金数据。
小结
现在你不只知道你的配置赢了,还知道它怎么赢的,强在哪、弱在 哪,以及它的失败在 trace 层面到底长什么样。正是这些细节 接下来会变成行动。
终态
你获胜配置的一幅详细质量画像。继续前往 03 发布并发现问题,把你的发现变成新的 黄金数据。