02 품질 측정
Langfuse 평가자, 데이터셋, 트레이스를 사용해 승자가 실제로 얼마나 좋은지 질문별·티어별로 확인합니다.
시작 지점
Module 01 완료: Arena가 실행되었고, Leaderboard가 채워졌고, 승리한 config_id
(<model>__<prompt>, 예: claude-sonnet-5__P1_zeroshot)를 갖고 있습니다.
왜
Arena에서 이겼다는 것은 어떤 구성이 총합적으로 정답당 비용에서 나머지를 앞섰다는 뜻입니다. 그것이 어떻게 이겼는지, 어디가 가장 약한지, 그 SQL이 단지 정답인지 실제로 좋은지는 알려주지 않습니다. 이 모델 위에 무언가를 쌓기(개선하기, 릴리스하기) 전에 그것을 이해할 가치가 있습니다. 후보자가 면접을 통과했다는 사실만이 아니라 어떤 질문을 완벽히 답했고 어떤 질문을 겨우 넘겼는지 알고 싶은 것과 마찬가지입니다. Langfuse에는 이를 위한 모든 것이 이미 있습니다. Module 01의 평가자가 모든 항목을 채점했고, 모든 항목에는 전체 트레이스가 있습니다. 이 모듈은 새 데이터를 만드는 것이 아니라 그 디테일을 읽는 것입니다.
개념 — 내부 동작
트레이스 → 관측(observation) → 점수. Langfuse는 에이전트의 모든 실행을 같은 방식으로 구조화합니다.
- 트레이스는 한 번의 에이전트 실행입니다. 하나의
model × prompt × question실행이며,agent_run이라는 이름을 갖고config_id로 태그됩니다. - 관측은 그 트레이스 안의 스팬입니다. 여기서는
llm_call하나뿐이며, 모델 호출의 프롬프트, 컴플리션, 토큰 사용량을 담은 generation 관측입니다. Experiment Item 출력에는 리더보드가 사용하는 정확한 종단 간 비용과 지연 시간이 기록됩니다. SQL 실행 단계에 대한 별도 관측은 없습니다. SQL은 자체 Langfuse 스팬 없이 평범한 ClickHouse 호출로 실행되며, 생성된 SQL과 그 결과 집합은 대신 트레이스 루트의 input/output에 남습니다. - 점수는 Module 01의 평가자가 사후에 트레이스/데이터셋 항목에 붙이는 것입니다.
correctness(이진 실행 정확도),agent-arena-llm-judge(등급으로 나타낸 LLM-as-a-judge SQL 품질), 그리고outcome카테고리입니다. Langfuse 평가자 정의는llm_judge이고, 이 정의가 내보내며 하네스가 기다리는 정확한 점수 이름은agent-arena-llm-judge입니다.
모든 트레이스는 하나의 agent_run이며 자식 관측은 llm_call generation 하나입니다. 여기에 Langfuse의 평가자가 채점 후 붙이는 세 개의 점수 correctness, agent-arena-llm-judge, outcome이 더해집니다.
티어. 원본 코퍼스에는 YAML 질문이 20개 있지만 q019와 q020은 few-shot holdout입니다.
깨끗한 프로젝트의 arena-golden에 시딩된 18개 Experiment 질문에는 각각 1(가장 단순 — 단일 테이블 카운트와 필터)부터
5(가장 어려움 — 다중 테이블 조인, 퍼널, 마진 계산)까지의 tier가 있습니다. 티어별 정확도가 존재하는
이유는, 강한 티어 1/2 성능 뒤에 티어 5의 붕괴가 숨을 수 있기 때문입니다.
Outcome 카테고리. Langfuse correctness Code Evaluator
(eval/langfuse_evaluators/correctness_evaluator.py)는 완료된 모든 Experiment Item을, 답이 얼마나
"멀리" 갔는지 순서대로 다음 중 하나로 분류합니다.
| Outcome | 의미 |
|---|---|
correct | 결과 집합이 골든 결과 집합과 일치합니다. |
model_error | SQL이 생성되기도 전에 OpenRouter 호출 자체가 실패했습니다(잘못되거나 만료된 키, 레이트 리밋, 프로바이더 장애). |
sql_policy_rejected | agents/sqlguard.py가 생성된 SQL이 ClickHouse에 도달하기 전에 차단했습니다(단일 SELECT가 아니거나 금지 키워드에 걸림). |
sql_exec_error | SQL이 ClickHouse에 도달했지만 쿼리 실행에 실패했습니다(문법 오류, 알 수 없는 컬럼 등). |
empty_but_expected | 쿼리는 실행되었고 0행을 반환했지만, 골든 답에는 행이 있습니다. |
wrong_result | 쿼리는 실행되어 행을 반환했지만, 골든 결과 집합과 일치하지 않습니다. |
각각은 서로 다른 해결책을 함의합니다. sql_policy_rejected 실행은 읽기 전용을 유지하라는 더 나은
시스템 프롬프트가 필요하고, sql_exec_error는 보통 방언 격차를 뜻하며(P3_dialect 참고),
empty_but_expected와 wrong_result는 보통 필터, 조인, 집계 로직 오류를 뜻합니다.
목표
승리한 구성의 티어별 정확도와 outcome 분포를 편하게 읽을 수 있고, 보조 신호인 agent-arena-llm-judge가 원시
correctness 위에 무엇을 더하는지 이해하며, 리더보드 행에서 임의의 한 질문 뒤에 있는 정확한 Langfuse
트레이스까지 파고들 수 있는 상태.
Step 1 — 티어별 정확도와 outcome 분포 읽기
http://localhost:5174 → Leaderboard를 열고 승리한 구성의 행으로 들어가세요. 정확도, 지연 시간, 정답당 비용과 함께 각 구성은 다음을 보여줍니다.
- 티어별 정확도 —
arena-golden의 질문들은 난이도 티어로 묶여 있습니다. 전체적으로 강해 보이는 구성도 가장 어려운 티어에서는 흔들릴 수 있고, 그것이 바로 총합 수치가 숨기는 종류의 격차입니다. - Outcome 분포 — 정답이 아닌 답이 모두 같은 방식으로 실패하는 것은 아닙니다. 어떤 SQL은 샌드박스에서 거부되고, 어떤 것은 ClickHouse 오류를 반환하고, 어떤 것은 빈 결과를 반환하고, 어떤 것은 그냥 잘못된 결과 집합을 반환합니다. 각각은 서로 다른 종류의 문제이고 해결책도 다릅니다.
읽는 방법. 티어별 정확도는 티어 15마다 한 행씩 있는 작은 표 또는 막대 묶음입니다. 오른쪽에서
왼쪽으로 훑어 수치가 떨어지는 지점을 찾으세요. 티어 12에서 거의 완벽하다가 티어 4~5에서 절벽처럼
떨어지는 구성은, 단순 조회는 잘 처리하지만 조인과 다단계 집계에서 고생한다는 뜻입니다. Outcome
분포는 카테고리별 개수(correct, sql_policy_rejected, sql_exec_error,
empty_but_expected, wrong_result)입니다. sql_exec_error가 쌓여 있으면 방언 문제를 가리키고,
wrong_result가 쌓여 있으면 로직 문제를 가리키며, 둘은 서로 다른 해결책을 요구합니다.
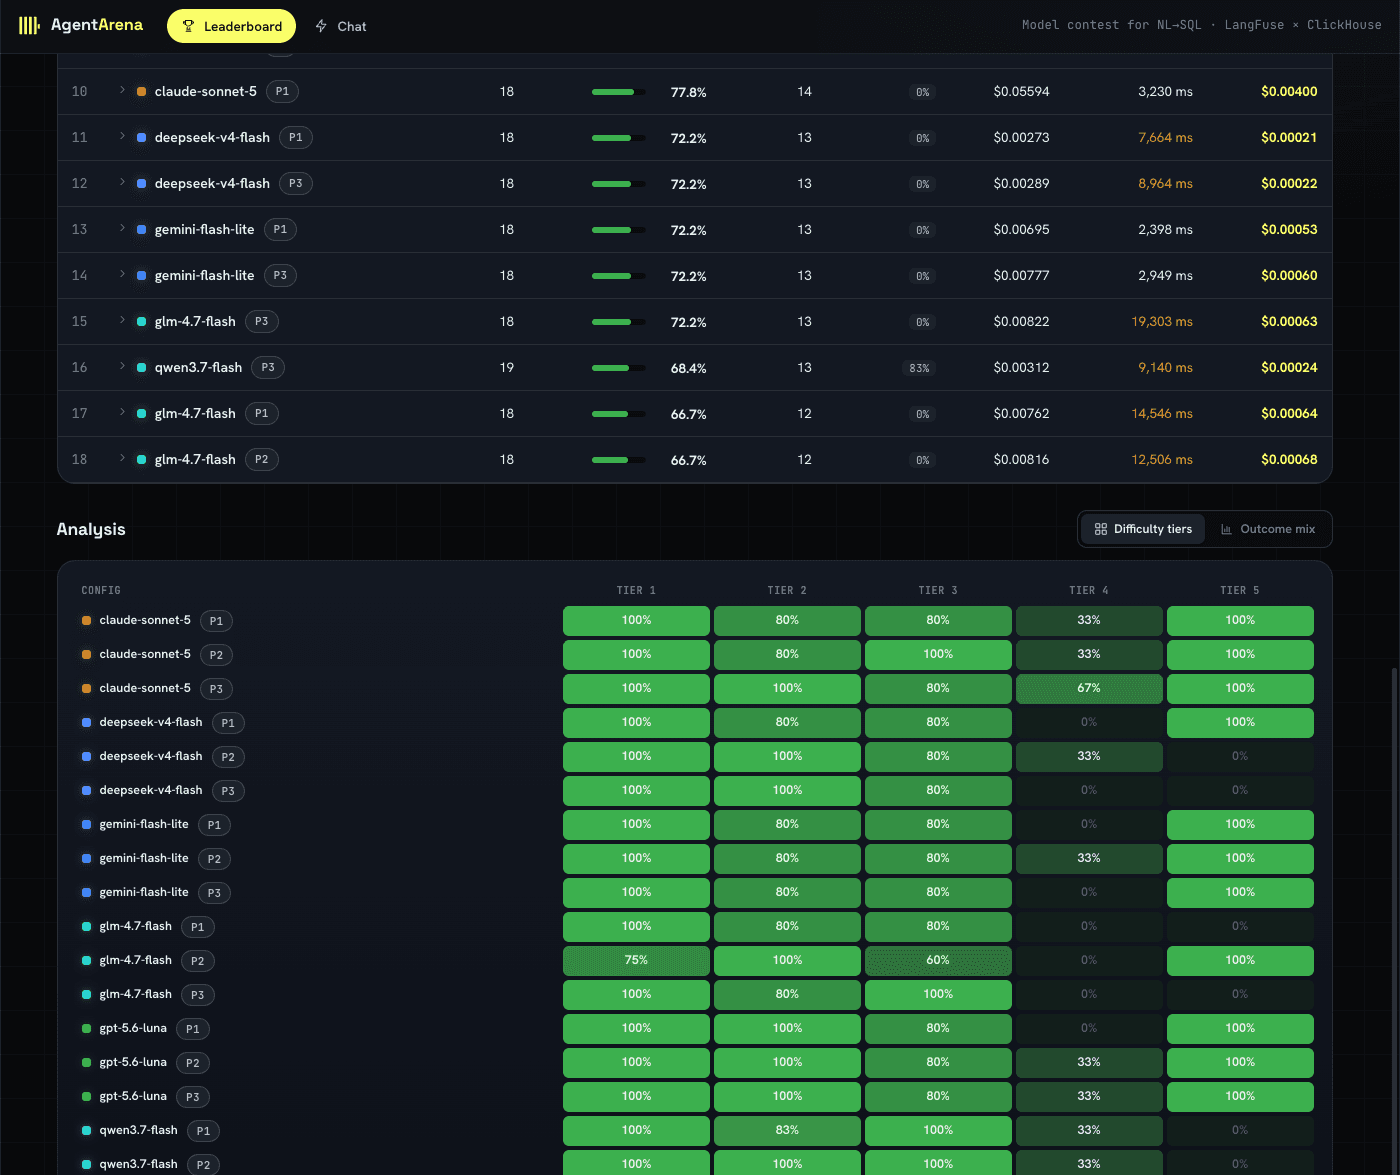
Difficulty tiers 뷰는 전체 정확도가 숨기는 패턴을 드러냅니다. 이 실행에서는 대부분의 구성이 티어 1~3에서 강하고, 티어 4가 공통적으로 가장 뚜렷한 약점입니다. 승리한 구성도 같은 하락을 보이는지 행을 비교해 보세요.
Step 2 — agent-arena-llm-judge 보조 신호 읽기
correctness 점수는 이진입니다. 결과 집합이 일치하는가, 예 또는 아니오입니다.
Module 01에서 구성한 평가자 정의 llm_judge가 내보내는
agent-arena-llm-judge 점수는 그 이진 결과 위에
얹히는, 더 세밀한 보조 신호입니다. SQL 품질에 대한 LLM-as-a-judge 평가입니다. 어떤 구성은 실행
정확도로는 정답이면서도 리뷰어라면 지적할 SQL을 쓸 수 있습니다(불필요한 서브쿼리, 취약한 날짜 비교,
이 데이터에서는 우연히 맞는 행을 내지만 일반화되지 않는 조인). agent-arena-llm-judge를 사용해 "통과했다"와
"잘 작성되었다" 사이의 그 격차를 찾아내세요.
Step 3 — 개별 트레이스 파고들기
리더보드 행에서 질문별 결과로 이동한 뒤, 아무 질문을 클릭해 그 Langfuse 트레이스를 여세요. 각
트레이스는 그 질문의 전체 경로를 담고 있습니다. 모델에 보낸 프롬프트, 생성된 SQL, 모델의 llm_call
generation(프롬프트, 컴플리션, 토큰 수), Experiment Item에 기록된 정확한 비용과 종단 간 지연 시간,
그리고 질문이 실패했다면 되돌아온 ClickHouse 오류까지입니다. 이것은 골든 데이터셋 대신 실제 사용자로부터
질문이 들어오기 시작하는 Module 04에서 다시 쓰게 될
트레이스 읽기 기술과 같습니다.
승리한 구성이 틀린(또는 agent-arena-llm-judge 점수가 낮은) 질문 두세 개를 골라 그 트레이스를 처음부터 끝까지
읽어 보세요. 찾고 있는 것은 패턴입니다. 모델이 일관되게 잘못 처리하는 표현, 조인, 날짜 필터입니다.
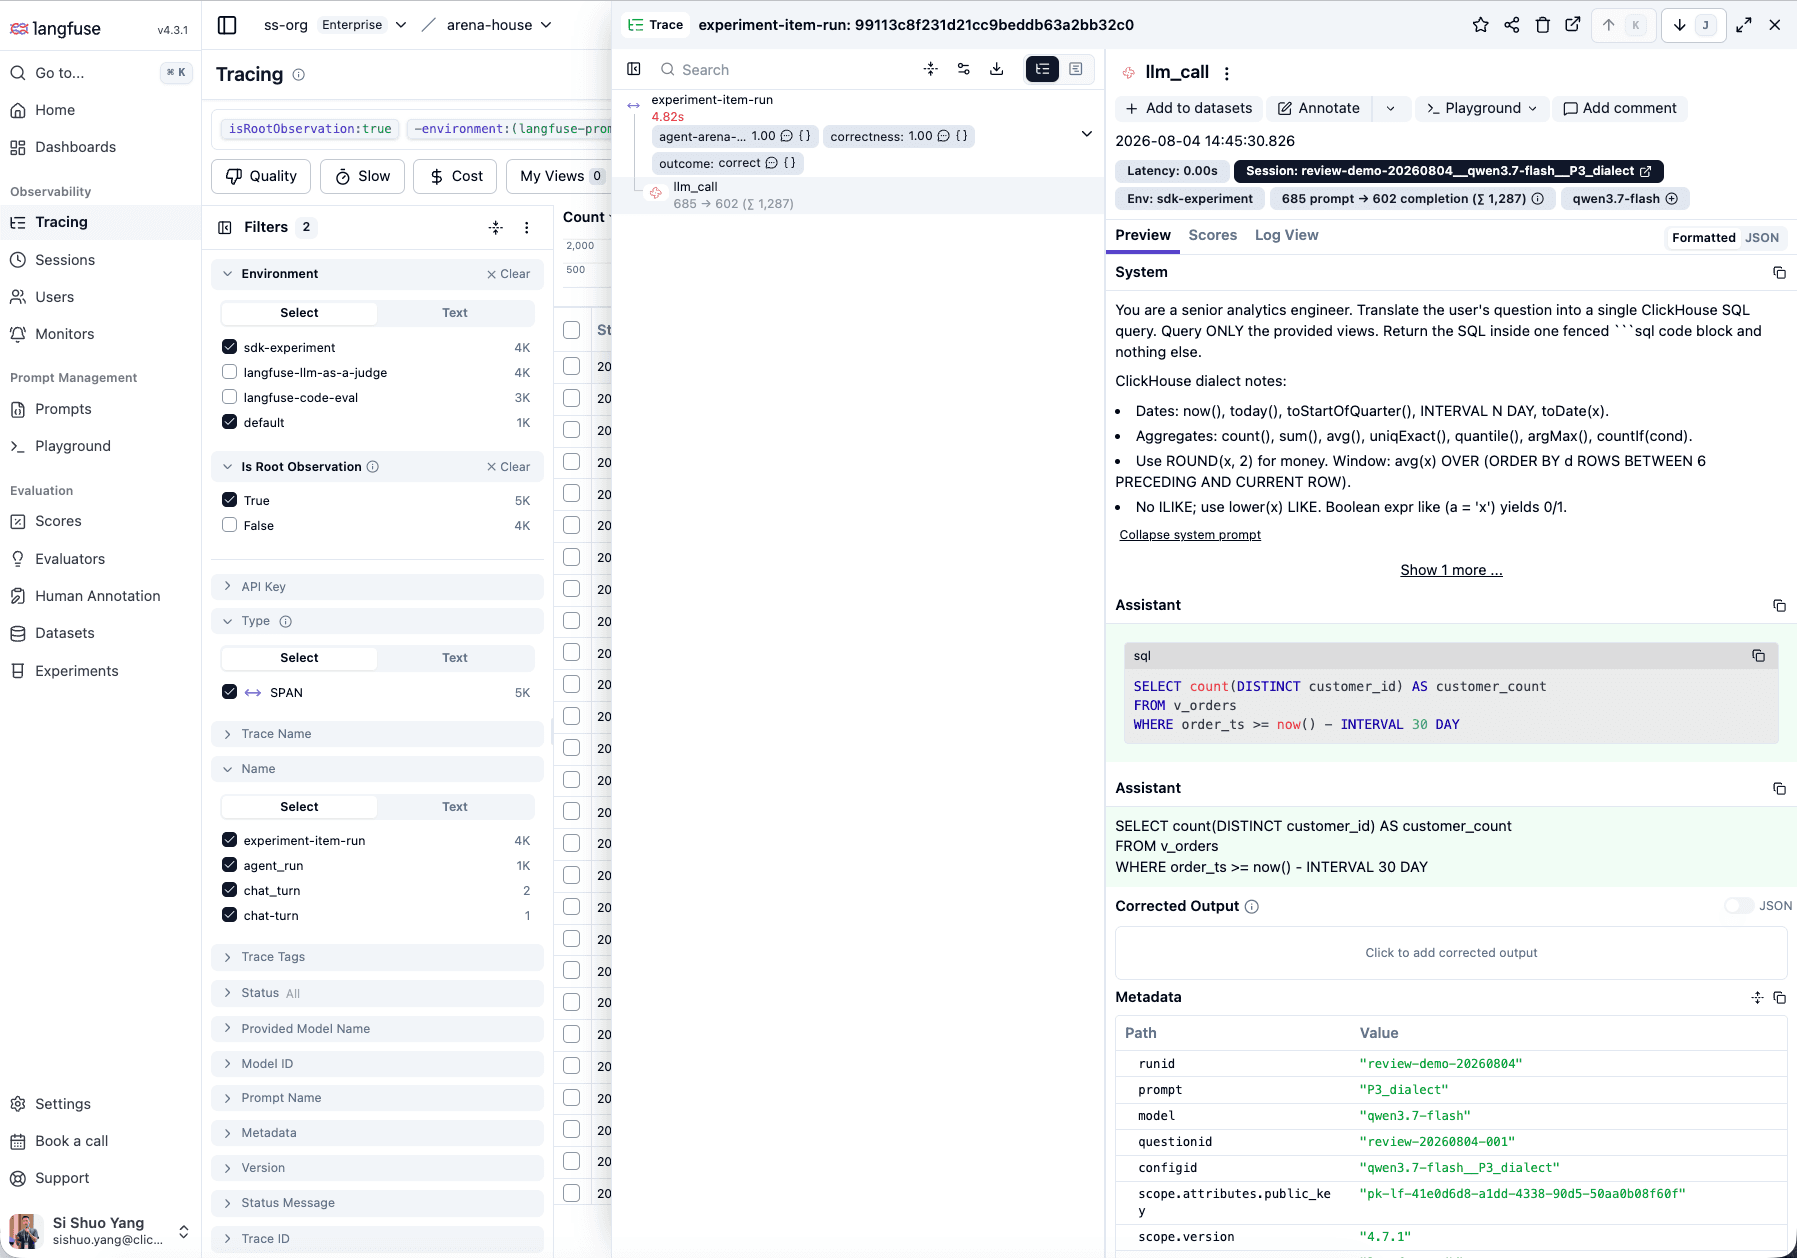
Langfuse Experiment Item은 트레이스 상단의 점수를 그 아래의 정확한
llm_call과 연결합니다. 상세 패널은 이 질문이 왜 통과했거나 실패했는지 설명하는 데 필요한
프롬프트, 생성된 SQL, 토큰 사용량, 지연 시간, 실행 메타데이터를 보여줍니다.
완료 확인 방법
- 승리한 구성의 전체 수치만이 아니라, 최소 한 개의 특정 티어에서의 정확도를 말할 수 있다.
correctness와agent-arena-llm-judge가 엇갈리는 질문을 최소 하나 지적할 수 있거나, 여러분의 실행에서는 왜 엇갈리지 않는지 설명할 수 있다.- Langfuse 트레이스를 최소 하나 열어 보았고, 그 질문에 대해 프롬프트 → 생성된 SQL → 결과 또는 오류를 따라 설명할 수 있다.
실습 — 실패 패턴을 망가뜨려 보고 진단하기
Step 3의 트레이스 읽기를 Module 03에 넘길 수 있는 문서 형태로 만드세요.
-
승리한 구성의 질문별 결과에서
correctness = 0이거나agent-arena-llm-judge점수가 낮은 질문 2~3개를 고르세요. -
각각에 대해 Langfuse 트레이스를 열고 이 표의 한 행을 채우세요.
질문 무엇을 생성했나 왜 실패했나 Outcome 카테고리 (질문 텍스트) (생성한 SQL, 짧게) (여러분의 판단: 잘못된 조인, 빠진 날짜 필터, 표현 오독, …) ( sql_exec_error/wrong_result/ …) -
2~3개 행을 가로질러 반복되는 패턴을 찾으세요. 같은 종류의 조인, 같은 날짜 필터 실수, 모델이 일관되게 잘못 읽는 같은 표현입니다. 서로 무관한 버그 목록이 아니라 하나의 패턴이 여기서 원하는 것입니다.
여러분이 찾아낸 패턴은 Module 03의 씨앗이 됩니다. 관찰된 실패를, 해결책을 못 박아 두는 새로운 골든 데이터로 바꾸는 것입니다.
정리
이제 여러분의 구성이 이겼다는 사실만이 아니라 어떻게 이겼는지 알게 되었습니다. 어디가 강하고, 어디가 약하며, 그 실패가 트레이스 수준에서 실제로 어떤 모습인지 말입니다. 그 디테일이 바로 다음 단계에서 행동으로 바뀝니다.
최종 상태
승리한 구성에 대한 상세한 품질 그림. 찾아낸 것을 새로운 골든 데이터로 바꾸려면 03 릴리스하고 감지하기으로 넘어가세요.