02 追踪
这是跟踪步骤的白板 — 与 checkpoint/01-base-app 相同的代码,还没有 Langfuse 接线。Langfuse 包已在 package.json 中 — 运行 npm inst...
研讨会材料在公共 langfuse/langfuse-workshop 存储库中维护。使用存储库获取可运行的应用、检查点分支和本地设置。
起点
git checkout checkpoint/02-tracing这是跟踪步骤的白板 — 与 checkpoint/01-base-app 相同的代码,还没有 Langfuse 接线。Langfuse 包已在 package.json 中 — 如果你还没有,请运行 npm install。确保 .env 有你的 OPENAI_API_KEY 和 Langfuse 密钥。
为什么我们跟踪
跟踪记录你的代理采取的每一步 — 每个模型调用、每个工具调用、输入的输入和返回的输出 — 按它们发生的顺序。它将代理从黑盒变成可以打开并在事后检查的东西,所以当答案错误时,你可以指向错误发生的确切步骤,而不是猜测。
如果你想了解更大的动机,请参见 Langfuse Academy 关于跟踪的课程。如果你想了解技术细节(SDK 选项、OpenTelemetry 内部、span 属性),跟踪文档 涵盖了这一点。
目标
当 Dad 问"我如何打开蓝牙?"时,代理不只是调用一次 OpenAI。幕后它询问 OpenAI 做什么,调用 get_support_context 来获取 Dad 的 iPhone 设置,再次询问 OpenAI,为蓝牙步骤调用 search_help_library,然后再询问一次 OpenAI 以生成编号答案。今天这些都不可见。
本章的目标是使 Langfuse 中的每一步都可见 — 一个聊天转折变成一个嵌套跟踪,其中代理运行、OpenAI 生成和两个工具调用都按顺序记录。
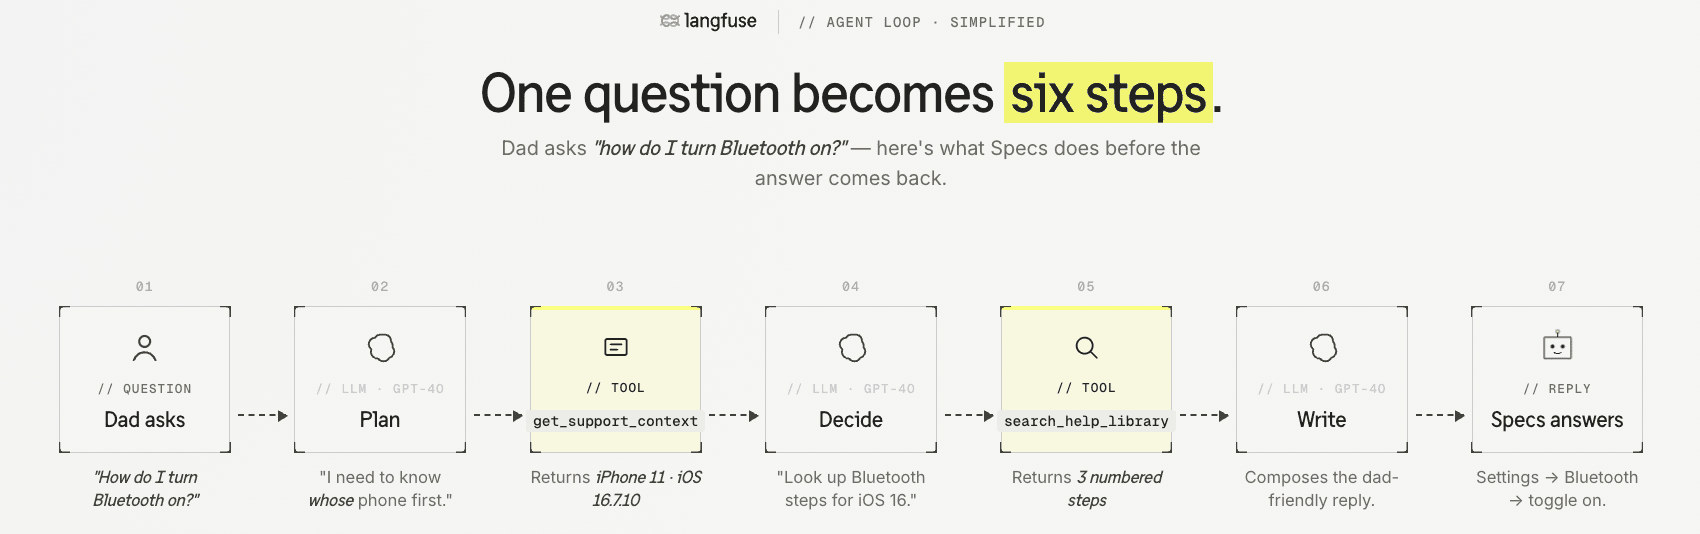
我们将分三个步骤构建跟踪,这些步骤反映代理的结构:
- 首次跟踪 — 记录 OpenAI 生成本身。
- 嵌套跟踪 — 将生成分组到每个转折的一个代理运行中。
- 记录工具调用 — 使每个工具调用成为自己的观测。
步骤 1 — 首次跟踪
我们想要 OpenAI 调用的可观测性,以查看输入和输出是什么,以及花费、令牌和时间。两个更改已足够。
src/server/index.ts
在文件顶部附近启动 Langfuse span 处理器:
import { NodeSDK } from "@opentelemetry/sdk-node";
import { LangfuseSpanProcessor } from "@langfuse/otel";

new NodeSDK({ spanProcessors: [new LangfuseSpanProcessor()] }).start();
处理器从 Node 进程环境读取 LANGFUSE_PUBLIC_KEY、LANGFUSE_SECRET_KEY 和 LANGFUSE_BASE_URL。在本研讨会中,服务器在 Langfuse SDK 启动前加载存储库 .env,所以请编辑 .env 而不是依赖导出的 shell 值。
旁注:如果最后一个跟踪有时在你停止或重启 npm run dev 时出现晚,请回到 index.ts 并将上面的单行变成命名的 langfuseSpanProcessor 和 sdk 变量,以便 shutdown() 可以刷新它们:
const langfuseSpanProcessor = new LangfuseSpanProcessor();
const sdk = new NodeSDK({ spanProcessors: [langfuseSpanProcessor] });
sdk.start();

async function shutdown() {
  server.close();
  await langfuseSpanProcessor.forceFlush();
  await sdk.shutdown();
}
你不需要这个来理解跟踪模型,但它避免了在本地开发中令人困惑的"我的最后一个跟踪去哪里了?"时刻。
src/server/support-agent.ts
添加导入:
import { observeOpenAI } from "@langfuse/openai";然后 在创建 OpenAI 客户端的地方包装它。在 runSupportConversation 中找到此行:
const openai = new OpenAI({ apiKey: env.openaiApiKey });将其更改为:
const openai = observeOpenAI(new OpenAI({ apiKey: env.openaiApiKey }));这就是整个差异。没有工厂函数,没有单独的原始客户端 — observeOpenAI 在调用站点处内联包装 OpenAI 客户端,下面的 openai.chat.completions.create(...) 现在为每个调用生成一个跟踪。
验证: npm run dev,提一个问题,刷新 Langfuse — 你应该看到每个 OpenAI 调用一个生成,包含提示词、响应、令牌和延迟。每个生成仍然是其自己的顶级跟踪;我们接下来修复这个。
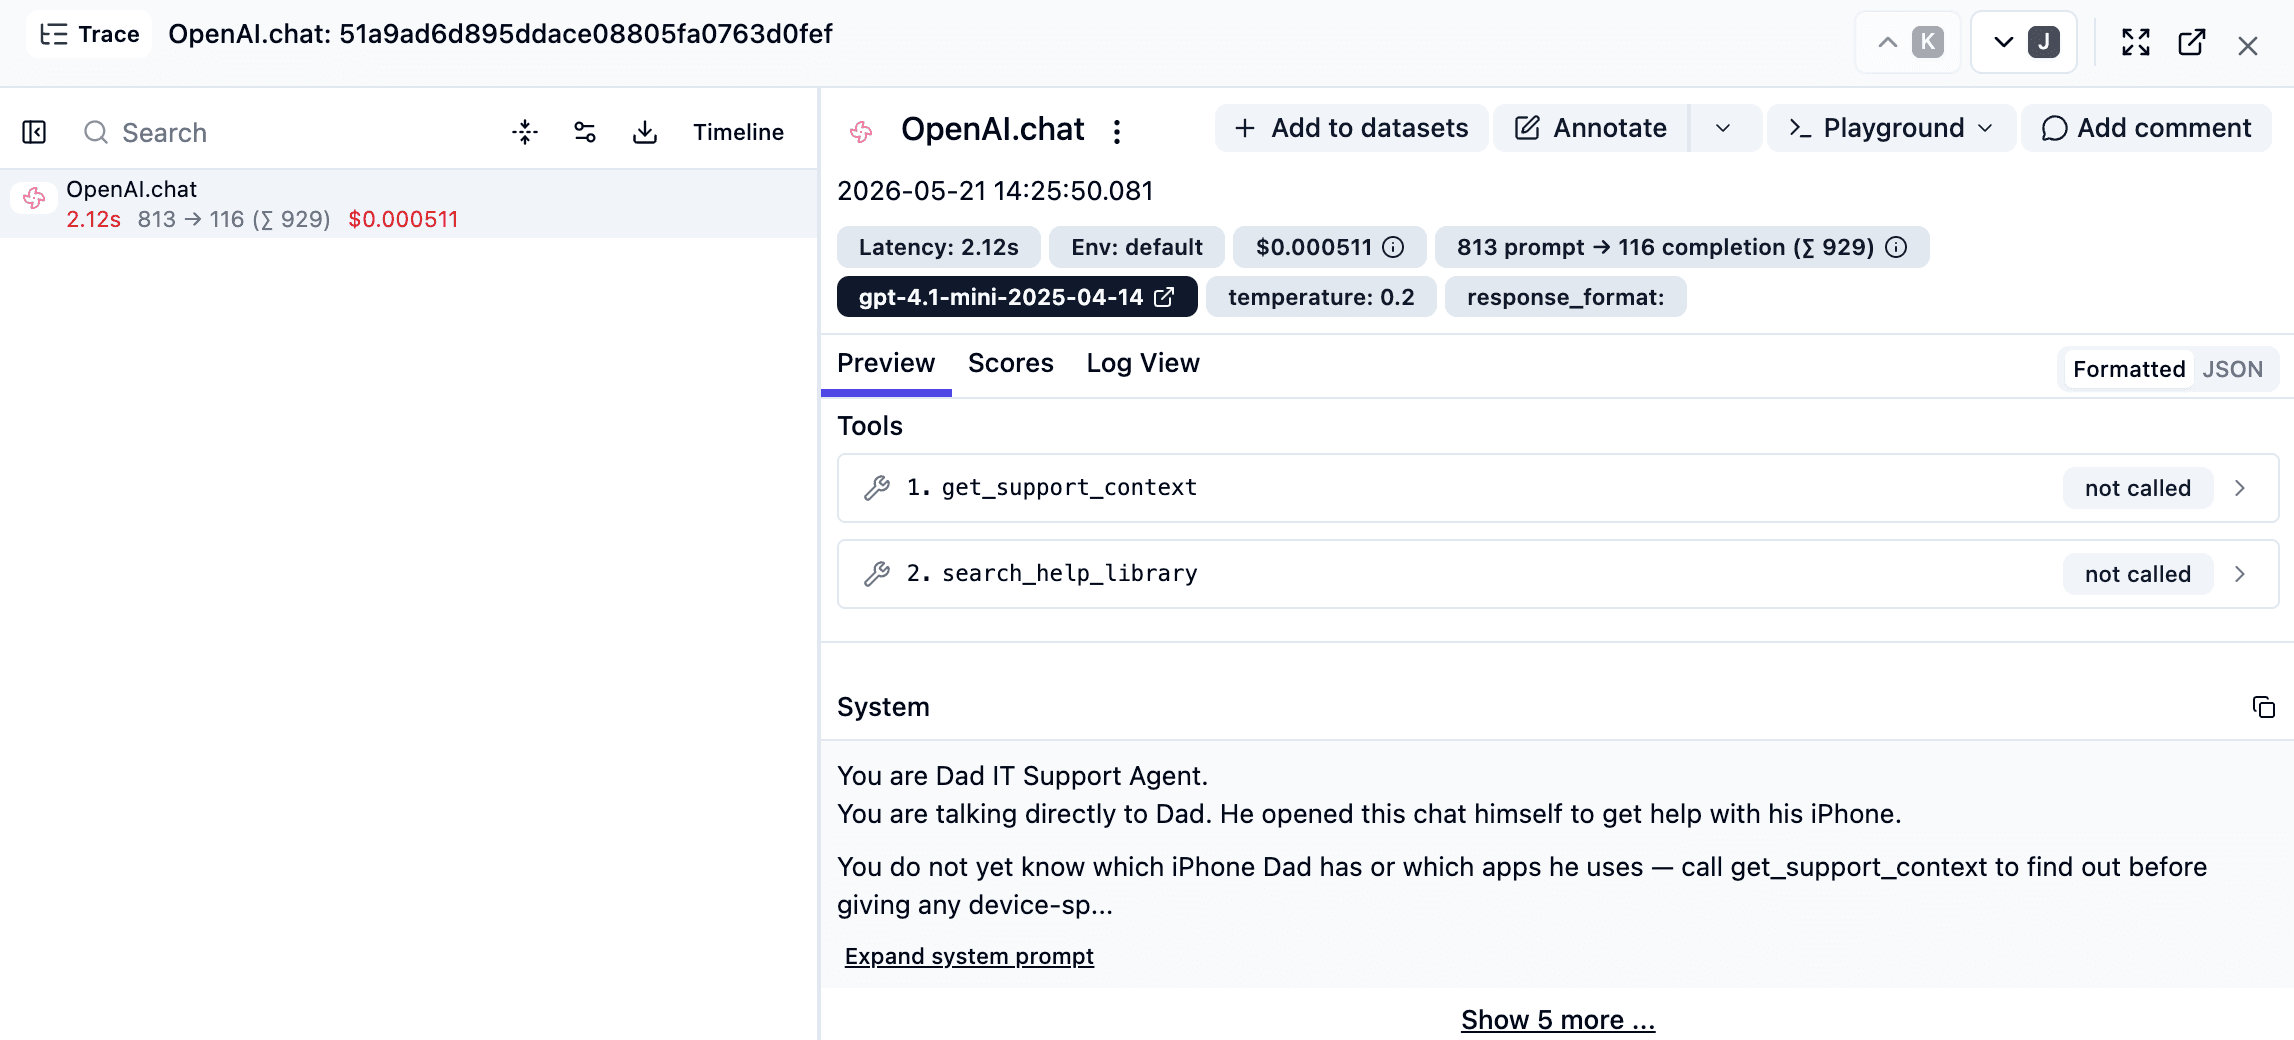
步骤 2 — 嵌套跟踪
要将生成放入上下文中,我们在每个转折的一个代理运行中对它们进行分组。在 src/server/support-agent.ts 中进行三个编辑 — 无需更改函数体。
1. 添加导入:
import { observe } from "@langfuse/tracing";2. 降低现有函数。 找到:
export async function runSupportConversation(request: ChatRequest): Promise<ChatResponse> {删除 export 并重新命名:
async function runSupportConversationInner(request: ChatRequest): Promise<ChatResponse> {函数体保持完全一致。
3. 在文件底部添加包装的导出:
export const runSupportConversation = observe(runSupportConversationInner, {
  name: "dad-it-support-chat-turn",
  asType: "agent"
});
index.ts 仍然以相同方式导入 runSupportConversation。observe(...) 自动捕获函数参数作为跟踪输入,返回值作为跟踪输出。
验证: 一个聊天转折现在应该显示为单个 dad-it-support-chat-turn 观测,其中 OpenAI 生成嵌套在其下。
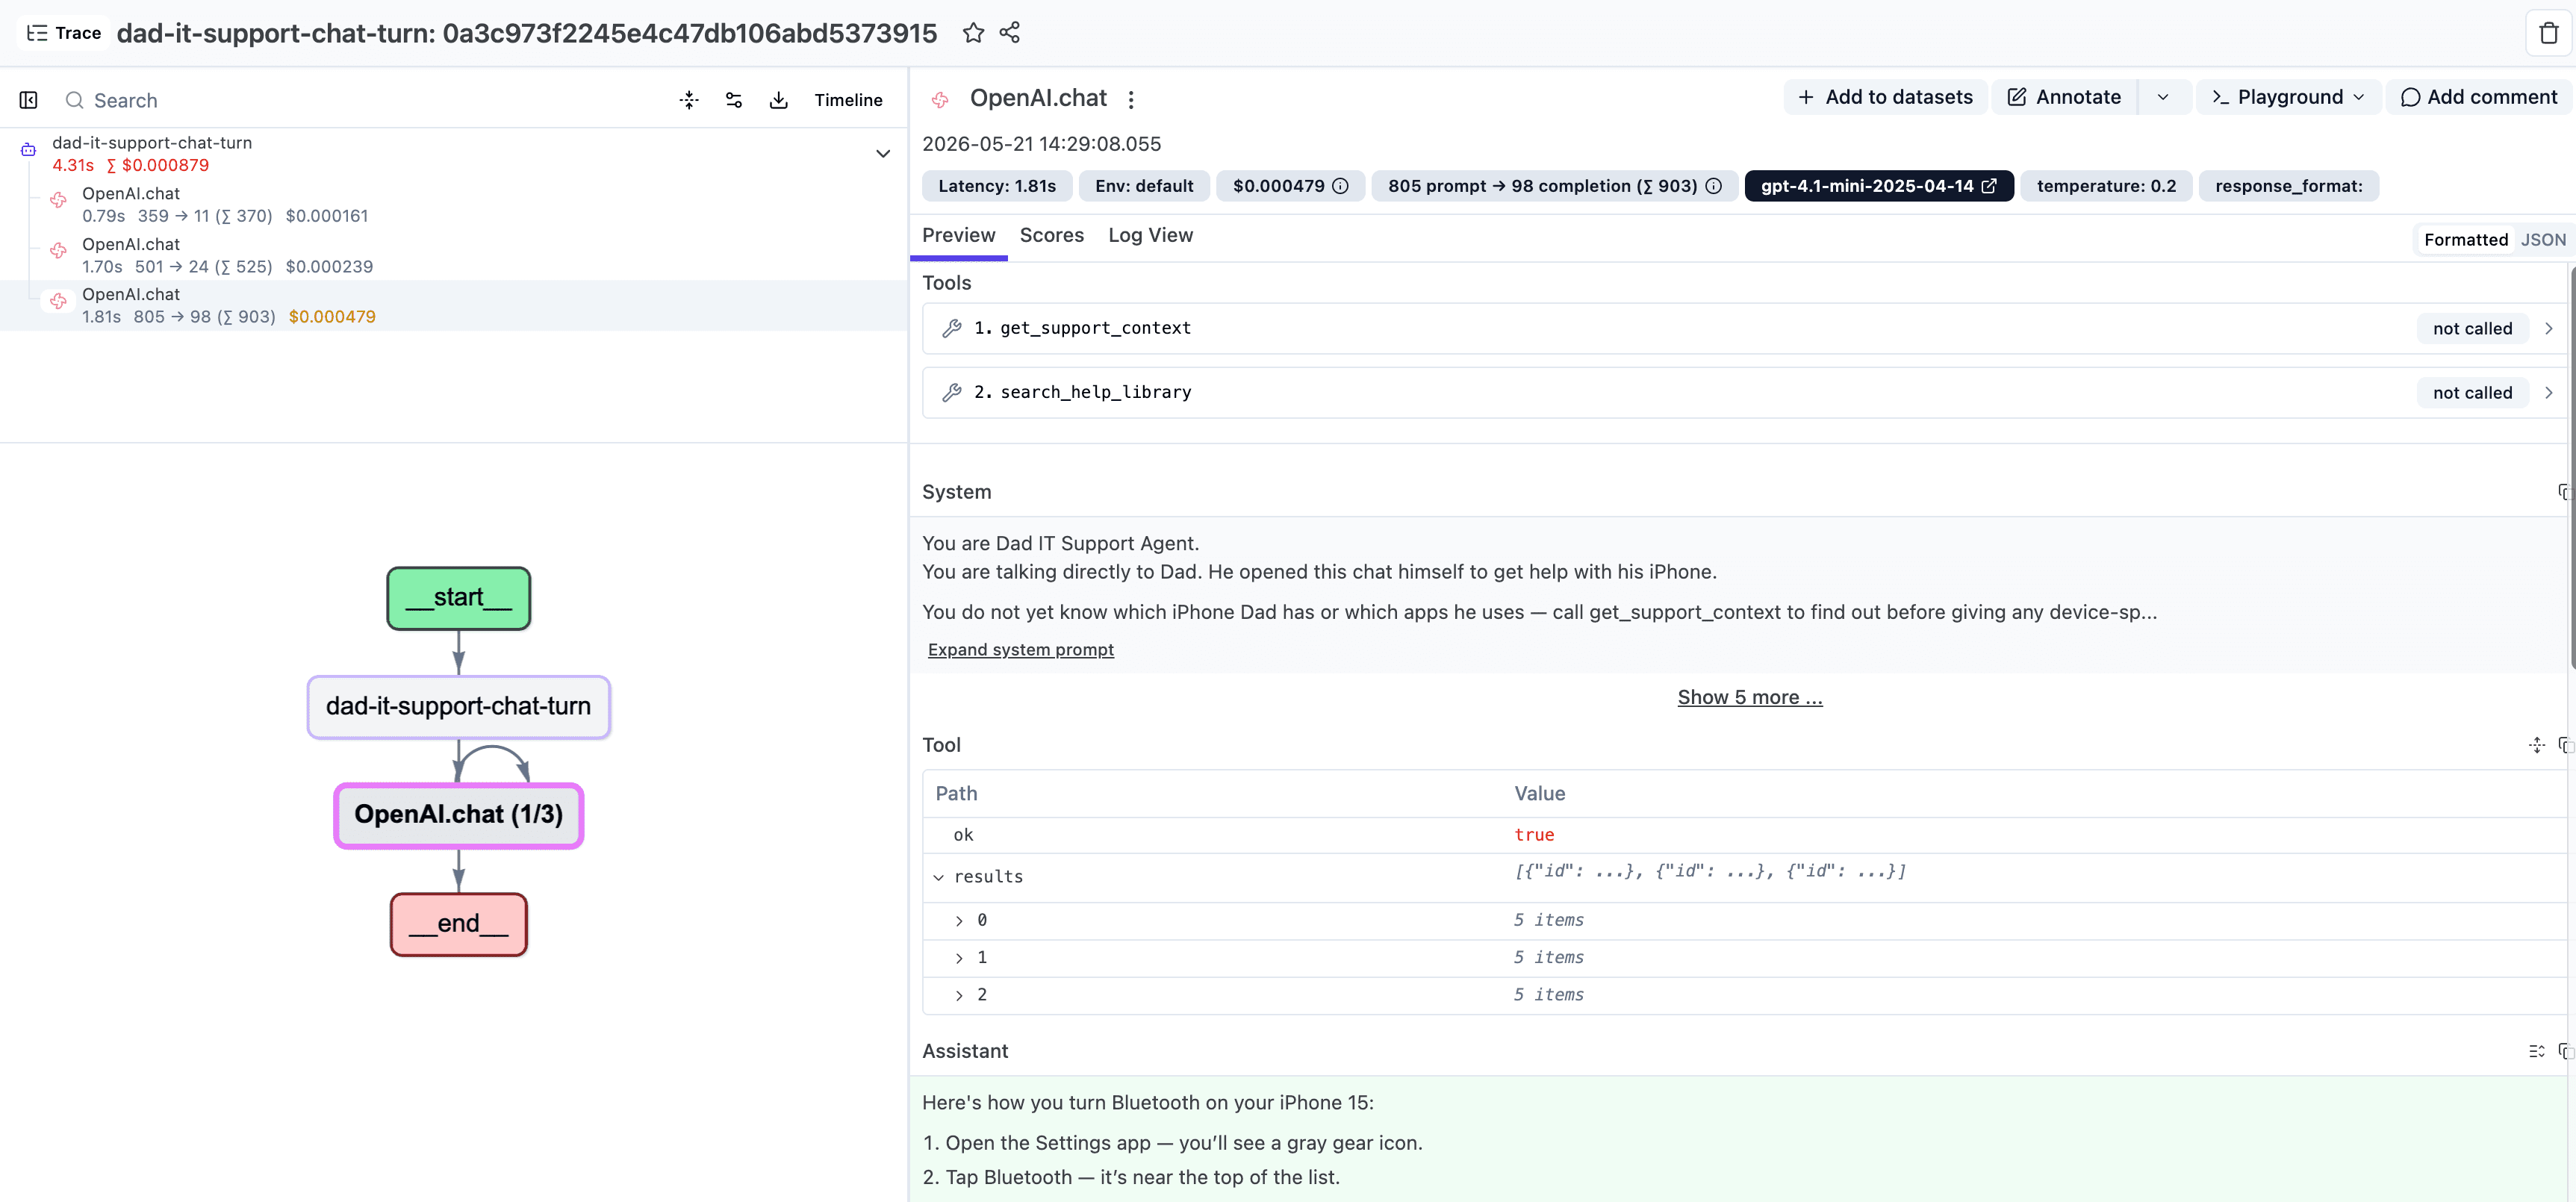
步骤 3 — 记录工具调用
OpenAI 生成已经在其 tool_calls 输出中提及了工具调用,但我们没有实际工具执行的观测 — 无法看到什么输入进去,什么出来。同样的 observe(...) 模式可以应用于每个工具。
src/server/tools.ts
添加导入和两个观测的帮助程序在 executeTool 上方,然后 用下面的版本替换现有的 executeTool,使 switch 调用包装的帮助程序而不是内联做工作。TOOL_DEFINITIONS 保持不变。
import { observe } from "@langfuse/tracing";

const getSupportContextTool = observe(
  async () => {
    const context = getSupportContext();

    return {
      ok: true,
      context: {
        id: context.id,
        label: context.label,
        devices: context.devices,
        deviceSummary: context.deviceSummary,
        responseStyle: context.responseStyle,
        scopeHighlights: context.scopeHighlights,
        notableApps: context.notableApps
      }
    };
  },
  { name: "get_support_context", asType: "tool" }
);

const searchHelpLibraryTool = observe(
  async (input: { question: string }) => {
    const guides = searchGuides(input.question);

    return {
      ok: true,
      results: guides.map((guide) => ({
        id: guide.id,
        title: guide.title,
        summary: guide.summary,
        steps: guide.steps,
        caution: guide.caution ?? null
      }))
    };
  },
  { name: "search_help_library", asType: "tool" }
);

export async function executeTool(name: string, input: Record<string, unknown>): Promise<ToolResult> {
  switch (name) {
    case "get_support_context":
      return getSupportContextTool();

    case "search_help_library":
      return searchHelpLibraryTool({ question: String(input.question ?? "") });

    default:
      return { ok: false, error: `Unsupported tool: ${name}` };
  }
}
如果 npm run dev 以 Multiple exports with the same name "executeTool" 停止,原始 executeTool 仍然在文件更下方。删除它,仅保留上面的版本。
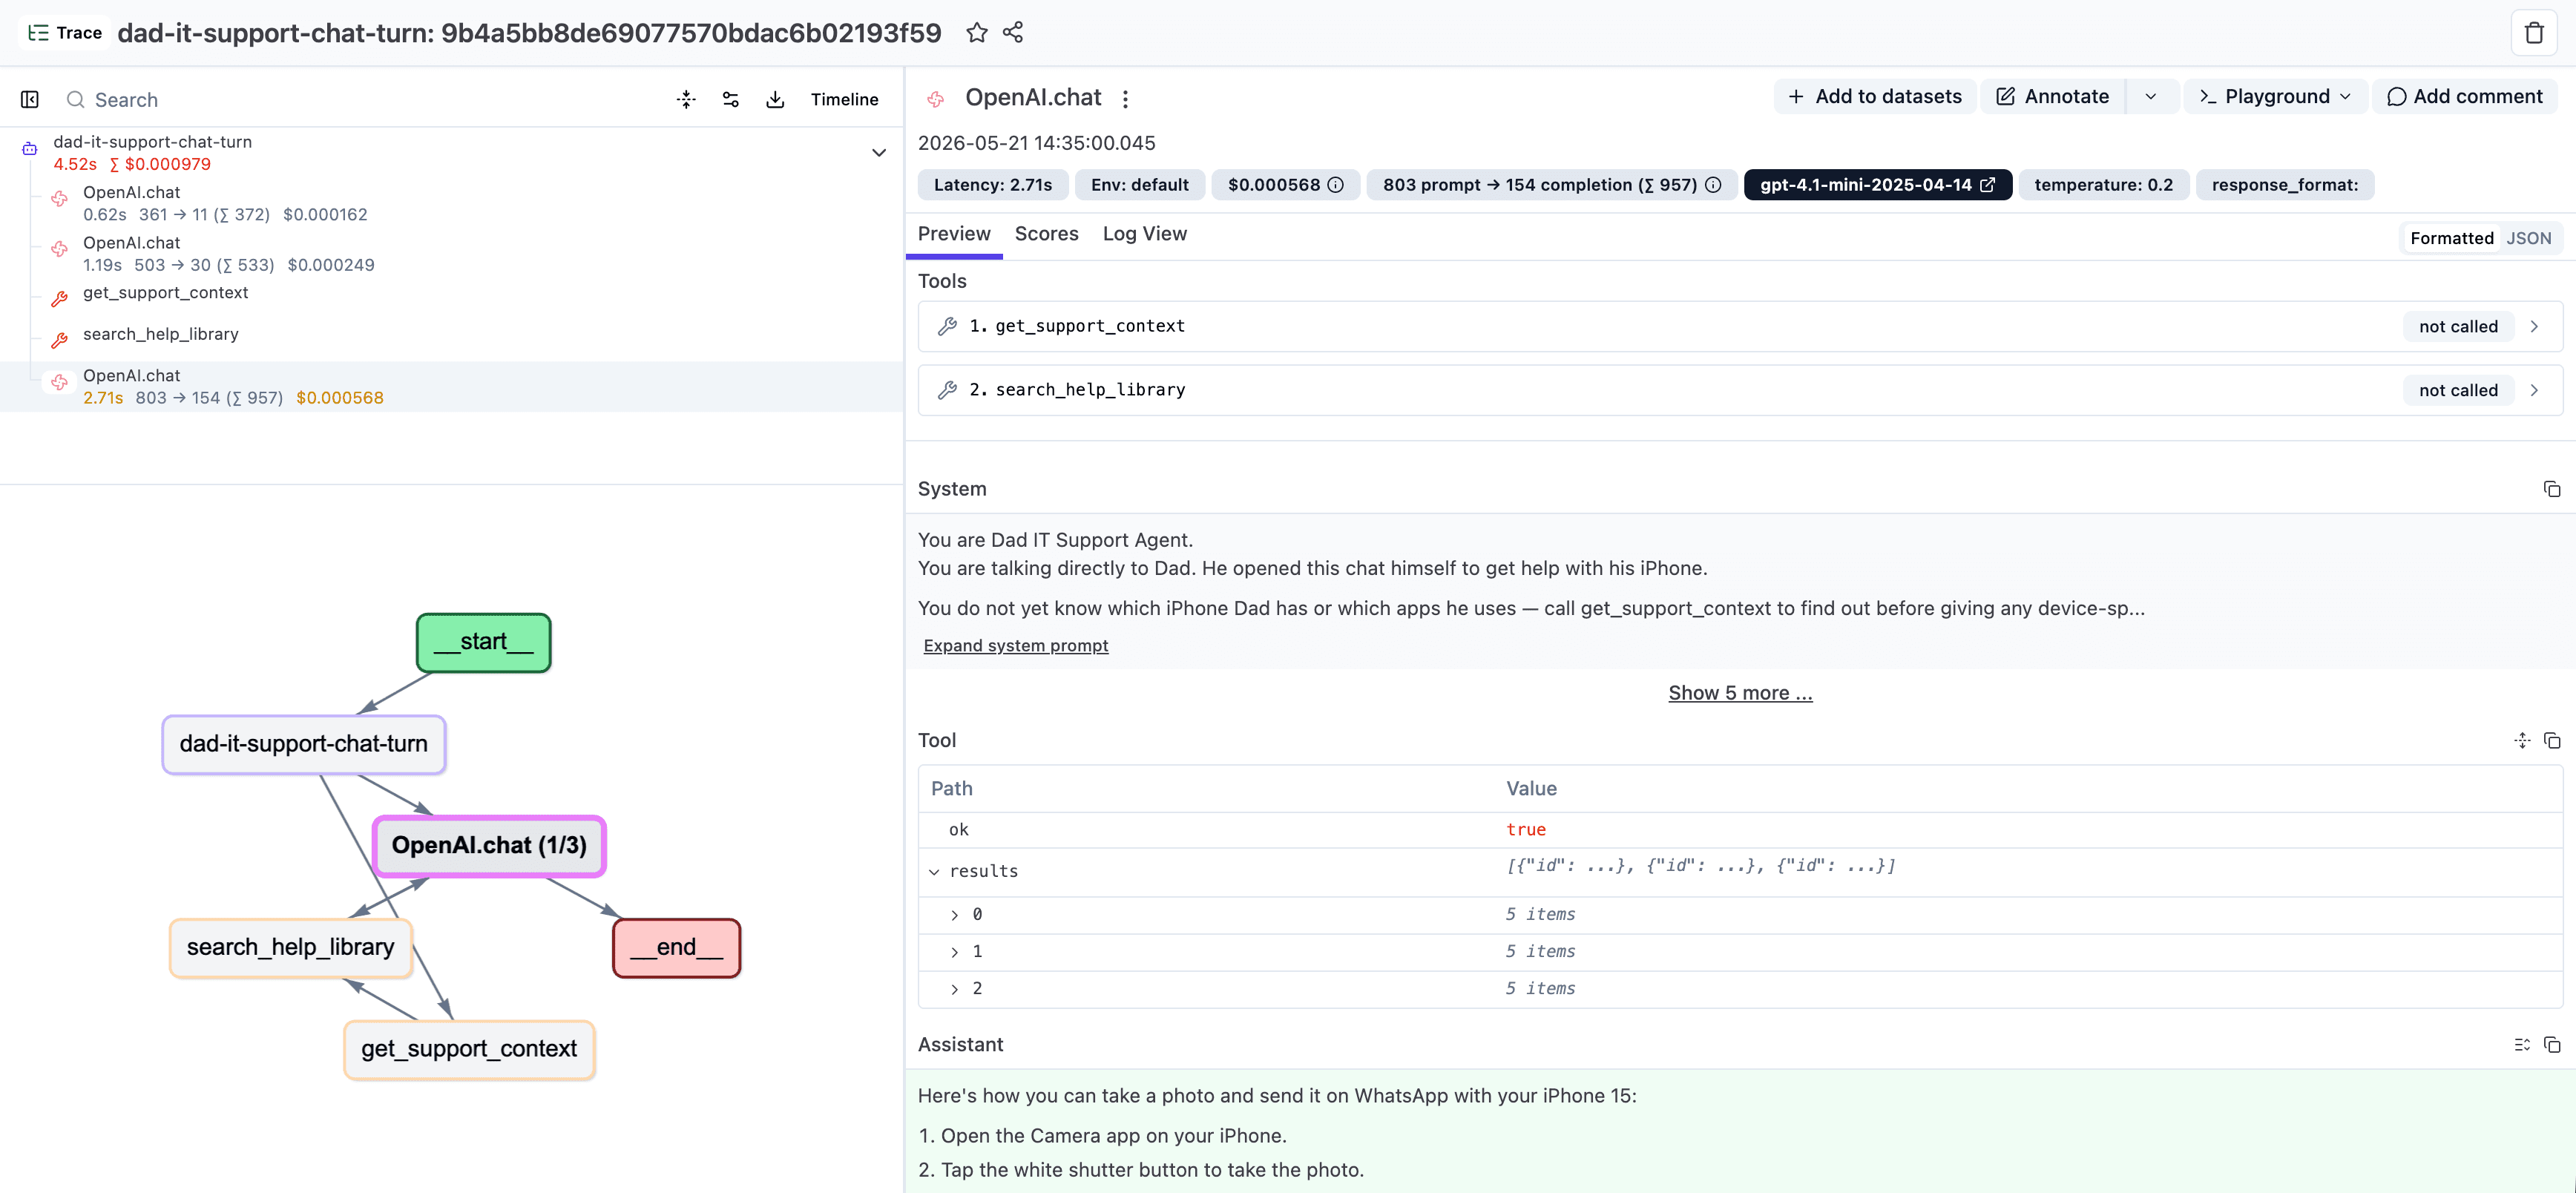
如何验证你已完成
- 单个用户转折在 Langfuse 中创建一个跟踪。
- 根观测:
dad-it-support-chat-turn(类型agent)。 - 来自
observeOpenAI(...)的子生成,包含提示词、响应、令牌、延迟。 - 子工具观测:
get_support_context、search_help_library。 - 根输入是聊天请求;根输出是聊天响应。
总结
相同的模式,不同的观测类型,相同的概念:observe(fn, { asType }) 包装一个函数并发出一个 span,带有你给它的名称和类型。observeOpenAI(client) 是该包装针对 OpenAI SDK 的专用版本。
根据 Langfuse 最佳实践添加丰富跟踪的更直接方式是 Langfuse 技能(/langfuse)。它将推荐的模式应用到你的代码库,无需你手工滚动每个包装。本演练的存在是为了让你理解技能在幕后做什么。
observeOpenAI 本身包装官方 OpenAI SDK — 在幕后它与 Langfuse OpenAI JS 自动检测 相同。如果你使用不同的 SDK(Anthropic、Vercel AI SDK、你自己的 HTTP 客户端),Langfuse 集成目录 具有等效的包装或自动检测指南。
附录/奖励部分 — 用户和会话 ID
上面的演练让你得到了干净的 parent → generation → tool 形状的跟踪。接下来大多数团队想要的是 按用户和会话切片跟踪 — 这样你可以提取"这个用户与代理进行的每一次转折"或"昨天早上的完整多转折会话"。 为了简单起见,我们在实时跟踪演练中跳过这一步,但跟踪后的检查点包括它,以便后续章节可以使用会话/用户视图而无需另一个代码步骤。参见 Langfuse 文档中关于 Sessions 和 Users 的信息。
简而言之:
import { propagateAttributes } from "@langfuse/tracing";

return propagateAttributes(
  {
    userId: request.userId ?? `workshop-${context.id}`,
    sessionId: request.sessionId,
    tags: ["langfuse-workshop", "dad-it-support"]
  },
  async () => {
    // ...the same tool-calling loop...
  }
);
propagateAttributes(...) 块内的任何东西 — 包括 observeOpenAI 发出的所有子 span — 自动获得 userId、sessionId 和标签附加。Langfuse Users 视图、Sessions 视图和标签过滤器在属性存在的时刻就亮起来了。
最终状态
这个完成的跟踪应用是 03-prompt-management 和 04-monitoring 的起点。