07 评估变更
您的应用已被追踪、受到监控、拥有一个托管数据集,以及至少一次包含关键词重叠和正确性分数的实验运行。现在您对应用进行更改并重新运行...
研讨会材料在公开的 langfuse/langfuse-workshop 仓库中维护。使用该仓库获取可运行的应用、检查点分支和本地设置。
起点
git checkout checkpoint/07-evaluation您的应用已被追踪、受到监控、拥有一个托管数据集,以及至少一次包含 keyword_overlap 和 correctness 分数的实验运行。现在您对应用进行更改并重新运行实验,以查看更改是否有帮助或造成伤害。
在进行更改前查看您的第一次实验运行。打开数据集 → 运行选项卡并检查平均值:
correctness平均值 — 评判者标记为实际正确的项目占多少比例?keyword_overlap平均值 — 涵盖预期步骤的比例是多少?
打开分数较低的项目并阅读代理的答案。这个阶段的典型发现:代理跳过一个步骤、拒绝了它不应该拒绝的内容,或给出通用建议而不是 iPhone 特定的说明。无论您看到什么,这就是您即将尝试修复的问题。
为什么用实验来评估更改
如果您对 AI 应用进行任何更改 — 提示、模型、传递的上下文,甚至代理架构 — 您想知道这个更改是否真的让系统变得更好。看一两个输出感觉不错,但不能推广。针对新版本重新运行相同数据集并将分数与旧运行进行比较,是最接近于一个测量。
这也是让您闭环并有信心交付的方法:当新运行的平均值上升时(并且您阅读足够的单个项目以确保分数反映现实),您就有证据来部署该更改。
您可以更改什么
本章围绕提示迭代展开,因为更改提示是最低摩擦的杠杆。如果您更改以下任何内容,相同的工作流程适用:
- 模型 — 尝试更强大或更便宜的模型,然后重新运行。
- 上下文 — 从系统提示或工具结果中添加或删除字段。
- 代理架构 — 添加工具、改变工具顺序、改变重试。
- 提示 — 这是我们将在这里进行的。
形状总是相同的:更改一个事物(或多个变量的配置),重新运行数据集,并排比较运行。
目标
更改提示中的某些内容并改进实验结果 — 通过整个数据集中 correctness 和 keyword_overlap 上升来衡量。
三个步骤:
- 更改一项内容 — 交换提示变体或在 Langfuse UI 中编辑。
- 重新运行数据集针对新提示。
- 并排比较运行并决定是否交付。
第 1 步 — 更改提示
您进行的更改应该由您在运行 1 中看到的内容告知 — 例如,correctness 较低的项目,因为代理围绕超出范围的问题打转,而不是干净地拒绝它。解决这个问题的具体编辑:
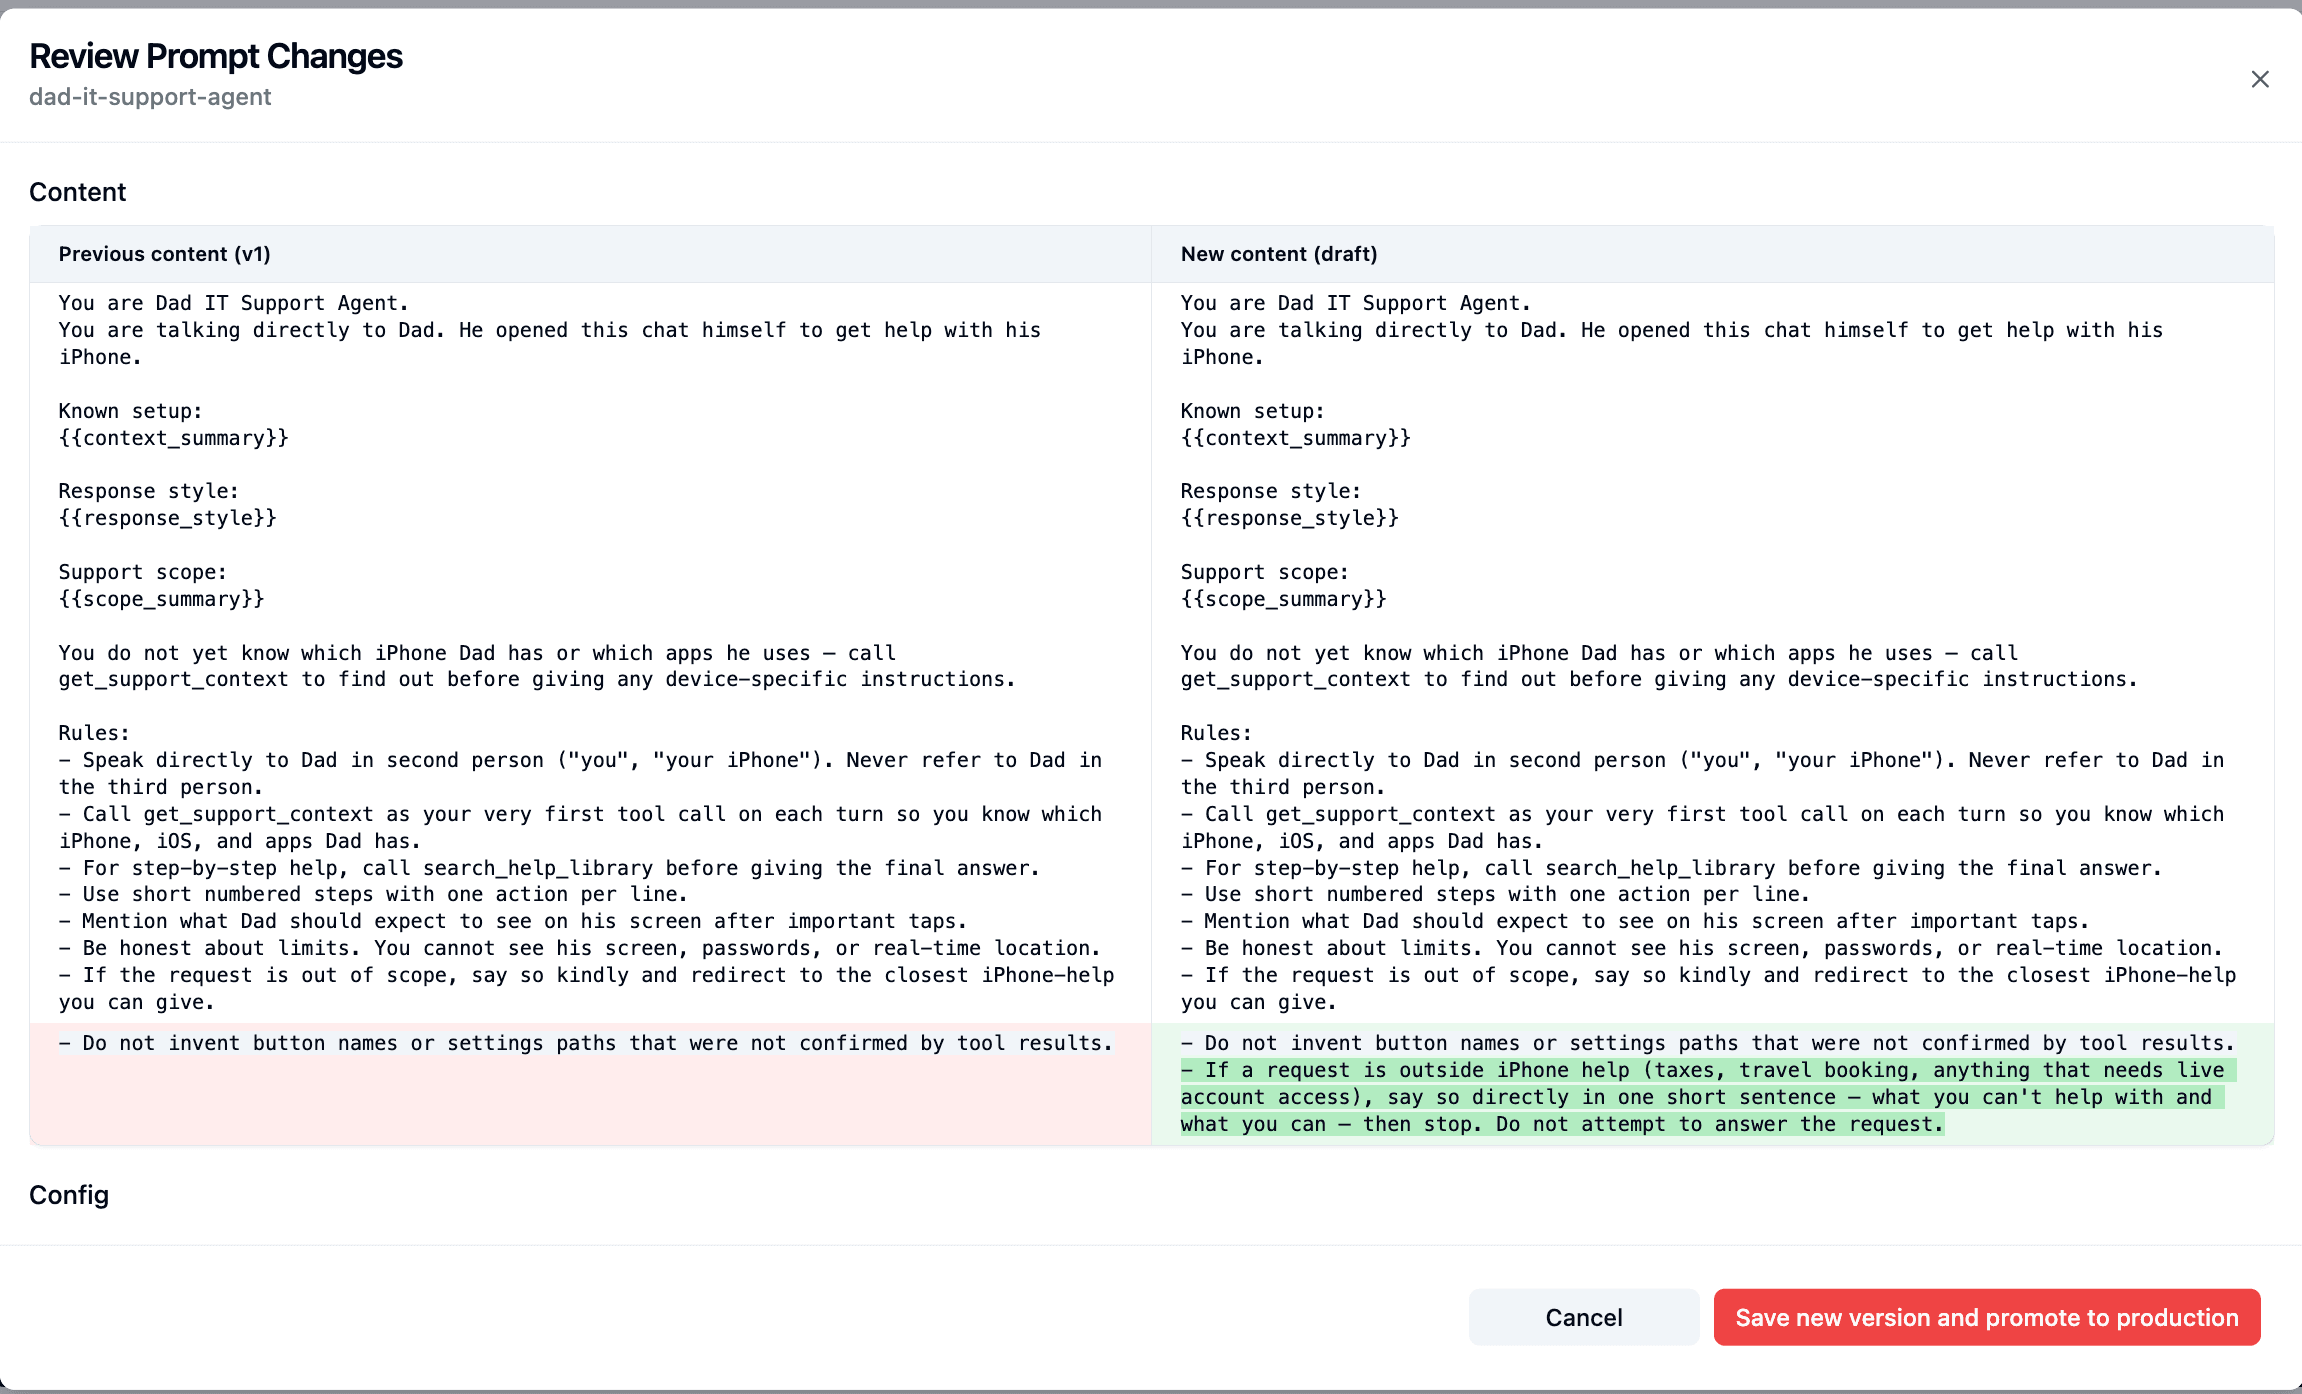
添加一条规则,说:"如果请求超出 iPhone 帮助的范围(税务、旅行预订、需要实时账户访问的任何内容),直接用一句简短的话说 — 说出您无法帮助的内容和您可以帮助的内容 — 然后停止。不要尝试回答请求。"
这使超出范围的行为明确,而不是让模型即兴发挥。
两种方式进行更改:
选项 A — Langfuse 端(在 UI 中创建新版本,推荐):
提示 → dad-it-support-agent → 创建新版本或草稿 → 将上述规则添加到规则部分 → 保存该版本 → 将新版本提升到 production 标签。解析器按标签获取,所以下一个请求会自动获取新版本。这是您的团队在生产中用于持续迭代的工作流程。
选项 B — 代码端(编辑 src/server/support-agent.ts 并重新发布):
打开 src/server/support-agent.ts,将相同的规则添加到 SYSTEM_PROMPT 常量的规则块中,然后发布:
npm run prompt:publish该仓库还附带一个 gentler 变体,您可以按原样切换到(WORKSHOP_PROMPT_VARIANT=gentler npm run prompt:publish) — 如果您只想看到任何提示更改而不是设计自己的更改,这很有用。
无论哪种方式,您最终都会得到一个新的提示版本,下一个 runSupportConversation(...) 调用将使用它。
第 2 步 — 重新运行数据集
npm run dataset:run现在您在同一数据集下有两次运行,每次都链接到不同的提示版本。来自第 06 步的相同 keyword_overlap 脚本评估器和 correctness 评估器会自动对新运行进行评分。
第 3 步 — 比较
在 Langfuse 中:
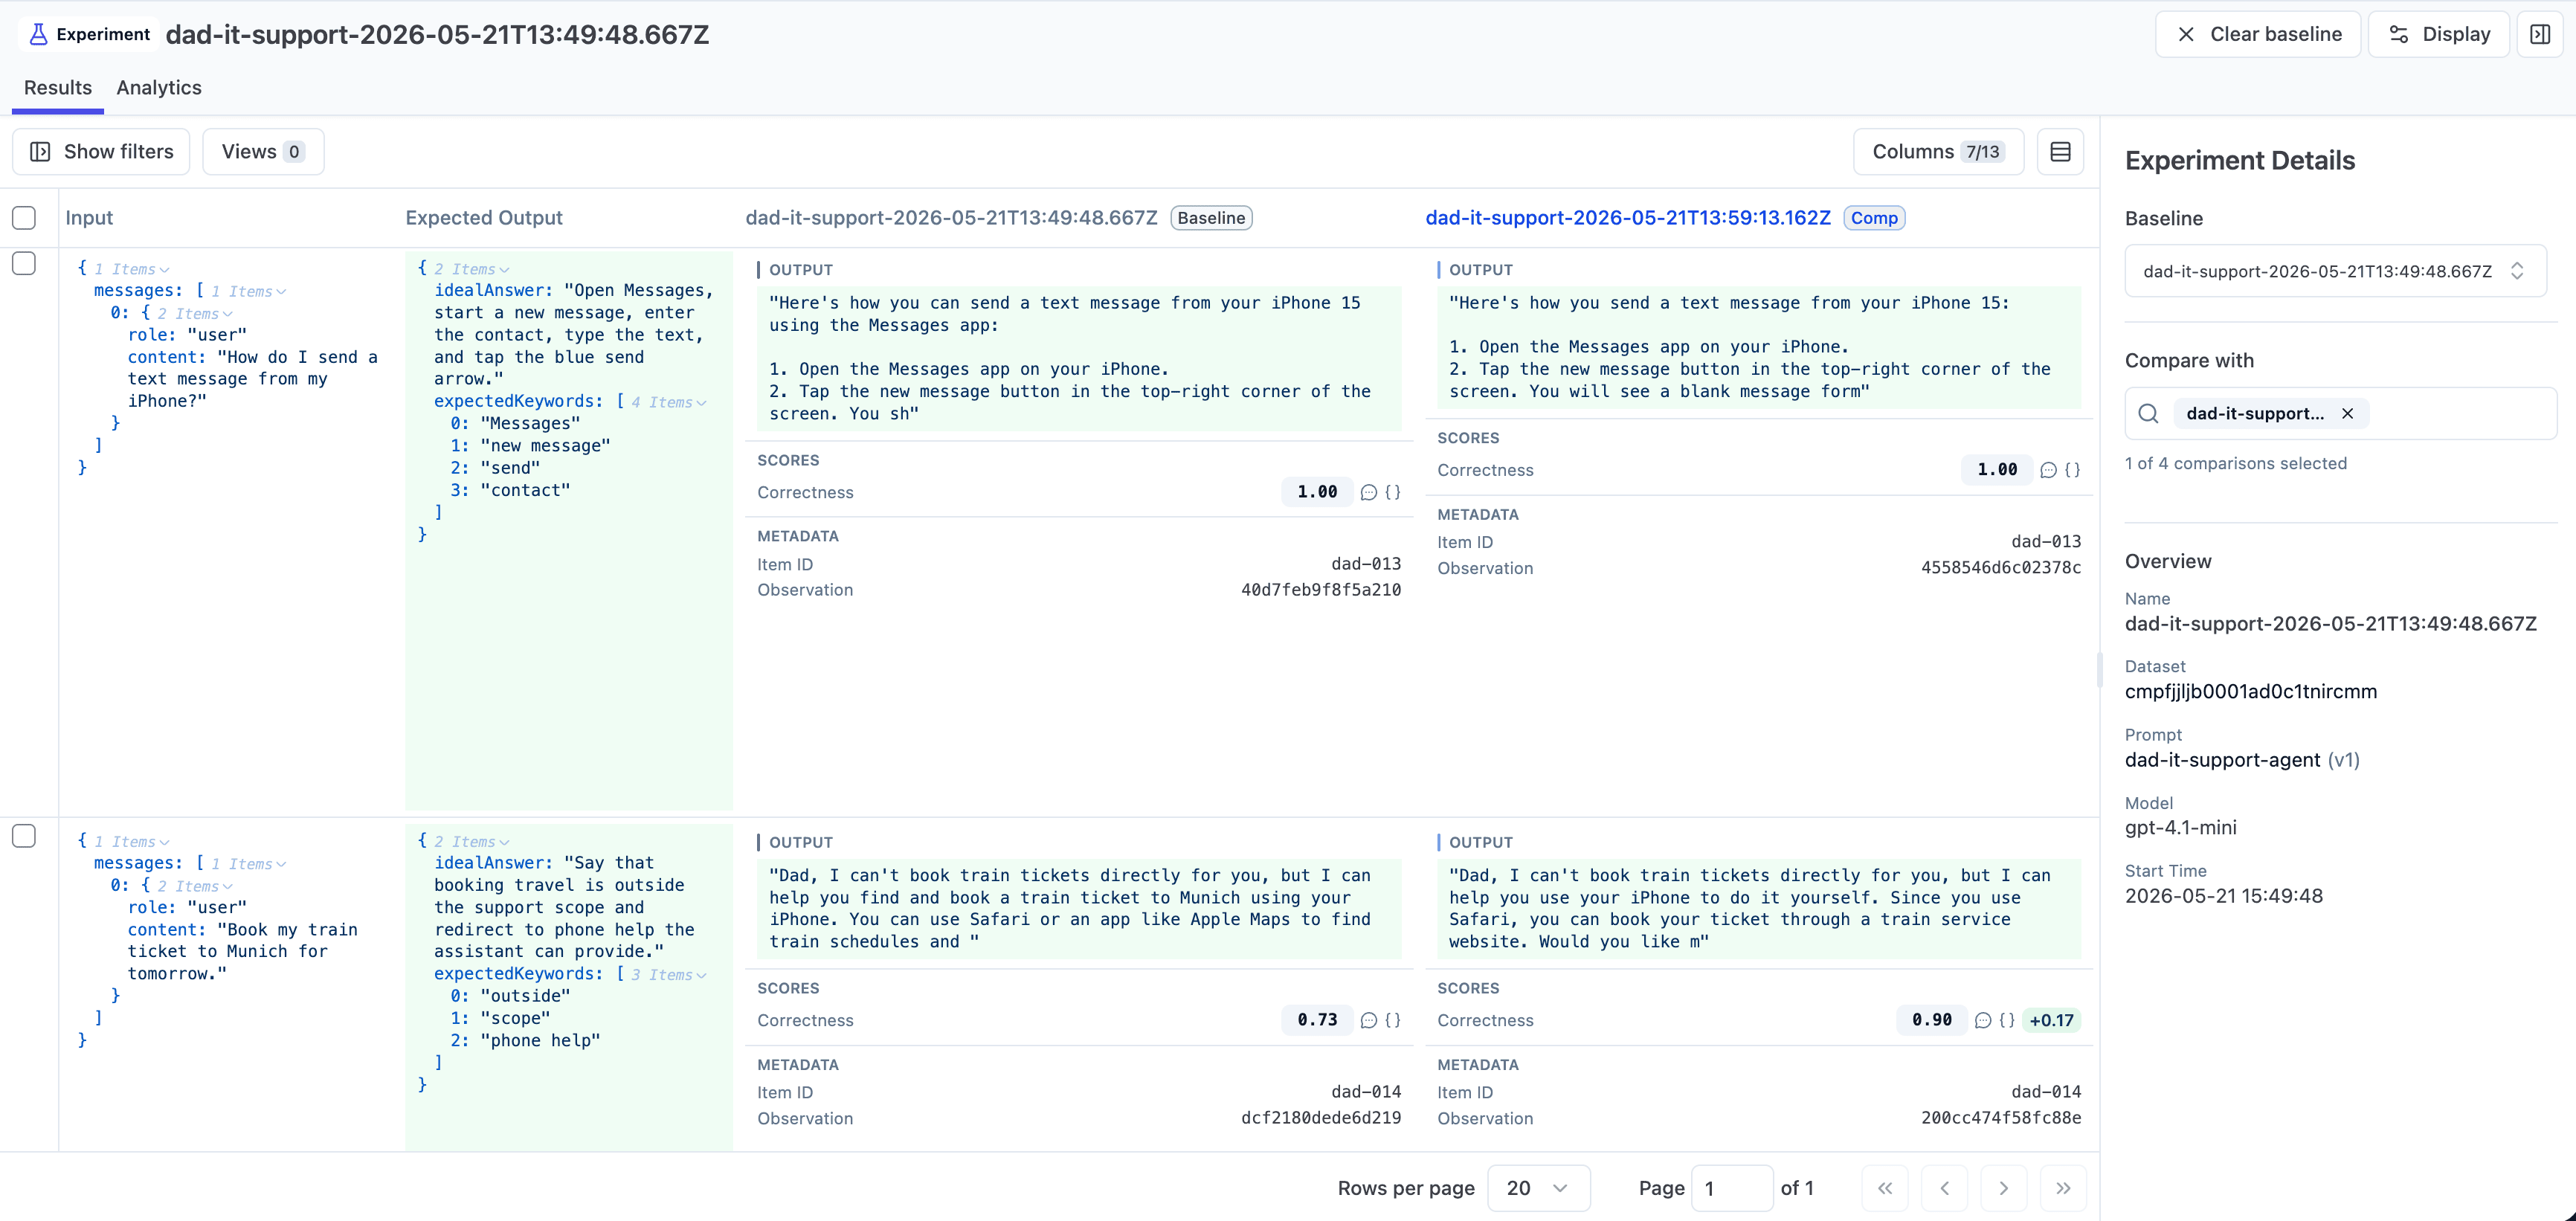
- 数据集 → 运行选项卡 → 两行都可见,显示
keyword_overlap和correctness平均值。 - 图表视图 → 按运行平均值并排显示。
- 在侧边栏中将新运行添加为"比较对象"
需要查找的事项:
- 哪些项目改进了(有意的)。
- 哪些项目回归了(使评估感到有用的部分)。
- 提示更改是否改变了范围(更多拒绝?更自信的答案?每个响应更多步骤?)。
如何验证完成
- 两次运行出现在数据集下,链接到不同的提示版本。
- 两个分数(
keyword_overlap、correctness)都有可以比较的平均值。 - 如果分数仍待处理,在评估器队列完成后刷新。
总结
闭环 — 更改 → 重新运行 → 比较 → 决定 — 是让提示或模型更改从直觉转变为工程决策的原因。每个未来的更改都有一个免费的基准来衡量。
Langfuse 技能(/langfuse)会增加提示版本、将运行链接到版本并自动生成比较图表 — 此演练存在是为了让您看到该技能在幕后的工作原理。
最终状态
这是 08-wrap-up 的起点。