01 Pilih model dasar
Arena — jalankan grid model × prompt sebagai Langfuse experiments dan tetapkan pemenang berdasarkan cost per correct answer.
Titik awal
Modul 00 selesai: .env sudah di-source, database arena ter-seed, Langfuse terhubung, dan
dashboard lokal bisa dibuka di http://localhost:5174 dengan tab Leaderboard yang kosong.
Mengapa ini keputusan fundamental
Ini keputusan yang menjadi pusat seluruh workshop. Sebelum kamu merilis agent yang serius, kamu harus menjawab satu pertanyaan fundamental: model mana yang menenagainya? Kemampuan dan harga antar model sangat berbeda, dan pilihan terbaik bergantung pada tugas spesifikmu — bukan pada leaderboard publik yang dijalankan orang lain pada beban kerja berbeda. Menebak itu mahal di kedua arah: membayar terlalu mahal untuk model frontier yang tidak kamu butuhkan, atau merilis model murah yang diam-diam salah menjawab pertanyaan nyatamu.
Jadi ketimbang menebak, kamu menjalankan sebuah kontes: Arena. Satu grid model dan strategi prompt menjawab pertanyaan golden yang sama, Langfuse menilai setiap jawaban sebagai sebuah experiment, dan metrik yang menetapkan pemenang bukan akurasi mentah melainkan cost per correct answer — kualitas per dolar untuk use case kamu. Konkretnya, modul ini menjawab, dengan bukti: di antara grid model dan strategi prompt, konfigurasi mana yang menghasilkan jawaban benar terbanyak per dolar? "Benar" berarti execution accuracy — SQL yang dihasilkan mengembalikan result set yang sama dengan golden SQL, bukan SQL yang sekadar tampak masuk akal. Penilaian terjadi di dalam Langfuse, bukan di dalam harness — Langfuse yang menampung evaluator dan menyimpan setiap Experiment Item, score, dan trace. Leaderboard lokal membaca catatan itu lewat Langfuse Public API. Semua hal setelah modul ini (ukur, tingkatkan, rilis) mengasumsikan kamu membuat pilihan ini berdasarkan bukti.
Konsep — di balik layar
Model data Langfuse untuk evaluasi ini. Korpus sumber repo berisi 20 pertanyaan YAML.
q019 dan q020 adalah holdout untuk prompt few-shot, sehingga pada project bersih Dataset
(arena-golden) yang di-seed berisi 18 pertanyaan experiment, masing-masing dengan result
set yang diharapkan. Setiap konfigurasi model × prompt
yang kamu jalankan adalah satu Experiment — sebuah Dataset Run Langfuse — terhadap dataset
18 item yang sama itu, jadi setiap config dinilai pada pertanyaan yang persis sama. Definisi
evaluator yang kamu siapkan di Langkah 1 adalah correctness dan llm_judge; score
Experiment yang dihasilkannya adalah correctness dan agent-arena-llm-judge.
Satu dataset, banyak experiment, satu score per item per experiment
— itulah yang membuat Leaderboard bisa membandingkan config secara apple-to-apple.
Setiap config model × prompt berjalan sebagai satu Experiment (Dataset Run) terhadap dataset arena-golden, dan setiap experiment melekatkan dua score ke setiap dataset item: correctness (0/1) dan agent-arena-llm-judge (0..1).
Strategi prompt juga peserta kontes. Grid-nya bukan cuma model — tetapi
model × prompt, karena cara kamu bertanya sama pentingnya dengan siapa yang kamu tanya. Dari
config.yaml dan agents/prompts.py:
| Prompt | Apa yang dilakukannya | Kenapa itu bisa membantu NL→SQL |
|---|---|---|
P1_zeroshot | Hanya skema + pertanyaan, kembalikan satu blok SQL berfence. Baseline-nya. | Paling murah per panggilan; mengukur apa yang bisa dilakukan model tanpa bantuan. |
P2_fewshot | P1 ditambah 2 contoh NL→SQL yang sudah dikerjakan (disisihkan dari test set). | Menunjukkan ke model bentuk jawaban "bagus" yang diharapkan sebelum ia menulis satu. |
P3_dialect | P1 ditambah cheat-sheet dialek ClickHouse (fungsi tanggal, uniqExact, argMax, INTERVAL, tanpa ILIKE, …). | Memperbaiki mode kegagalan paling umum: SQL yang lancar tetapi bukan SQL ClickHouse yang valid. |
Rosternya: proprietary vs open-weight. Keenam peserta terbagi rata pada sumbu kedua yang sama pentingnya dengan nama model — apakah bobotnya tertutup (API vendor yang hanya bisa kamu panggil) atau terbuka (model yang bisa kamu self-host, fine-tune, atau simpan sepenuhnya di dalam batas datamu sendiri). Model open-weight sering jauh lebih murah per token, sementara model frontier proprietary mungkin memimpin dalam kemampuan mentah — tetapi "mungkin" itulah yang dibangun Arena ini untuk diuji pada tugas kamu, bukan diasumsikan. Menjalankan kedua sisi lewat golden dataset yang sama membuat cost-per-correct-answer memberi tahu kamu apakah kamu benar-benar perlu membayar untuk model frontier, atau apakah model open-weight yang murah sudah membawamu ke sana dengan sebagian kecil dari harganya. Roster di bawah ini sengaja dibuat murah: NL→SQL adalah tugas yang cukup sederhana sehingga peserta termahal di sini pun adalah model kelas menengah, bukan frontier.
| Model | Vendor | Open / Proprietary | Fallback ilustratif ($/1M in · out) |
|---|---|---|---|
claude-sonnet-5 | Anthropic | Proprietary | $2.00 · $10.00 |
gpt-5.6-luna | OpenAI | Proprietary | $0.50 · $3.00 |
gemini-flash-lite | Proprietary | $0.30 · $2.50 | |
deepseek-v4-flash | DeepSeek | Open-weight | $0.14 · $0.28 |
qwen3.7-flash | Qwen | Open-weight | $0.03 · $0.13 |
glm-4.7-flash | Z.ai | Open-weight | $0.06 · $0.40 |
Kenapa cost-per-correct, dan kenapa execution accuracy. "Benar" ditentukan oleh execution accuracy: apakah menjalankan SQL yang dihasilkan memberi result set yang sama dengan golden SQL? Itu sinyal yang jujur — ia tidak peduli apakah SQL-nya berbeda byte-per-byte dari golden query, hanya apakah ia menjawab pertanyaan dengan benar. Metrik peringkat utamanya kemudian adalah
cost_per_correct_answer = total cost of the run ($) / number of correct answersyang memberi nilai lebih pada model yang hampir sama akurat tetapi jauh lebih murah dibanding model frontier yang sedikit lebih baik tetapi jauh lebih mahal — metrik yang benar-benar akan dioptimalkan tim yang sadar biaya.
Tujuan
Leaderboard yang terisi, memeringkat setidaknya beberapa konfigurasi model × prompt berdasarkan
cost-per-correct-answer, dengan setiap peringkat didukung trace Langfuse yang bisa kamu
telusuri, dan satu pemenang yang ditetapkan: satu config_id.
Langkah 1 — Siapkan evaluator Langfuse (sekali saja)
Lakukan ini sekali, mengikuti eval/langfuse_evaluators/README.md di repo. Pertama seed
arena-golden dan konfigurasikan judge berbasis OpenRouter lewat API:
python -m scripts.provision_langfuse_evaluatorsLalu konfigurasikan code evaluator deterministik di UI Langfuse:
- Code evaluator
correctness— Evaluators → Set up Evaluator → Code → tempeleval/langfuse_evaluators/correctness_evaluator.py→ Target: Experiments → filter dataset =arena-golden. Evaluator ini membandingkan result set agent (dari trace) dengan golden result set (expected_outputmilik dataset item) dan menghasilkan scorecorrectnessexecution-accuracy (0/1) plus sebuah kategorioutcome. Ia tidak melakukan egress jaringan — SQL-nya sudah dijalankan di dalam agent; evaluator hanya membandingkan result set. - Fallback manual untuk definisi evaluator
llm_judge— Evaluators → Set up Evaluator → LLM-as-a-judge → Custom → pakai prompt system/eval dan pemetaan variabel darieval/langfuse_evaluators/llm_judge_prompt.md→ Target: Experiments, datasetarena-golden→ hasilkan score numerikagent-arena-llm-judge. Nama definisi evaluator dan score yang dihasilkan memang berbeda. Sinyal sekunder ini menilai kualitas SQL di atas score correctness yang utama — kamu akan mengandalkannya di Modul 02.
Helper-nya adalah jalur yang direkomendasikan; langkah judge manual hanyalah fallback.
Code evaluator correctness yang deterministik tetap merupakan langkah UI sekali jalan.
Langkah 2 — Jalankan kontesnya
source .env && python -m eval.harness --run-id demoApa yang seharusnya kamu lihat. Harness pertama-tama mencetak satu baris ringkasan
(run_id=demo configs=6x3 ...), lalu satu baris per pertanyaan saat berjalan, misalnya:
claude-sonnet-5__P1_zeroshot q001 pending 812ms $0.00021Setiap baris mulai dengan pending — SQL-nya sudah dijalankan dan result set-nya tercatat di trace,
tetapi evaluator Langfuse belum menilainya. Setelah semua config selesai
berjalan, harness beralih ke menunggu: grading via Langfuse evaluators — waiting on N traces..., mencetak hitung-mundur saat score correctness/agent-arena-llm-judge masuk, dan
berakhir dengan Langfuse scored all N traces; leaderboard ready. Peralihan pending →
scored itu adalah harness yang menyerahkan penilaian ke Langfuse; hasil dan verdict
tetap bersama di sana sebagai sumber kebenaran leaderboard.
Ini menjalankan grid model × prompt penuh (setiap model di config.yaml terhadap setiap
strategi prompt, P1_zeroshot sampai P3_dialect) sebagai Dataset Runs
(Experiments) Langfuse terhadap dataset arena-golden. Harness menunggu
score correctness dan agent-arena-llm-judge yang eksak tersedia pada setiap item. Cost OpenRouter yang persis dan
latensi end-to-end tersimpan pada Experiment Item yang sama.
Satu config berformat <model>__<prompt>, misalnya claude-sonnet-5__P1_zeroshot. Nama-nama
yang tersedia diambil langsung dari config.yaml:
- Model: keenam peserta di tabel roster di atas — tiga proprietary
(
claude-sonnet-5,gpt-5.6-luna,gemini-flash-lite) dan tiga open-weight (deepseek-v4-flash,qwen3.7-flash,glm-4.7-flash) - Prompt:
P1_zeroshot,P2_fewshot,P3_dialect
Flag yang berguna:
--models qwen3.7-flash,gpt-5.6-luna/--prompts P1_zeroshot,P3_dialect— batasi grid-nya ke subset CSV ketimbang menjalankan semuanya.--run-id <name>— beri tag pada run supaya mudah ditemukan di Leaderboard dan di tampilan Experiments Langfuse.
SDK bisa memproses dataset item secara terbalik atau bersamaan; pakai ID pertanyaan
di setiap baris ketimbang mengharapkan urutan output q001, q002, ... Grid penuh 18 config
biasanya butuh 35–45 menit. Mulailah workshop dengan subset dua model, satu prompt
dan jalankan grid penuh hanya kalau jadwal dan limit provider mengizinkan.
Evaluator Langfuse itu wajib. Langfuse sekarang menjadi satu-satunya penyimpanan evaluasi, jadi
tidak ada fallback local-grade atau hasil-ClickHouse. Kalau harness timeout menunggu
score, perbaiki konfigurasi evaluator dari Langkah 1 dan pakai --run-id yang baru.
Langkah 3 — Tetapkan pemenangnya
Buka http://localhost:5174 → Leaderboard. Setiap config model × prompt
diperingkat berdasarkan cost-per-correct-answer — metrik utamanya. Sebuah chart cost × accuracy dan
peringkat "best value" berada di atas tabel.
Cost dihitung dari harga OpenRouter langsung — harness menyegarkan harga model
dari endpoint /models OpenRouter di awal setiap run, sehingga
cost-per-correct-answer mencerminkan biaya model hari ini, bukan angka usang
yang ditanam di config.yaml.
Cara membacanya. Urutannya adalah cost-per-correct-answer naik — pemenangnya adalah baris teratas, bukan baris dengan akurasi tertinggi. Perhatikan chart cost × accuracy untuk model murah yang duduk berdekatan dengan model mahal pada sumbu akurasi: selisih itu, dengan sebagian kecil biaya, adalah seluruh alasan metrik ini ada ketimbang leaderboard akurasi biasa.
Jebakan — akurasi tertinggi ≠ pemenang. Menggoda sekali untuk melirik kolom akurasi
dan menganggap skor tertinggi yang menang. Arena memeringkat berdasarkan cost-per-correct-answer, jadi
config yang sedikit kurang akurat tetapi jauh lebih murah bisa (dan sering) mengalahkan config yang lebih mahal
dan sedikit lebih akurat. Cek kolom $/correct, bukan hanya akurasi.
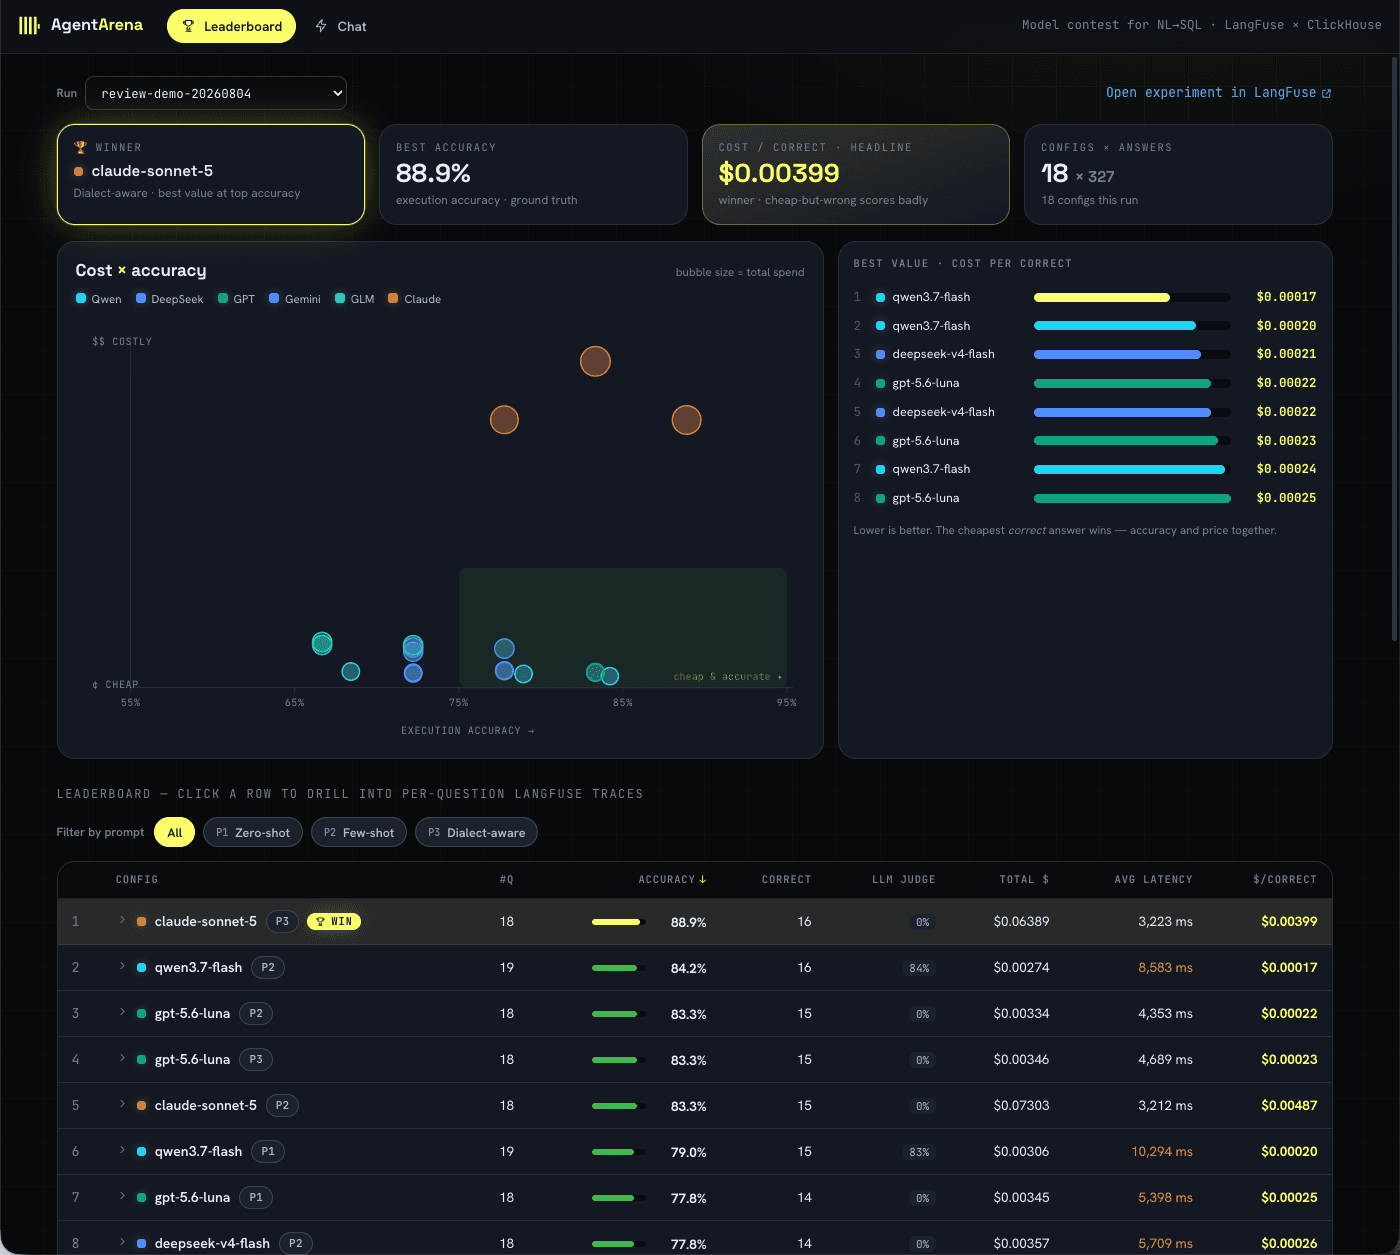
Leaderboard menempatkan kualitas dan harga berdampingan. Chart cost × accuracy memperlihatkan
trade-off-nya secara visual, sementara daftar best-value dan kolom $/correct mengungkap
konfigurasi mana yang paling efisien mengubah belanja menjadi jawaban benar.
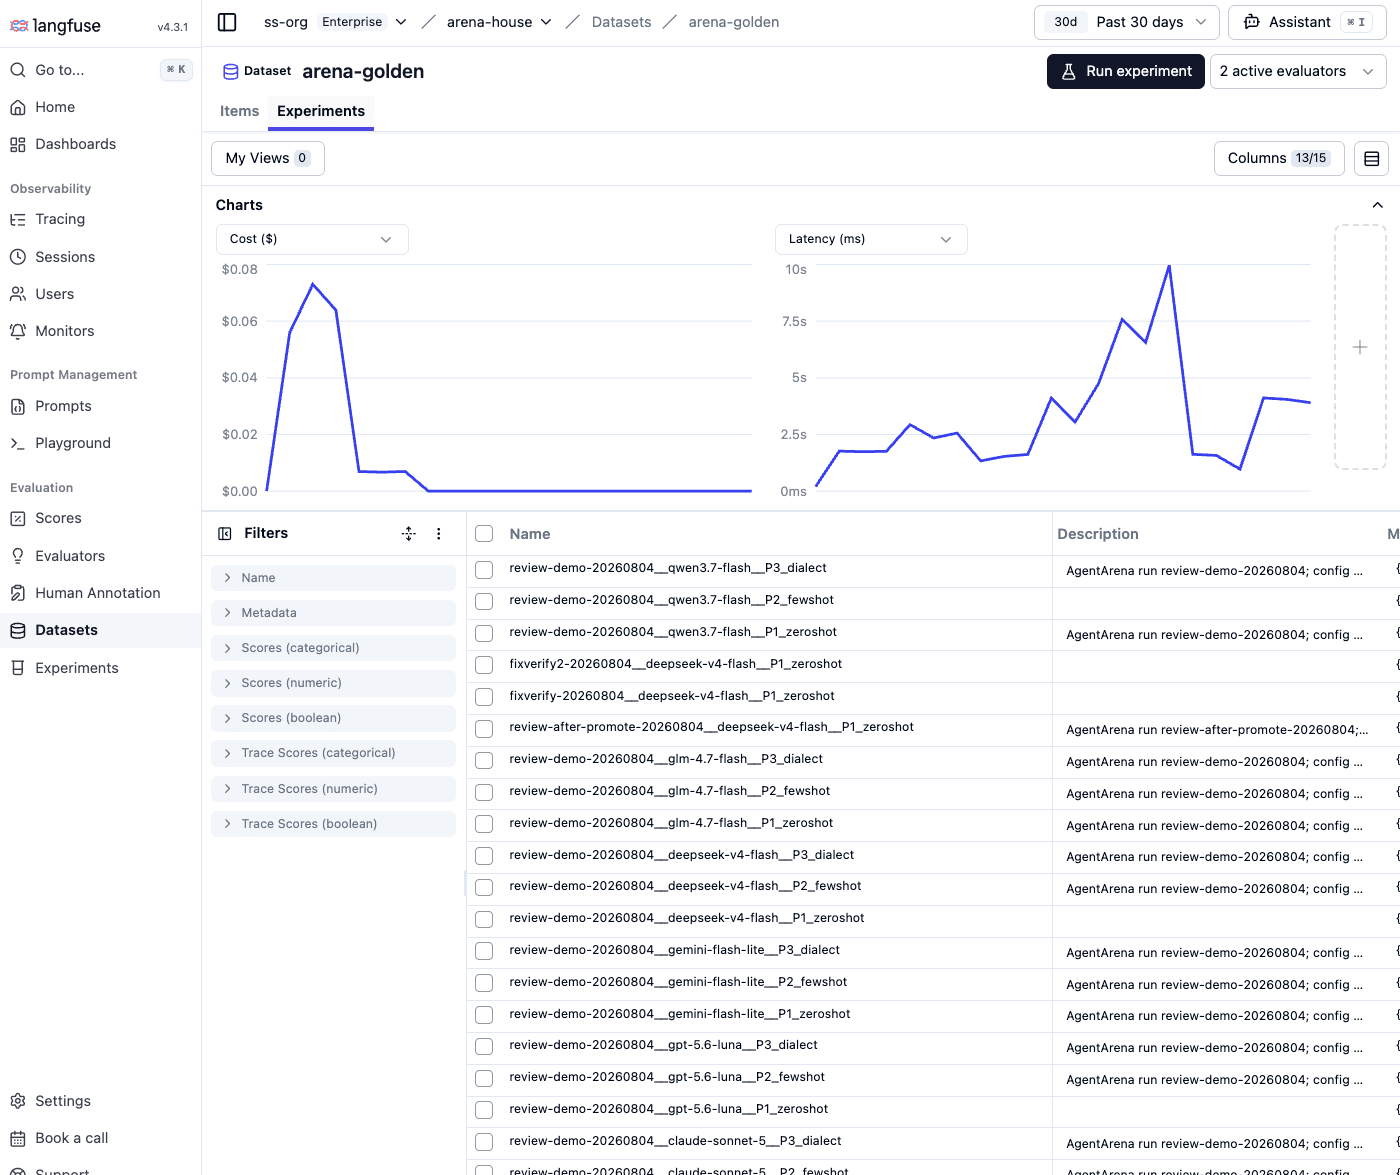
Tab Experiments arena-golden di Langfuse memuat satu Dataset Run untuk setiap konfigurasi
model × prompt. Chart-nya meringkas cost dan latensi pada pertanyaan golden yang sama,
sehingga setiap baris bisa dibandingkan langsung.
Baris teratas adalah pemenangmu: catat config_id-nya. Modul 02
menggali sedalam apa persisnya kualitasnya, bukan sekadar bahwa dia menang.
Cara memastikan kamu sudah selesai
- Tabel Leaderboard memperlihatkan setidaknya satu baris
model × promptdengan nilai cost-per-correct-answer (tidak kosong). - Mengklik baris sebuah config memperlihatkan hasil per pertanyaan, dan mengklik satu pertanyaan membuka trace Langfuse-nya dengan SQL yang dihasilkan terlihat.
- Kamu bisa menyebut
config_id(<model>__<prompt>) yang ditetapkan Arena sebagai pemenang.
Latihan — prediksi, lalu verifikasi
Sebelum kamu benar-benar membuka Leaderboard, buat prediksi dan tulis:
- Dengan hanya melihat daftar model dan tabel prompt di atas (bukan Leaderboard),
tebak config
model × promptmana yang menurutmu akan menang pada cost-per-correct-answer. Tulisconfig_id-nya dan satu kalimat alasannya (misalnya "model termurah dipasangkan dengan prompt dialek, karena sebagian besar kegagalan adalah kesalahan dialek, bukan kesalahan penalaran"). - Sekarang buka Leaderboard dan periksa. Apakah kamu benar?
- Apa pun hasilnya, jawab ini: apakah model yang lebih murah mengalahkan (atau mendekati) model frontier? Kalau ya, selisih itu — murah-dan-hampir-sama-baik mengalahkan mahal-dan-sedikit-lebih-baik — itulah inti pemeringkatan berdasarkan cost-per-correct-answer ketimbang akurasi mentah. Kalau model frontier menang mutlak, catat seberapa jauh ia mengalahkan config termurah berikutnya — margin itulah yang akan membenarkan harganya dalam keputusan deployment nyata.
Penutup
Sekarang kamu punya bukti, bukan tebakan, tentang model dan strategi prompt mana yang layak
dijalankan — diperingkat berdasarkan cost per correct answer dan didukung trace Langfuse untuk setiap
run. Catat config_id pemenangmu; kamu akan memakainya di setiap modul mulai dari sini.
Kondisi akhir
Leaderboard yang terperingkat dan satu config_id yang ditetapkan. Lanjut ke
02 Ukur kualitas untuk melihat sebaik apa pemenang itu sebenarnya.