01 기본 모델 선택
Arena — model × prompt 그리드를 Langfuse experiments로 실행하고 정답당 비용으로 승자를 뽑습니다.
시작 지점
Module 00 완료: .env를 source했고, arena 데이터베이스가 시딩되었고, Langfuse가 연결되었고,
로컬 대시보드가 http://localhost:5174에서 접근 가능하며 Leaderboard 탭은 비어 있습니다.
왜 이것이 토대가 되는 결정인가
이것이 워크숍 전체가 중심에 두고 있는 결정입니다. 제대로 된 에이전트를 출시하기 전에 토대가 되는 질문에 답해야 합니다. 어떤 모델이 이것을 구동해야 하는가? 모델은 성능과 가격 모두에서 엄청난 차이가 있고, 최선의 선택은 남이 다른 워크로드로 돌린 공개 리더보드가 아니라 여러분의 구체적인 작업에 달려 있습니다. 추측은 양방향 모두에서 비용이 큽니다. 필요하지 않은 프런티어 모델에 과다 지출하거나, 실제 질문을 조용히 틀리는 저렴한 모델을 출시하는 것입니다.
그래서 추측하는 대신 경쟁을 돌립니다. 바로 Arena입니다. 모델과 프롬프트 전략의 그리드가 모두 같은 골든 질문에 답하고, Langfuse가 모든 답을 experiment로 채점하며, 승자를 결정하는 지표는 원시 정확도가 아니라 정답당 비용 — 여러분의 유스케이스에 대한 비용당 품질 — 입니다. 구체적으로 이 모듈은 다음 질문에 근거로 답합니다. 모델과 프롬프트 전략의 그리드 중에서 어떤 구성이 1달러당 가장 많은 정답을 얻는가? "정답"은 실행 정확도를 의미합니다. 생성된 SQL이 그럴듯해 보이는 데 그치지 않고, 골든 SQL과 동일한 결과 집합을 반환하는 것입니다. 채점은 하네스 내부가 아니라 Langfuse 안에서 일어납니다. Langfuse가 평가자를 호스팅하고 모든 Experiment Item, 점수, 트레이스를 보관합니다. 로컬 리더보드는 Langfuse Public API를 통해 그 기록을 읽습니다. 이 모듈 이후의 모든 것(측정, 개선, 릴리스)은 여러분이 이 선택을 근거에 기반해 내렸다고 전제합니다.
개념 — 내부 동작
이 평가를 위한 Langfuse의 데이터 모델. 저장소의 원본 코퍼스에는 YAML 질문이 20개 있습니다.
q019와 q020은 few-shot 프롬프트용 holdout이므로, 깨끗한 프로젝트에 시딩된 Dataset(arena-golden)에는
Experiment용 질문이 18개 있습니다. 여러분이 실행하는 모든 model × prompt 구성은 같은 18개 항목을
대상으로 하는 하나의 Experiment — Langfuse Dataset Run — 이므로, 모든 구성이 정확히 같은
질문으로 채점됩니다. Step 1에서 설정하는 평가자 정의는 correctness와 llm_judge이고, 이들이 내보내는
Experiment 점수는 correctness와 agent-arena-llm-judge입니다. 하나의 데이터셋, 여러 experiment, experiment마다 항목당
하나의 점수 — 이것이 Leaderboard가 구성들을 동일 조건으로 비교할 수 있게 하는 구조입니다.
모든 model × prompt 구성은 arena-golden 데이터셋을 대상으로 하나의 Experiment(Dataset Run)로 실행되며, 각 experiment는 모든 데이터셋 항목에 두 개의 점수를 붙입니다. correctness (0/1)와 agent-arena-llm-judge (0..1)입니다.
프롬프트 전략도 참가자입니다. 그리드는 모델만이 아니라 model × prompt입니다. 누구에게 묻는지만큼
어떻게 묻는지도 중요하기 때문입니다. config.yaml과 agents/prompts.py에서 가져오면 다음과 같습니다.
| 프롬프트 | 하는 일 | NL→SQL에 도움이 될 수 있는 이유 |
|---|---|---|
P1_zeroshot | 스키마와 질문만 주고, 펜스로 감싼 SQL 블록 하나를 반환하게 합니다. 기준선입니다. | 호출당 비용이 가장 저렴하고, 아무 도움 없이 모델이 할 수 있는 것을 측정합니다. |
P2_fewshot | P1에 잘 만들어진 NL→SQL 예시 2개를 더합니다(테스트 세트에서 제외된 것). | 모델이 답을 쓰기 전에 "좋은" 답이 어떤 형태인지 보여줍니다. |
P3_dialect | P1에 ClickHouse 방언 치트시트(날짜 함수, uniqExact, argMax, INTERVAL, ILIKE 금지, …)를 더합니다. | 가장 흔한 실패 유형을 고칩니다. 유창하지만 유효한 ClickHouse SQL이 아닌 경우입니다. |
로스터: 독점 모델 대 오픈 웨이트. 여섯 참가자는 모델 이름만큼 중요한 두 번째 축을 따라 정확히 반으로 갈립니다. 가중치가 닫혀 있는지(호출만 할 수 있는 벤더 API), 아니면 열려 있는지(직접 호스팅하거나 파인튜닝하거나 온전히 자체 데이터 경계 안에 둘 수 있는 모델)입니다. 오픈 웨이트 모델은 토큰당 비용이 훨씬 저렴한 경우가 많고, 독점 프런티어 모델은 원시 성능에서 앞설 수 있습니다. 하지만 "있을 수 있다"가 바로 이 Arena가 가정이 아니라 여러분의 작업에 대해 검증하려는 지점입니다. 두 진영을 같은 골든 데이터셋으로 돌려 보면, 정답당 비용이 프런티어 모델에 실제로 돈을 써야 하는지, 아니면 저렴한 오픈 웨이트 모델이 그 일부 가격으로 목표에 도달하는지 알려줍니다. 아래 로스터는 의도적으로 저비용입니다. NL→SQL은 충분히 단순한 작업이라, 여기서 가장 비싼 참가자도 프런티어가 아닌 중간 등급 모델입니다.
| 모델 | 벤더 | 오픈 / 독점 | 참고용 대체 단가 ($/1M in · out) |
|---|---|---|---|
claude-sonnet-5 | Anthropic | Proprietary | $2.00 · $10.00 |
gpt-5.6-luna | OpenAI | Proprietary | $0.50 · $3.00 |
gemini-flash-lite | Proprietary | $0.30 · $2.50 | |
deepseek-v4-flash | DeepSeek | Open-weight | $0.14 · $0.28 |
qwen3.7-flash | Qwen | Open-weight | $0.03 · $0.13 |
glm-4.7-flash | Z.ai | Open-weight | $0.06 · $0.40 |
왜 정답당 비용이고, 왜 실행 정확도인가. "정답"은 실행 정확도로 판정합니다. 생성된 SQL을 실행했을 때 골든 SQL과 같은 결과 집합이 나오는가입니다. 그것이 정직한 신호입니다. SQL이 골든 쿼리와 글자 단위로 다른지는 상관하지 않고, 질문에 제대로 답했는지만 봅니다. 그러면 대표 순위 지표는 다음이 됩니다.
cost_per_correct_answer = total cost of the run ($) / number of correct answers이 지표는 거의 비슷한 정확도에 훨씬 저렴한 모델을, 조금 더 나은 대신 훨씬 비싼 프런티어 모델보다 높게 평가합니다. 비용에 민감한 실제 팀이 실제로 최적화할 지표입니다.
목표
최소 몇 개의 model × prompt 구성이 정답당 비용으로 순위 매겨진 Leaderboard, 각 순위마다 파고들 수
있는 Langfuse 트레이스, 그리고 승자로 뽑힌 하나의 config_id.
Step 1 — Langfuse 평가자 설정 (일회성)
저장소의 eval/langfuse_evaluators/README.md를 따라 한 번만 수행하세요. 먼저 arena-golden을
시딩하고 OpenRouter 기반 judge를 API로 구성합니다.
python -m scripts.provision_langfuse_evaluators그다음 Langfuse UI에서 결정론적 코드 평가자를 구성하세요.
- 코드 평가자
correctness— Evaluators → Set up Evaluator → Code →eval/langfuse_evaluators/correctness_evaluator.py를 붙여 넣기 → Target: Experiments → dataset =arena-golden필터. 이 평가자는 에이전트의 결과 집합(트레이스에서)을 골든 결과 집합(데이터셋 항목의expected_output)과 비교해 실행 정확도correctness점수(0/1)와outcome카테고리를 산출합니다. 네트워크 송신이 없습니다. SQL은 이미 에이전트 안에서 실행되었고, 평가자는 결과 집합만 비교합니다. - 평가자 정의
llm_judge의 수동 대체 경로 — Evaluators → Set up Evaluator → LLM-as-a-judge → Custom →eval/langfuse_evaluators/llm_judge_prompt.md의 system/eval 프롬프트와 변수 매핑 사용 → Target: Experiments, datasetarena-golden→ 숫자 점수agent-arena-llm-judge를 내보냅니다. 평가자 정의와 출력 점수의 이름은 의도적으로 다릅니다. 이는 주된 correctness 점수 위에 얹히는 SQL 품질 평가의 보조 신호이며, Module 02에서 활용합니다.
헬퍼가 권장 경로이고, 수동 judge 단계는 대체 수단일 뿐입니다. 결정론적 correctness 코드 평가자는
여전히 일회성 UI 작업으로 남아 있습니다.
Step 2 — 경쟁 실행
source .env && python -m eval.harness --run-id demo무엇이 보여야 하나. 하네스는 먼저 요약 줄(run_id=demo configs=6x3 ...)을 출력하고, 이후 질문이
실행될 때마다 한 줄씩 출력합니다. 예:
claude-sonnet-5__P1_zeroshot q001 pending 812ms $0.00021모든 행은 pending으로 시작합니다. SQL은 실행되고 결과 집합이 트레이스에 기록되었지만, Langfuse
평가자가 아직 채점하지 않았다는 뜻입니다. 모든 구성이 실행을 마치면 하네스는 대기 모드로 바뀌어
grading via Langfuse evaluators — waiting on N traces...를 출력하고, correctness/agent-arena-llm-judge 점수가 도착하는 동안 카운트다운을 보여주며,
Langfuse scored all N traces; leaderboard ready로 끝납니다. 이 pending →
scored 전환이 하네스가 채점을 Langfuse에 넘기는 지점이며, 결과와 판정은 리더보드의 단일 진실
공급원으로 거기에 함께 남습니다.
이 명령은 전체 model × prompt 그리드(config.yaml의 모든 모델 × P1_zeroshot부터
P3_dialect까지의 모든 프롬프트 전략)를 arena-golden 데이터셋에 대한 Langfuse **Dataset Runs
(Experiments)**로 실행합니다. 하네스는 모든 항목에 정확한 correctness와 agent-arena-llm-judge 점수가 붙을 때까지
기다립니다. 정확한 OpenRouter 비용과 종단 간 지연 시간은 같은 Experiment Item에 저장됩니다.
하나의 구성은 <model>__<prompt> 형태입니다. 예: claude-sonnet-5__P1_zeroshot. 사용 가능한 이름은
config.yaml에서 그대로 옵니다.
- 모델: 위 로스터 표의 여섯 참가자 — 독점 세 개
(
claude-sonnet-5,gpt-5.6-luna,gemini-flash-lite) 와 오픈 웨이트 세 개(deepseek-v4-flash,qwen3.7-flash,glm-4.7-flash) - 프롬프트:
P1_zeroshot,P2_fewshot,P3_dialect
유용한 플래그:
--models qwen3.7-flash,gpt-5.6-luna/--prompts P1_zeroshot,P3_dialect— 전체를 돌리는 대신 그리드를 CSV 부분집합으로 제한합니다.--run-id <name>— 실행에 태그를 붙여 Leaderboard와 Langfuse의 Experiments 뷰에서 찾기 쉽게 합니다.
SDK는 데이터셋 항목을 역순이나 동시에 처리할 수 있습니다. q001, q002, ... 순서로 출력되기를
기대하지 말고 각 줄의 질문 ID를 사용하세요. 18개 구성 전체 그리드는 보통 35~45분이 걸립니다. 워크숍은
모델 두 개, 프롬프트 하나의 부분집합으로 시작하고, 일정과 프로바이더 한도가 허용할 때만 전체 그리드를
실행하세요.
Langfuse 평가자는 필수입니다. Langfuse가 이제 단일 평가 저장소이므로, 로컬 채점이나
ClickHouse 결과 기반의 대체 경로는 없습니다. 하네스가 점수를 기다리다 타임아웃되면 Step 1의 평가자
설정을 고치고 새로운 --run-id로 다시 실행하세요.
Step 3 — 승자 뽑기
http://localhost:5174 → Leaderboard를 여세요. 모든 model × prompt 구성이 대표 지표인
정답당 비용으로 순위 매겨져 있습니다. 비용 × 정확도 차트와 "best value" 순위가 표 위에 있습니다.
비용은 실시간 OpenRouter 가격으로 계산됩니다. 하네스는 각 실행 시작 시 OpenRouter의 /models
엔드포인트에서 모델 가격을 갱신하므로, 정답당 비용은 config.yaml에 박혀 있는 낡은 숫자가 아니라
오늘 실제로 드는 비용을 반영합니다.
읽는 방법. 정렬 순서는 정답당 비용 오름차순입니다. 승자는 정확도가 가장 높은 행이 아니라 맨 위 행입니다. 비용 × 정확도 차트에서 정확도 축으로는 비싼 모델 근처에 있는 저렴한 모델을 찾아보세요. 비용의 일부만으로 만들어낸 그 격차가, 단순 정확도 리더보드 대신 이 지표가 존재하는 이유 그 자체입니다.
함정 — 가장 높은 정확도 ≠ 승자. 정확도 열만 훑어보고 최고 득점자가 이겼다고 짐작하기 쉽습니다.
Arena는 정답당 비용으로 순위를 매기므로, 정확도가 약간 낮지만 훨씬 저렴한 구성이 더 비싸고 약간 더
정확한 구성을 앞지를 수 있고 실제로 자주 그렇습니다. 정확도만 보지 말고 $/correct 열을 확인하세요.
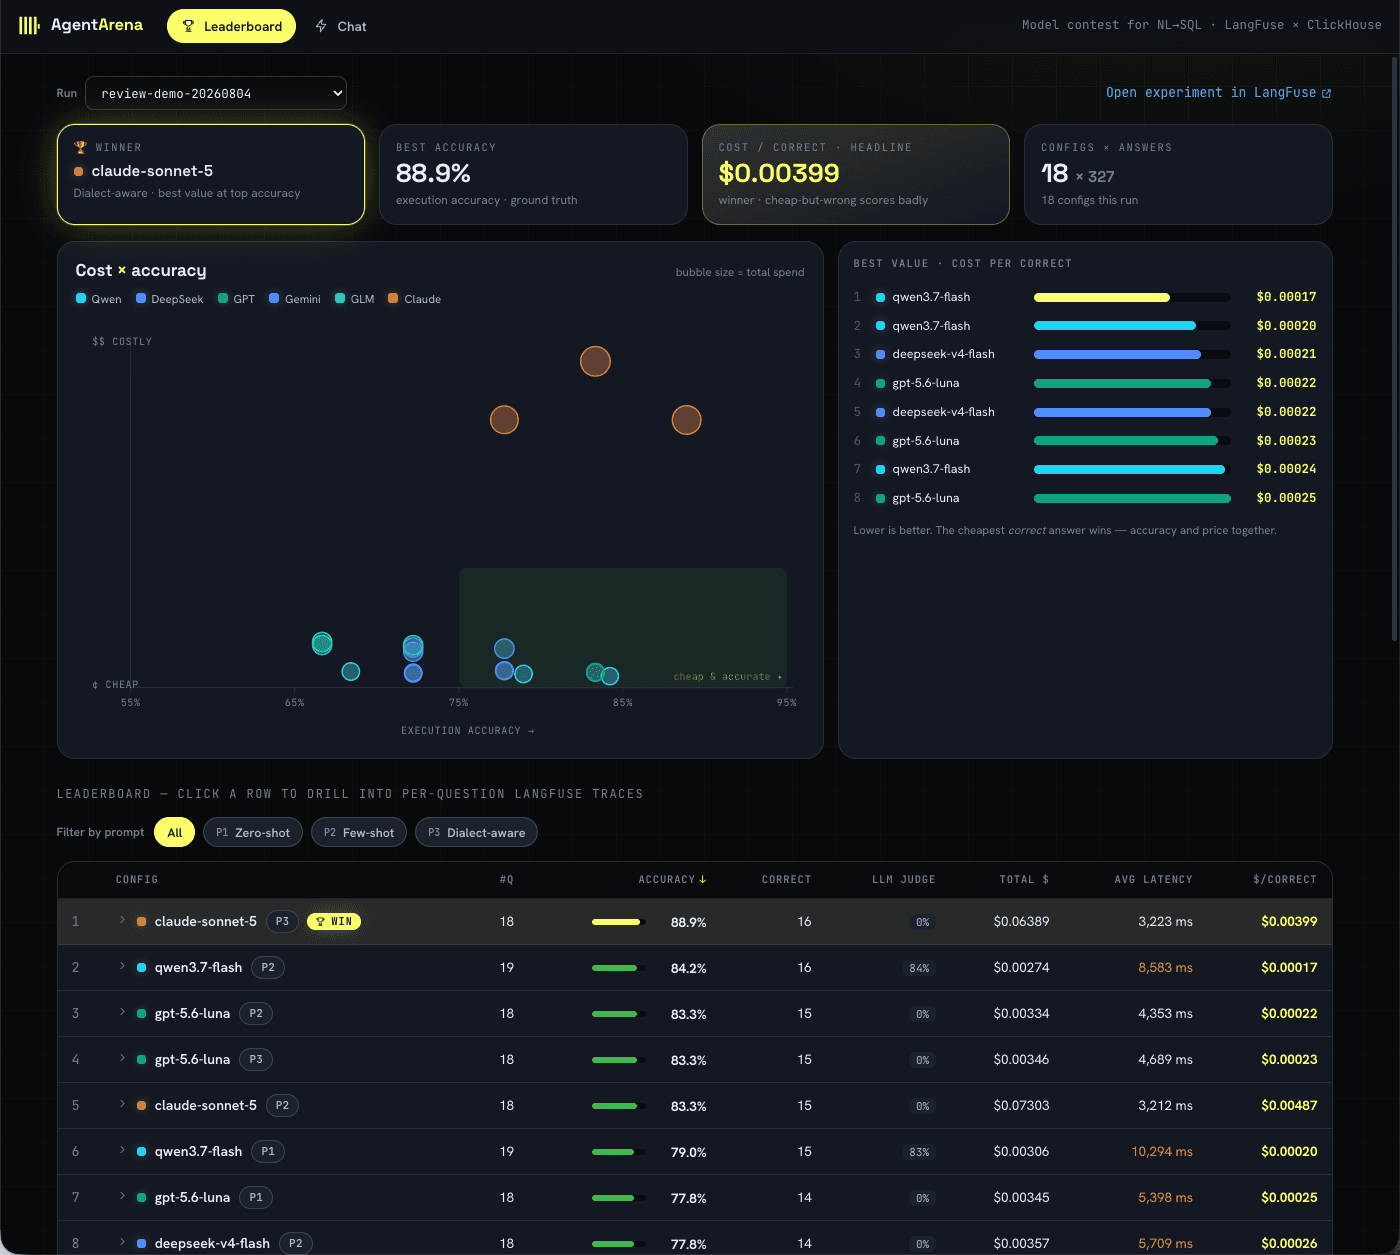
Leaderboard는 품질과 가격을 나란히 보여줍니다. 비용 × 정확도 차트는 트레이드오프를 시각적으로
드러내고, best-value 목록과 $/correct 열은 어떤 구성이 지출을 정답으로 가장 효율적으로
바꾸는지 보여줍니다.
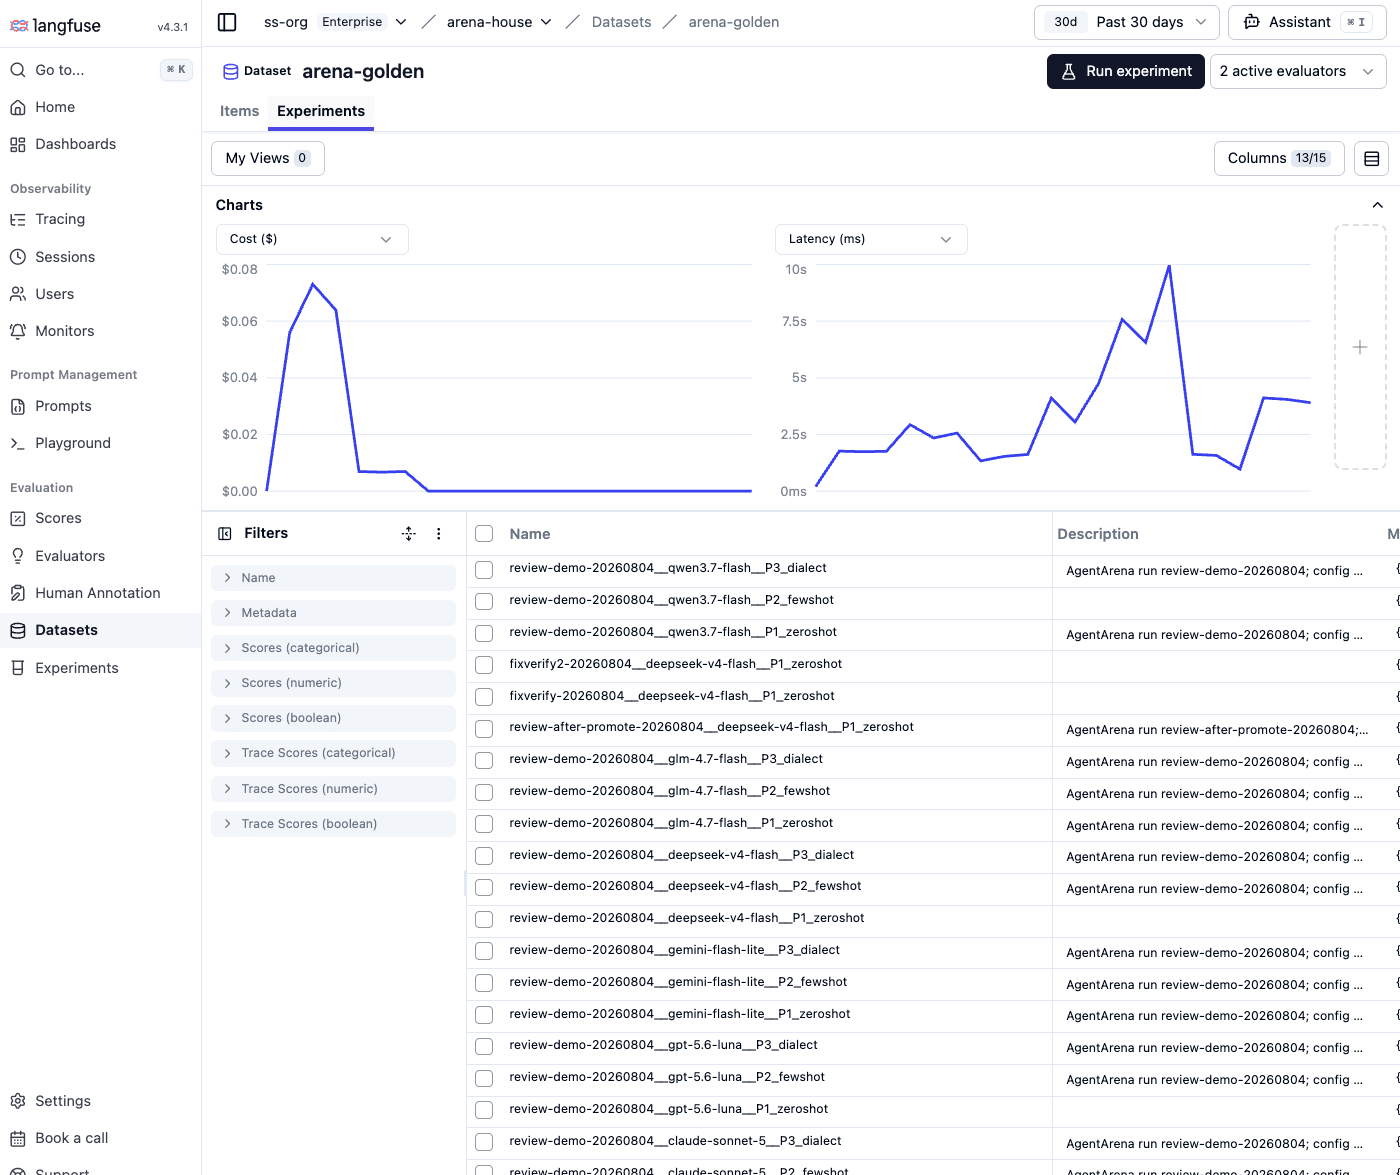
Langfuse의 arena-golden Experiments 탭에는 모든 model ×
prompt 구성마다 하나의 Dataset Run이 있습니다. 차트는 같은 골든 질문들에 대한 비용과 지연 시간을
요약하므로 각 행을 직접 비교할 수 있습니다.
맨 위 행이 여러분의 승자입니다. 그 config_id를 적어 두세요.
Module 02는 그것이 이겼다는 사실만이 아니라 정확히 얼마나
좋은지를 깊이 파고듭니다.
완료 확인 방법
- Leaderboard 표에 정답당 비용 값이 있는(비어 있지 않은)
model × prompt행이 최소 하나 있다. - 구성의 행을 클릭하면 질문별 결과가 보이고, 질문을 클릭하면 생성된 SQL이 보이는 Langfuse 트레이스가 열린다.
- Arena가 승자로 뽑은
config_id(<model>__<prompt>)를 말할 수 있다.
실습 — 예측하고 검증하기
Leaderboard를 실제로 열기 전에 예측을 적어 두세요.
- (Leaderboard가 아니라) 위의 모델 목록과 프롬프트 표만 보고, 정답당 비용에서 어떤
model × prompt구성이 이길 것 같은지 추측하세요.config_id와 그 이유 한 문장을 적으세요 (예: "가장 저렴한 모델 + 방언 프롬프트. 대부분의 실패가 추론 실수가 아니라 방언 실수이기 때문"). - 이제 Leaderboard를 열어 확인하세요. 맞았나요?
- 결과가 어떻든 이 질문에 답하세요. 더 저렴한 모델이 프런티어 모델을 이겼거나 비슷한 수준까지 따라왔나요? 그렇다면 그 격차 — 저렴하고 거의 비슷한 것이 비싸고 조금 더 나은 것을 이기는 것 — 이 원시 정확도가 아니라 정답당 비용으로 순위를 매기는 이유 그 자체입니다. 프런티어 모델이 완전히 이겼다면, 그다음으로 저렴한 구성을 얼마나 앞질렀는지 적어 두세요. 그 차이가 실제 배포 결정에서 그 가격을 정당화할 근거입니다.
정리
이제 어떤 모델과 프롬프트 전략을 쓸 만한지에 대해 추측이 아닌 근거를 갖췄습니다. 정답당 비용으로 순위가
매겨지고, 모든 실행이 Langfuse 트레이스로 뒷받침됩니다. 승리한 config_id를 적어 두세요. 이후 모든
모듈에서 사용합니다.
최종 상태
순위가 매겨진 리더보드와 뽑힌 config_id. 그 승자가 실제로 얼마나 좋은지 보려면
02 품질 측정으로 넘어가세요.