01 ベースモデルを選ぶ
Arena — モデル × プロンプトのグリッドを Langfuse experiments として実行し、正答あたりのコストで勝者を決めます。
出発点
Module 00 が完了していること。.env を source 済み、arena データベースをシード済み、Langfuse を接続済み、
そして http://localhost:5174 でローカルダッシュボードに到達でき、Leaderboard タブが空の状態です。
なぜこれが土台となる判断なのか
これはワークショップ全体がその周りに組み立てられている判断です。本格的なエージェントを出荷する前に、 土台となる問いに答えなければなりません。どのモデルでそれを動かすのか。 モデルは能力 も 価格も大きく異なり、最良の選択はあなた固有のタスクによって決まります。誰かが別の ワークロードで走らせた公開リーダーボードによって決まるのではありません。当てずっぽうはどちらの方向にも 高くつきます。必要のないフロンティアモデルに払いすぎるか、安いモデルを出荷して実際の質問を静かに 間違えるかです。
だから当てずっぽうの代わりにコンテストを走らせます。Arena です。 モデルとプロンプト戦略のグリッドが すべて同じゴールデン質問に答え、Langfuse が experiment としてすべての回答を採点し、勝者を決める 指標は素の精度ではなく 正答あたりのコスト — あなたの ユースケースにおける 1 ドルあたりの品質 — です。具体的に、このモジュールはエビデンスをもって次に答えます。モデルとプロンプト戦略のグリッドの うち、1 ドルあたり最も多くの正答を得る構成はどれか。 「正しい」とは実行精度を意味します。生成された SQL がゴールデン SQL と同じ 結果セット を返すことであり、それらしく見えるだけの SQL ではありません。 採点はハーネスの中ではなく Langfuse の 内側 で行われます。Langfuse が evaluator をホストし、すべての Experiment Item、score、trace を保持します。ローカルの leaderboard は Langfuse Public API 経由でそれらの レコードを読みます。このモジュール以降のすべて(測る、改善する、リリースする)は、この選択をエビデンスに 基づいて済ませたことを前提とします。
コンセプト — 内側の仕組み
この評価における Langfuse のデータモデル。 リポジトリのソースコーパスには YAML の質問が
20 個あります。q019 と q020 は few-shot プロンプト用の holdout なので、クリーンなプロジェクトで seed された
Dataset (arena-golden) には Experiment 用の質問が 18 個あります。実行する model × prompt
構成のひとつひとつが 1 つの Experiment — Langfuse の Dataset Run — として同じ 18 アイテムに対して
走るので、どの構成もまったく同じ質問で採点されます。Step 1 でセットアップする evaluator 定義は
correctness と llm_judge で、出力する score は correctness と agent-arena-llm-judge です。1 つの
データセット、多数の experiment、experiment ごと・アイテムごとに 1 つの score — これが Leaderboard で
構成同士を同条件で比較できる理由です。
すべての model × prompt 構成が arena-golden データセットに対して 1 つの Experiment (Dataset Run) として 実行され、各 experiment はすべてのデータセットアイテムに 2 つの score を紐づけます: correctness (0/1) と agent-arena-llm-judge (0..1)。
プロンプト戦略も出場者です。 グリッドはモデルだけではありません。model × prompt です。
どう尋ねるかは誰に尋ねるかと同じくらい重要だからです。config.yaml と agents/prompts.py より:
| プロンプト | 何をするか | NL→SQL に効きうる理由 |
|---|---|---|
P1_zeroshot | スキーマと質問だけを与え、フェンスで囲んだ SQL ブロックを 1 つ返させます。ベースラインです。 | 呼び出しあたり最も安価。助けがゼロのときモデルが何をできるかを測ります。 |
P2_fewshot | P1 に、解いてみせた NL→SQL の例 2 つ(テストセットからは除外)を加えます。 | 「よい」回答の期待される形をモデルに見せてから書かせます。 |
P3_dialect | P1 に ClickHouse の方言チートシート(日付関数、uniqExact、argMax、INTERVAL、ILIKE は使わない、…)を加えます。 | 最もよくある失敗モードを直します。流暢だが妥当な ClickHouse SQL ではない SQL です。 |
ロースター: プロプライエタリ対オープンウェイト。 6 人の出場者は、モデル名と同じくらい重要な 2 つ目の軸で均等に分かれます。重みがクローズド(呼び出すだけのベンダー API)か、オープン(自前で ホストしたり、ファインチューニングしたり、自分のデータ境界の中に完全に留めたりできるモデル)かです。 オープンウェイトモデルはトークンあたりでずっと安いことが多く、一方でプロプライエタリなフロンティア モデルは素の能力で先行しているかもしれません。しかし「かもしれません」こそ、この Arena が あなたの タスクについて仮定するのではなく検証するために作られているものです。両陣営を同じゴールデンデータセットに 通せば、正答あたりのコストが、本当にフロンティアに金を払う必要があるのか、それとも安いオープンウェイト モデルがわずかな費用で同じところまで連れて行ってくれるのかを教えてくれます。以下のロースターは意図的に 低コストです。NL→SQL は、ここで最も高い出場者でもフロンティアではなく中位クラスのモデルで足りるくらい 単純なタスクです。
| モデル | ベンダー | オープン / プロプライエタリ | 参考のフォールバック価格 ($/1M in · out) |
|---|---|---|---|
claude-sonnet-5 | Anthropic | プロプライエタリ | $2.00 · $10.00 |
gpt-5.6-luna | OpenAI | プロプライエタリ | $0.50 · $3.00 |
gemini-flash-lite | プロプライエタリ | $0.30 · $2.50 | |
deepseek-v4-flash | DeepSeek | オープンウェイト | $0.14 · $0.28 |
qwen3.7-flash | Qwen | オープンウェイト | $0.03 · $0.13 |
glm-4.7-flash | Z.ai | オープンウェイト | $0.06 · $0.40 |
なぜ正答あたりのコストなのか、そしてなぜ実行精度なのか。 「正しい」は 実行精度 で決まります。 生成された SQL を実行すると、ゴールデン SQL と同じ 結果セット が得られるか。それが正直なシグナルです。 SQL がゴールデンクエリとバイト単位で違うかどうかは気にせず、質問に正しく答えているかだけを見ます。 そのうえで見出しとなるランキング指標は次のとおりです。
cost_per_correct_answer = total cost of the run ($) / number of correct answersこれは、ほぼ 同じ精度でずっと安いモデルを、わずかに優れているが遥かに高いフロンティアモデルより 高く評価します。コストを意識する実際のチームが本当に最適化する指標です。
ゴール
少なくともいくつかの model × prompt 構成を正答あたりのコストでランク付けした Leaderboard。
どのランキングも掘り下げられる Langfuse の trace に裏付けられており、そして戴冠した勝者:
1 つの config_id。
Step 1 — Langfuse の evaluator をセットアップする(1 回だけ)
これはリポジトリの eval/langfuse_evaluators/README.md に従って 1 度だけ行います。まず
arena-golden をシードし、OpenRouter を裏で使う judge を API 経由で設定します。
python -m scripts.provision_langfuse_evaluators次に、決定論的なコード evaluator を Langfuse UI で設定します。
- コード evaluator
correctness— Evaluators → Set up Evaluator → Code →eval/langfuse_evaluators/correctness_evaluator.pyを貼り付け → Target: Experiments → dataset =arena-goldenでフィルタ。この evaluator はエージェントの結果セット (trace から)をゴールデンの結果セット(データセットアイテムのexpected_output)と比較し、 実行精度のcorrectnessscore (0/1) とoutcomeカテゴリを出力します。ネットワークへの 送信はありません。SQL はすでにエージェントの中で実行済みで、evaluator は結果セットを比較するだけです。 - evaluator 定義
llm_judgeの手動フォールバック — Evaluators → Set up Evaluator → LLM-as-a-judge → Custom →eval/langfuse_evaluators/llm_judge_prompt.mdの system/eval プロンプトと変数 マッピングを使用 → Target: Experiments、dataset はarena-golden→ 数値 scoreagent-arena-llm-judgeを出力します。evaluator 定義と出力 score は 意図的に別名です。これは主となる correctness score の上に乗る、SQL の品質を評価する副次的なシグナルです。 Module 02 で活用します。
ヘルパーが推奨の経路で、手動の judge 設定はフォールバックにすぎません。決定論的な correctness
コード evaluator は今も 1 回だけの UI 作業です。
Step 2 — コンテストを実行する
source .env && python -m eval.harness --run-id demo見えるはずのもの。 ハーネスはまずサマリー行
(run_id=demo configs=6x3 ...) を出力し、続いて実行しながら 1 質問につき 1 行を出力します。例:
claude-sonnet-5__P1_zeroshot q001 pending 812ms $0.00021どの行も pending で始まります。SQL は実行され結果セットは trace に取り込まれましたが、Langfuse の
evaluator がまだ採点していないためです。すべての構成の実行が終わると、ハーネスは待機に切り替わり、
grading via Langfuse evaluators — waiting on N traces... と出力し、correctness/agent-arena-llm-judge の score が
届くにつれてカウントダウンを表示し、Langfuse scored all N traces; leaderboard ready で終わります。
その pending → scored の受け渡しが、ハーネスが採点を Langfuse に引き渡している場面です。結果と判定は
leaderboard の唯一の情報源としてそこに一緒に置かれます。
これは model × prompt のグリッド全体(config.yaml のすべてのモデル × P1_zeroshot から
P3_dialect までのすべてのプロンプト戦略)を、arena-golden データセットに対する Langfuse の
Dataset Runs (Experiments) として実行します。ハーネスは
すべてのアイテムに正確な correctness と agent-arena-llm-judge score が付くまで待ちます。正確な OpenRouter の
コストとエンドツーエンドのレイテンシは同じ Experiment Item に保存されます。
ひとつの構成は <model>__<prompt>、たとえば claude-sonnet-5__P1_zeroshot です。利用できる
名前は config.yaml からそのまま来ています。
- モデル: 上のロースター表にある 6 人の出場者。プロプライエタリが 3 つ
(
claude-sonnet-5、gpt-5.6-luna、gemini-flash-lite)、 オープンウェイトが 3 つ (deepseek-v4-flash、qwen3.7-flash、glm-4.7-flash) - プロンプト:
P1_zeroshot、P2_fewshot、P3_dialect
便利なフラグ:
--models qwen3.7-flash,gpt-5.6-luna/--prompts P1_zeroshot,P3_dialect— すべてを実行する代わりに、グリッドを CSV で指定した部分集合に絞ります。--run-id <name>— run にタグを付け、Leaderboard や Langfuse の Experiments ビューで 見つけやすくします。
SDK はデータセットアイテムを逆順や並行順で処理することがあります。q001、q002、... の出力順を
期待するのではなく、各行の質問 ID を使ってください。18 構成のフルグリッドは通常 35〜45 分かかります。
ワークショップは 2 モデル・1 プロンプトの部分集合から始め、スケジュールとプロバイダーの制限が許すときだけ
フルグリッドを実行してください。
Langfuse の evaluator は必須です。 Langfuse が唯一の評価ストアになったため、ローカル採点や
ClickHouse の結果によるフォールバックはありません。ハーネスが score を待ってタイムアウトした場合は、
Step 1 の evaluator 設定を直し、新しい --run-id を使ってください。
Step 3 — 勝者を戴冠する
http://localhost:5174 → Leaderboard を開きます。すべての model × prompt 構成が
正答あたりのコスト — 見出しの指標 — でランク付けされます。コスト × 精度のチャートと
"best value" のランキングが表の上に並びます。
コストは ライブの OpenRouter 価格 から計算されます。ハーネスは各 run の開始時に OpenRouter の
/models エンドポイントからモデル価格を更新するので、正答あたりのコストは config.yaml に焼き込まれた
古い数値ではなく、そのモデルが今日実際にいくらかかるかを反映します。
読み方。 並び順は正答あたりのコストの昇順です。勝者は最も精度が高い行ではなく 最上位の 行です。 コスト × 精度のチャートで、精度軸上で高価なモデルの近くに座っている安いモデルを探してください。 その差が、わずかなコストで得られるなら、素の精度によるリーダーボードではなくこの指標が存在する 理由そのものです。
落とし穴 — 最高精度 ≠ 勝者。 精度の列を目で追って最高得点が勝つと思い込みたくなります。Arena は
正答あたりのコストでランク付けするので、わずかに精度が低くずっと安い構成が、より高価でわずかに精度の
高い構成を上回ることがあります(そして実際よくあります)。精度だけでなく $/correct の列を
確認してください。
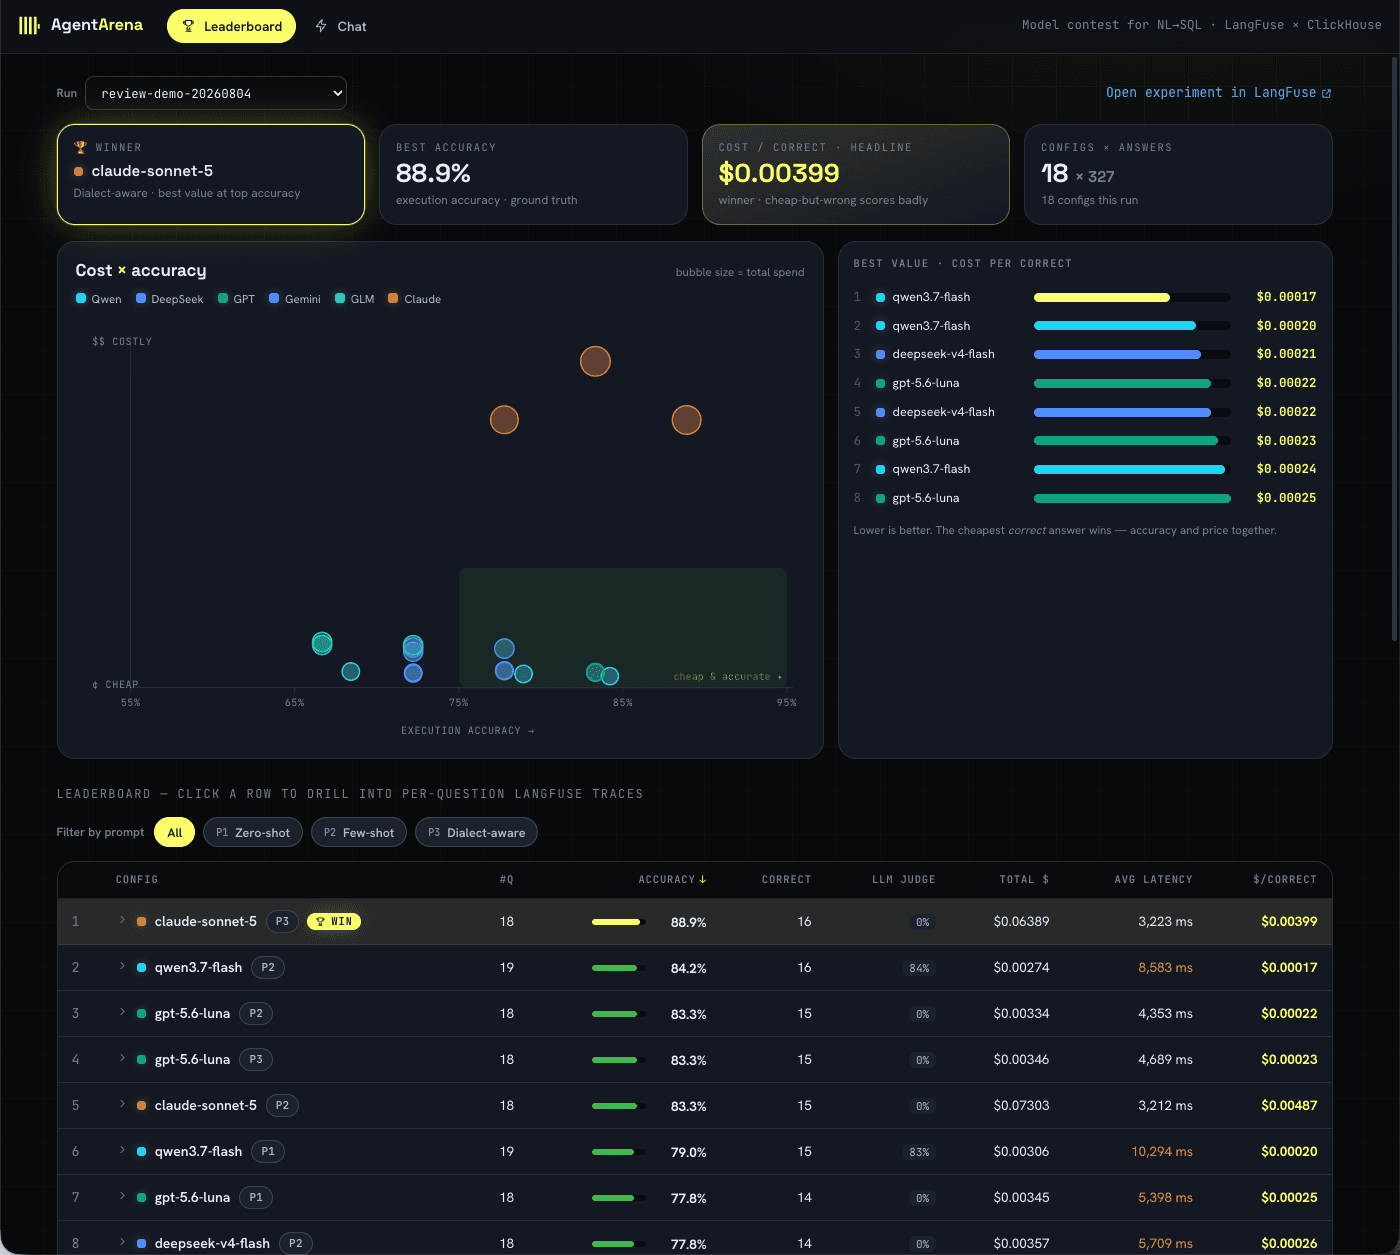
Leaderboard は品質と価格を並べて示します。コスト × 精度のチャートがトレードオフを視覚的に表し、
best-value のリストと $/correct の列が、どの構成が支出を最も効率よく正答に変えているかを
明らかにします。
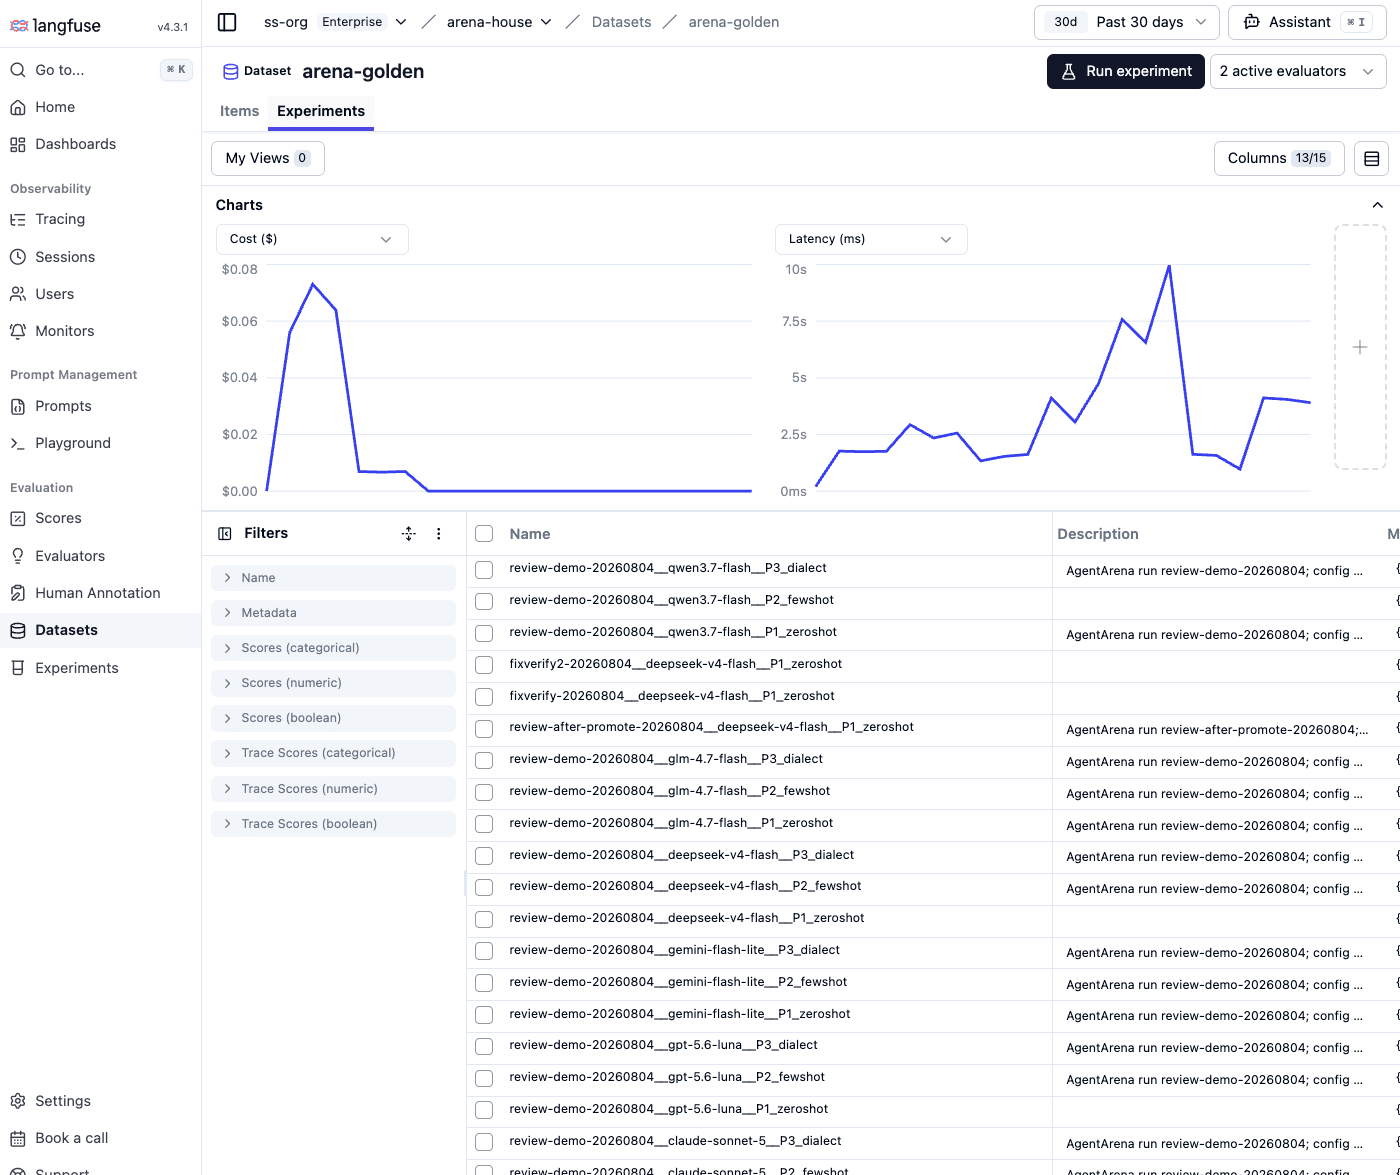
Langfuse の arena-golden の Experiments タブには、すべての model ×
prompt 構成に対する Dataset Run が 1 つずつ入っています。チャートは同じゴールデン質問群にわたるコストと
レイテンシを要約するので、各行はそのまま比較できます。
最上位の行があなたの勝者です。その config_id を書き留めてください。
Module 02 では、勝ったという事実だけでなく、実際にどれだけ良いのかを
深く掘ります。
完了したかどうかの確認
- Leaderboard の表に、正答あたりのコストの値を持つ
model × promptの行が少なくとも 1 つ ある(空ではない)。 - 構成の行をクリックすると質問ごとの結果が表示され、質問をクリックすると生成された SQL が見える Langfuse の trace が開く。
- Arena が勝者として戴冠した
config_id(<model>__<prompt>) を言える。
演習 — 予測してから検証する
本当に Leaderboard を開く前に、予測を立てて書き留めてください。
- 上のモデル一覧とプロンプトの表だけを見て(Leaderboard は見ずに)、正答あたりのコストで
どの
model × prompt構成が勝つと思うか推測してください。config_idと、その理由を 1 文で 書き留めます(例:「失敗の多くは推論のミスではなく方言のミスだから、最も安いモデルと dialect プロンプトの組み合わせ」)。 - では Leaderboard を開いて確認してください。当たっていましたか。
- 結果がどうであれ、これに答えてください。より安いモデルがフロンティアモデルを上回りましたか (あるいは肉薄しましたか)。もしそうなら、その差 — 安くてほぼ同等が、高くてわずかに良いものに勝つ — こそ が、素の精度ではなく正答あたりのコストでランク付けする意味です。フロンティアモデルが 完全に勝ったなら、次に安い構成をどれだけ上回ったかを書き留めてください。その差が、実際の デプロイ判断でその価格を正当化するものになります。
まとめ
どのモデルとプロンプト戦略を走らせる価値があるかについて、当てずっぽうではなくエビデンスを
手にしました。正答あたりのコストでランク付けされ、すべての run について Langfuse の trace に
裏付けられています。勝った config_id を書き留めておいてください。ここから先のすべてのモジュールで使います。
到達状態
ランク付けされた leaderboard と戴冠した config_id。その勝者が実際にどれだけ良いのかを見るため、
02 品質を測る に進んでください。