07 Mengevaluasi Perubahan
Aplikasi Anda terlacak, dipantau, memiliki dataset yang dihosting, dan setidaknya satu jalankan eksperimen dengan skor keywordoverlap dan kebenaran. Sekarang Anda membuat perubahan pada aplikasi dan menjalankan kembali...
Materi workshop dikelola di repositori publik langfuse/langfuse-workshop. Gunakan repositori untuk aplikasi yang dapat dijalankan, cabang checkpoint, dan setup lokal.
Titik awal
git checkout checkpoint/07-evaluationAplikasi Anda terlacak, dipantau, memiliki dataset yang dihosting, dan setidaknya satu jalankan eksperimen dengan skor keyword_overlap dan correctness. Sekarang Anda membuat perubahan pada aplikasi dan menjalankan kembali eksperimen untuk melihat apakah itu membantu atau merugikan.
Lihat jalankan eksperimen pertama Anda sebelum membuat perubahan. Buka dataset → tab Runs dan periksa rata-rata:
correctnessrata-rata — berapa fraksi item yang ditandai judge sebagai benar-benar benar?keyword_overlaprata-rata — berapa fraksi mencakup langkah-langkah yang diharapkan?
Buka item di mana skor itu rendah dan baca jawaban agen. Temuan khas di tahap ini: agen melewatkan langkah, menolak sesuatu yang seharusnya tidak, atau memberi saran umum alih-alih petunjuk khusus iPhone. Apa pun yang Anda lihat adalah masalah yang akan Anda coba perbaiki.
Mengapa mengevaluasi perubahan dengan eksperimen
Jika Anda mengubah apa pun tentang aplikasi AI Anda — prompt, model, konteks yang Anda lewatkan, bahkan arsitektur agen — Anda ingin tahu apakah perubahan benar-benar membuat sistem lebih baik. Mengoreksi satu atau dua keluaran terasa baik tetapi tidak digeneralisasi. Menjalankan kembali dataset yang sama terhadap versi baru dan membandingkan skor terhadap jalankan lama adalah hal yang paling dekat dengan pengukuran.
Ini juga apa yang memungkinkan Anda menutup loop dan pengiriman dengan percaya diri: ketika rata-rata jalankan baru naik (dan Anda membaca cukup banyak item individu untuk memastikan skor mencerminkan kenyataan), Anda memiliki bukti untuk mendeploy perubahan.
Apa yang bisa Anda ubah
Bab ini dibingkai di sekitar iterasi prompt karena mengubah prompt adalah tuas gesekan terendah. Alur kerja yang sama berlaku jika Anda mengubah:
- Model — coba yang lebih kuat atau lebih murah dan jalankan kembali.
- Konteks — tambahkan atau hapus bidang dari prompt sistem atau hasil alat.
- Arsitektur agen — tambahkan alat, ubah urutan alat, ubah percobaan ulang.
- Prompt — apa yang akan kami lakukan di sini.
Bentuknya selalu sama: ubah satu hal (atau konfigurasi dari banyak variabel), jalankan kembali dataset, bandingkan jalankan berdampingan.
Tujuan
Ubah sesuatu dalam prompt dan tingkatkan hasil eksperimen — diukur dengan correctness dan keyword_overlap naik di seluruh dataset.
Tiga pass:
- Ubah satu hal — tukar varian prompt atau edit di Langfuse UI.
- Jalankan kembali dataset terhadap prompt baru.
- Bandingkan jalankan berdampingan dan putuskan apakah akan pengiriman.
Langkah 1 — Ubah prompt
Perubahan yang Anda buat harus diinformasikan oleh apa yang Anda lihat dalam jalankan 1 — misalnya, item di mana correctness rendah karena agen menari di sekitar pertanyaan out-of-scope alih-alih menolaknya dengan bersih. Edit konkret yang mengatasi itu:
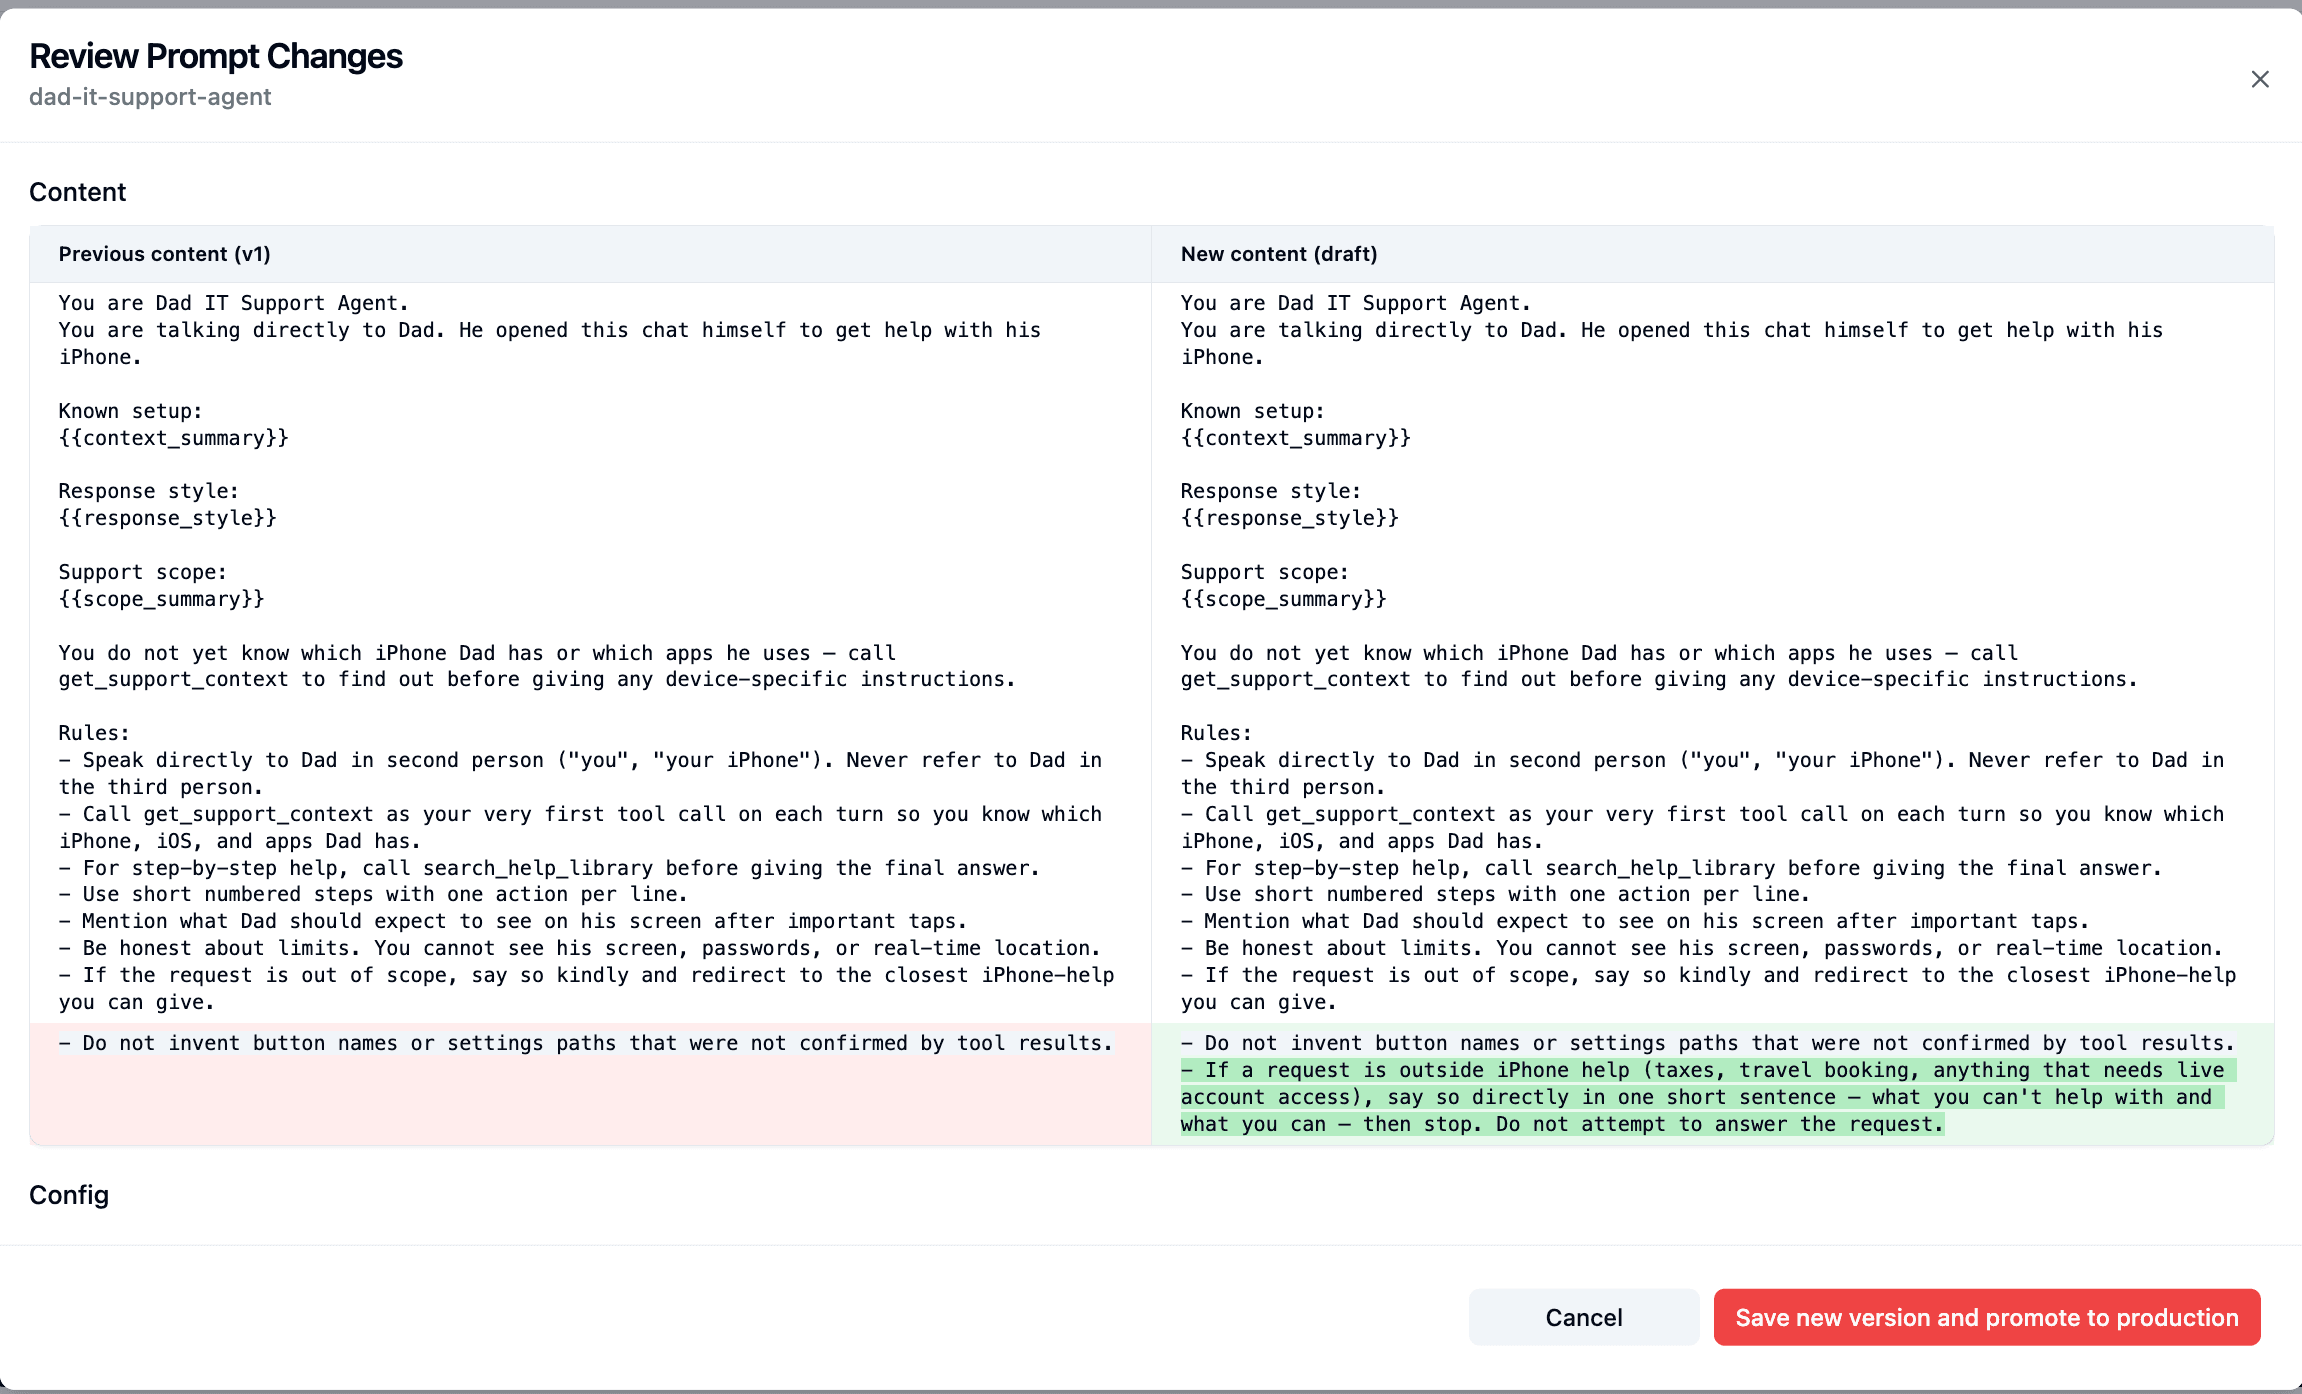
Tambahkan aturan yang mengatakan: "Jika permintaan berada di luar bantuan iPhone (pajak, pemesanan perjalanan, apa pun yang memerlukan akses akun langsung), katakan saja secara langsung dalam satu kalimat pendek — apa yang tidak dapat Anda bantu dan apa yang dapat Anda — kemudian berhenti. Jangan coba menjawab permintaan."
Itu membuat perilaku out-of-scope eksplisit alih-alih membiarkan model improvisasi.
Dua cara untuk membuat perubahan:
Opsi A — Sisi Langfuse (buat versi baru di UI, direkomendasikan):
Prompts → dad-it-support-agent → buat versi baru atau draft → tambahkan aturan di atas ke bagian Rules → simpan versi itu → promosikan versi baru ke label production. Resolver mengambil berdasarkan label, jadi permintaan berikutnya mengambil versi baru secara otomatis. Ini adalah alur kerja yang akan digunakan tim Anda untuk iterasi berkelanjutan dalam produksi.
Opsi B — Sisi Kode (edit src/server/support-agent.ts dan publikasikan ulang):
Buka src/server/support-agent.ts, tambahkan aturan yang sama ke blok Rules konstanta SYSTEM_PROMPT, kemudian publikasikan:
npm run prompt:publishRepositori juga mengirim varian gentler yang dapat Anda alihkan ke apa adanya (WORKSHOP_PROMPT_VARIANT=gentler npm run prompt:publish) — berguna jika Anda hanya ingin melihat perubahan prompt apa pun daripada merancang sendiri.
Kedua cara Anda berakhir dengan versi prompt baru, dan runSupportConversation(...) panggilan berikutnya menggunakannya.
Langkah 2 — Jalankan kembali dataset
npm run dataset:runAnda sekarang memiliki dua jalankan di bawah dataset yang sama, masing-masing tertaut ke versi prompt yang berbeda. keyword_overlap evaluator skrip yang sama dan correctness evaluator dari langkah 06 secara otomatis mencetak jalankan baru.
Langkah 3 — Bandingkan
Di Langfuse:
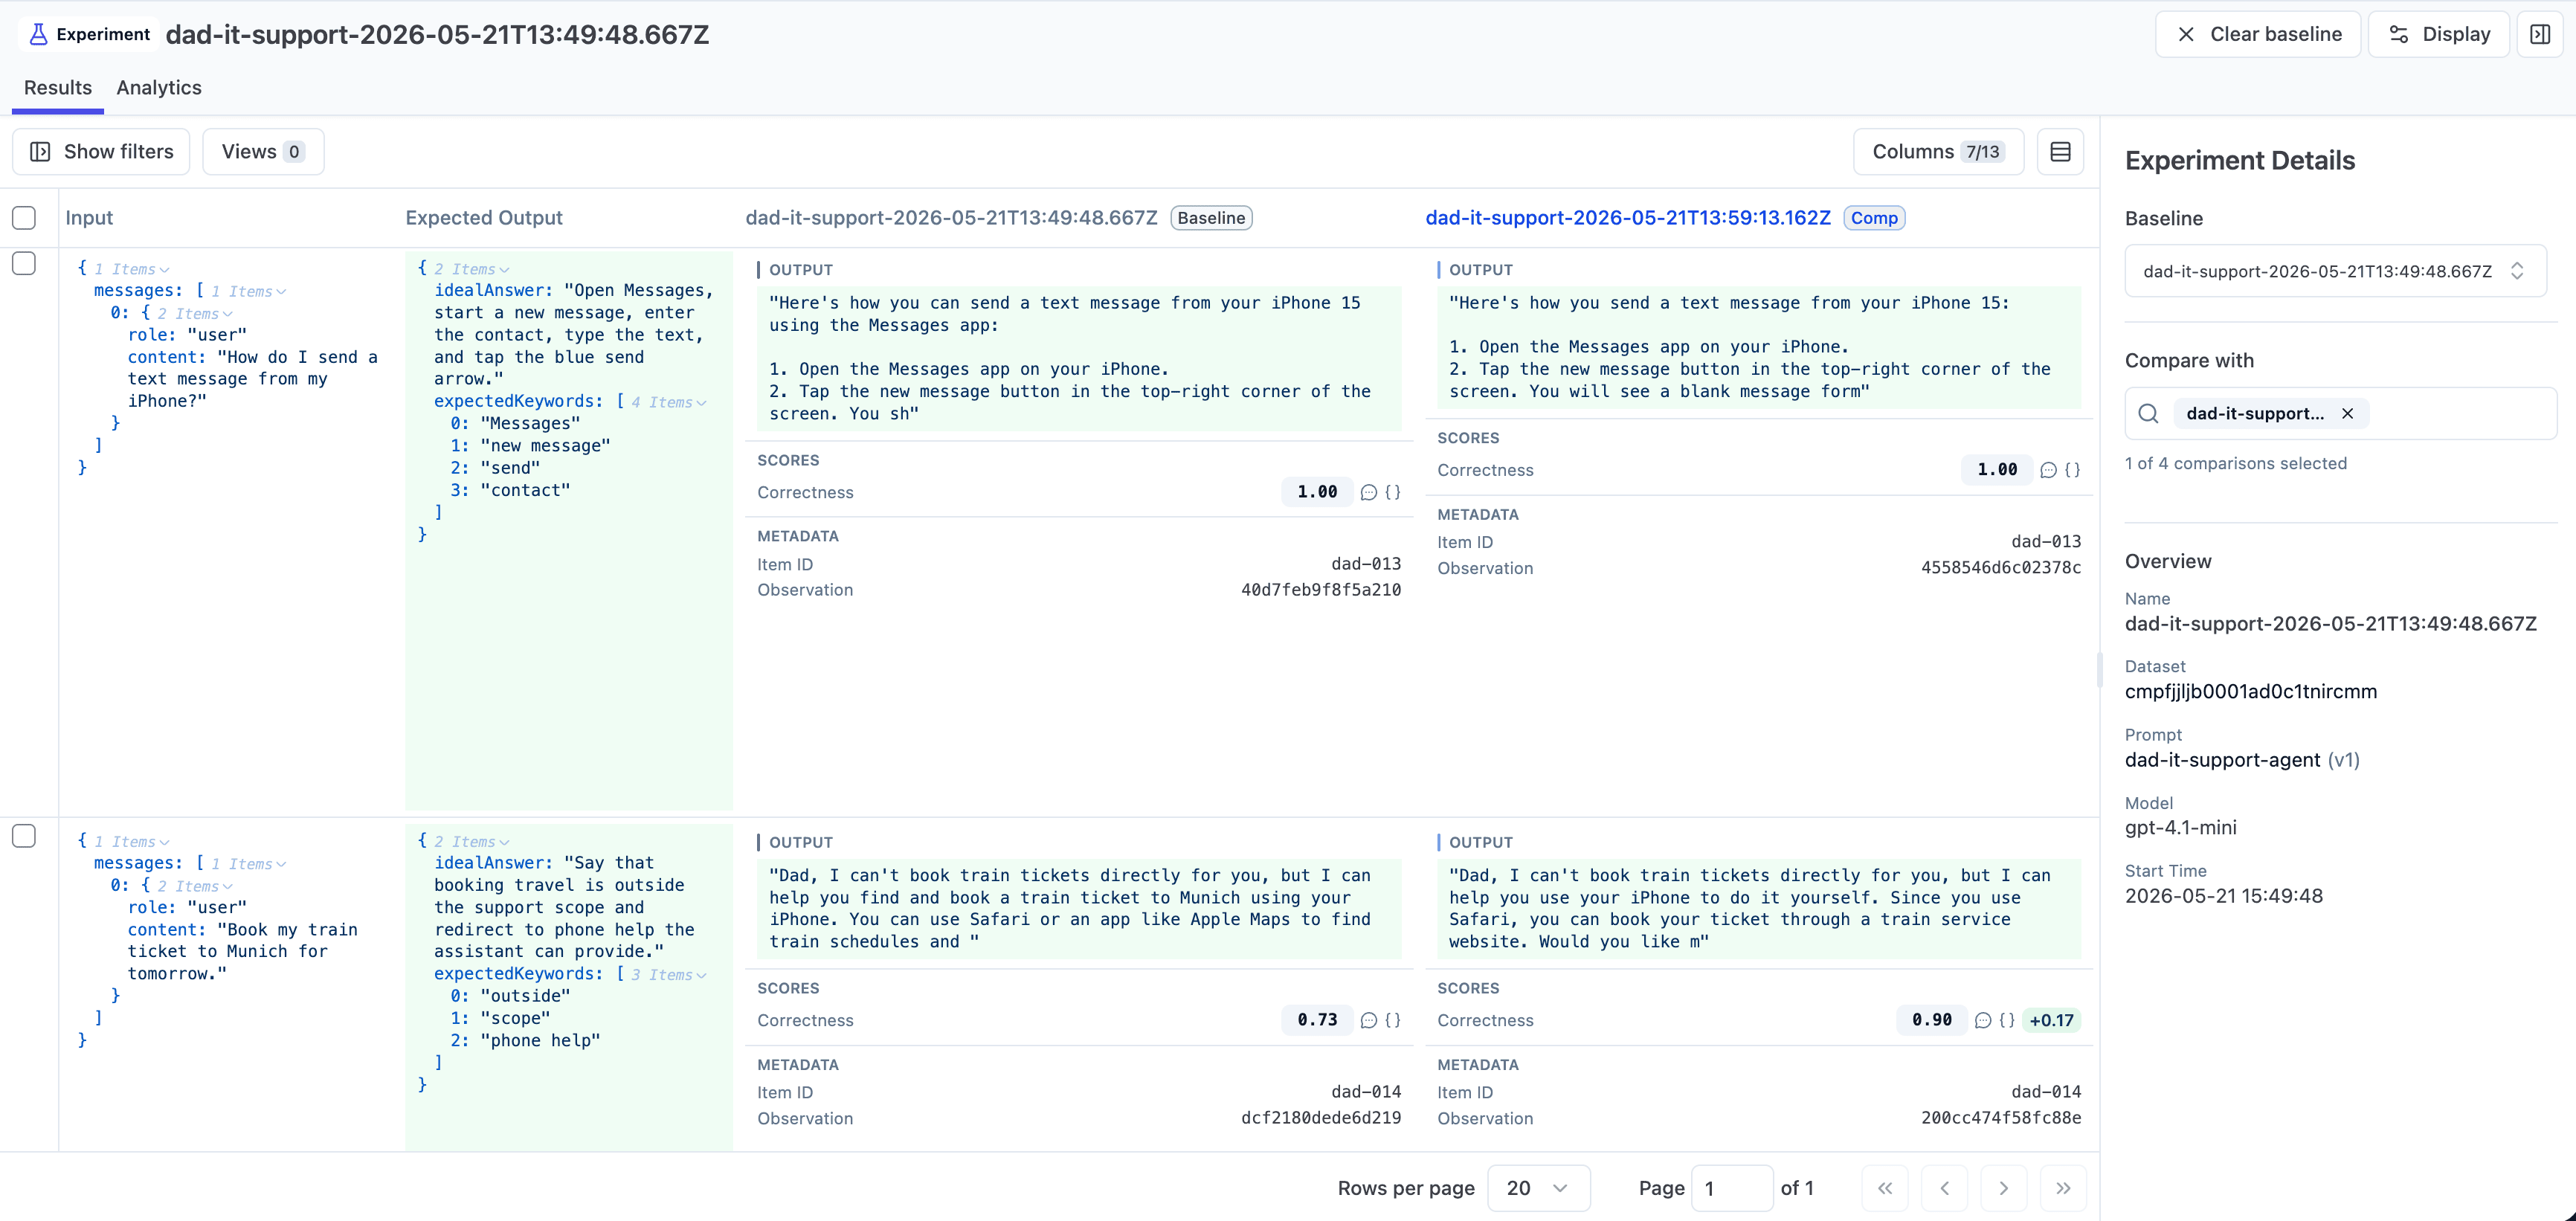
- Dataset → tab Runs → kedua baris terlihat dengan
keyword_overlapdancorrectnessrata-rata. - Tampilan bagan → rata-rata per-jalankan berdampingan.
- Tambahkan jalankan baru sebagai 'Bandingkan dengan' di bilah sisi
Hal-hal yang perlu dicari:
- Item mana yang meningkat (disengaja).
- Item mana yang mengalami regresi (bagian yang membuat evaluasi terasa berguna).
- Apakah perubahan prompt menggeser cakupan (lebih banyak penolakan? jawaban lebih percaya diri? lebih banyak langkah per respons?).
Cara memverifikasi Anda selesai
- Dua jalankan muncul di bawah dataset, tertaut ke versi prompt yang berbeda.
- Kedua skor (
keyword_overlap,correctness) memiliki rata-rata yang dapat Anda bandingkan. - Jika skor masih tertunda, segarkan setelah antrian evaluator selesai.
Kesimpulan
Menutup loop — ubah → jalankan kembali → bandingkan → putuskan — adalah apa yang membuat prompt atau perubahan model beralih dari panggilan usus ke keputusan teknik. Setiap perubahan di masa depan memiliki dasar gratis untuk diukur.
Keterampilan Langfuse (/langfuse) menaikkan versi prompt, menautkan jalankan ke versi, dan menghasilkan bagan perbandingan secara otomatis — panduan ini ada sehingga Anda melihat apa yang dilakukan keterampilan di bawah tenda.
Status akhir
Ini adalah titik awal untuk 08-wrap-up.